
AI 时代了,你的报表查询功能还没升级吗?
AI 时代到来后,数据分析领域很多地方都在被赋能重塑——ChatBI、智能问数、智能报表等概念火热出圈,几乎每个数据产品都在打 AI 牌,但回到真实的业务系统里,有一个高频使用场景似乎被忽视了,那就是固定报表再查询
固定报表占比多,查询任务频次高
固定报表是企业数据系统中占比很大且不可替代的组成部分
无论是销售周报、库存月报,还是管理层的核心指标看板,这些逻辑固定、口径统一、定期更新的报表,承载着企业日常运营中绝大部分的数据输出需求
而在固定报表的使用过程中,对已有报表数据进行再查询和筛选,又是极其常见的场景
比如:
• 物流系统想查“上周发往华北的订单”
• 地铁票务系统想查“6 号线上午 9 点到 12 点的进站刷卡情况”
• 人力资源系统想查“一季度技术部迟到和加班情况”
这些查询要求往往非常灵活,都有大量“换条件看数据”的需求,每一个场景的条件组合都不尽相同
参数模版能用,但在 AI 时代不香了
以前没有 AI 的时候,解决这类需求只能用参数模板:设计好下拉框、日期选择器、输入框等一系列控件,用户通过点选来设置筛选条件
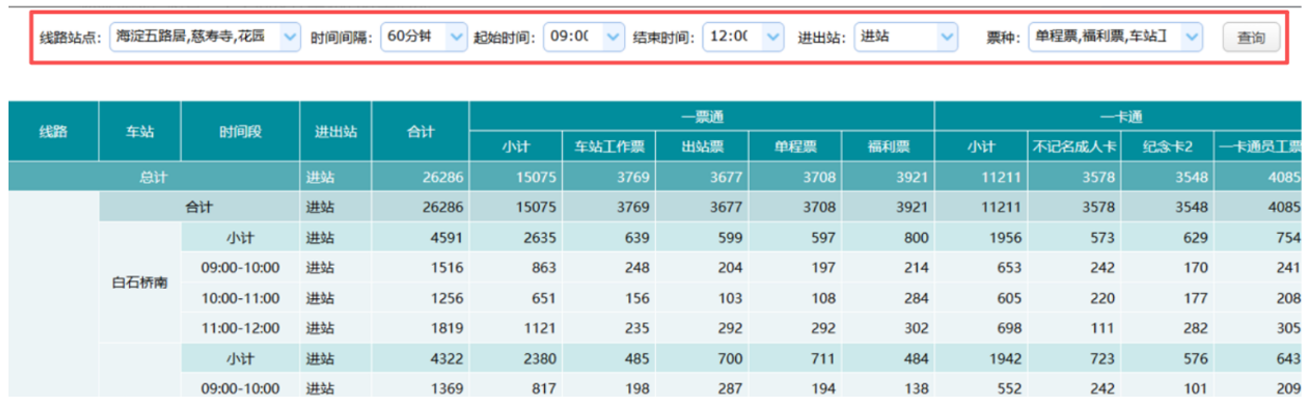
传统参数模板确实能完成这些查询,但问题也很明显:
• 不够灵活:只能按预设控件筛选,超出范围就查不了,只能找开发人员扩充
• 体验臃肿:参数一多,页面上堆满下拉框和输入框,视觉感受和使用体验都不好
• 不够智能:这是最关键的一点,AI 时代,让参数模版瞬间不香了,现在都是对话交互了,说话就能查询,参数模版还得点来点去,有点落伍了
ChatBI 的此查询,非固定报表的彼查询
想要说句话就能查询,那 ChatBI 不就是干这个的吗?
是,但是此查询非彼查询
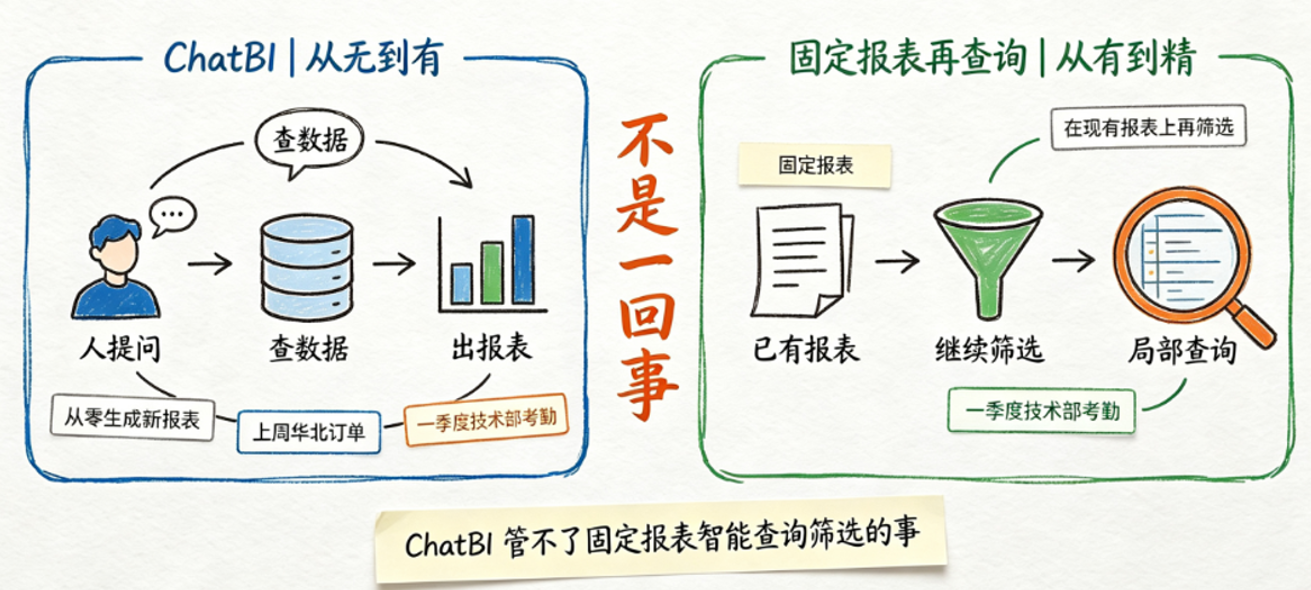
ChatBI 是针对原始数据进行查询,分析,出简单图表的,是从无到有
而固定报表上的查询,解决的是在已有报表上换条件、换口径继续查询筛选的问题,是从有到精
两者是完全不同的业务场景,不是一回事
AI 直接生成 SQL 去查询也不靠谱
ChatBI 管不了,那直接让大模型把自然语言翻译成 SQL,不就可以实现筛选了?看似可行,实则隐患很大,因为LLM 有幻觉问题
主流测评显示,最聪明的大模型在编写 SQL 的任务上也只有不到 70% 的正确率
当然固定报表场景下数据范围已经被限定在已知数据集上,筛选本质上只是生成 WHERE 子句,难度降低了不少,准确率确实会高很多,但在较复杂的情况依旧存在幻觉问题
就算模型正确率做到 90%,剩下 10% 的错误对用户来说依旧不可接受,业务人员很难分辨 SQL 以及数据是否出错,一旦拿错误数据用于汇报决策,会带来严重业务风险
润乾报表给出的新解法:规则引擎为主,AI 为辅
既然 AI 生成 SQL 有不可解决的幻觉困扰,那是否可以不让 AI 生成 SQL 呢
专业厂商润乾报表在这个场景上给出了新思路
润乾报表采用的方案是“规则引擎主导 + LLM 辅助”的新型架构
这套架构的核心思想是:不让大模型直接生成 WHERE 子句,而是让它只做擅长的事——理解自然语言并将其规范化,并加入了人工确认环节;最后 SQL 的生成,交给确定性的规则引擎来完成
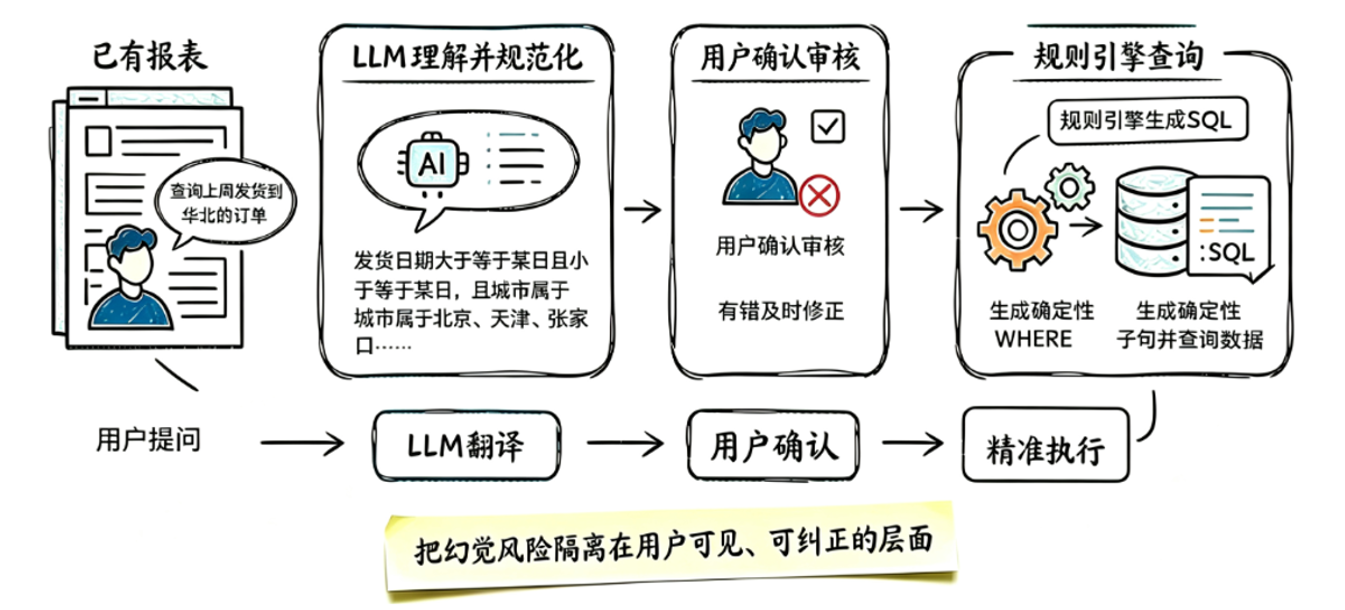
例如用户输入“上周发往华北的订单”,系统可以先将其规范化为“发货日期在 2026-XX-XX 至 2026-XX-XX,且收货地区属于华北”这样的可读条件,业务人员能够直观判断转换是否正确,规则引擎再基于已知数据模型生成准确查询
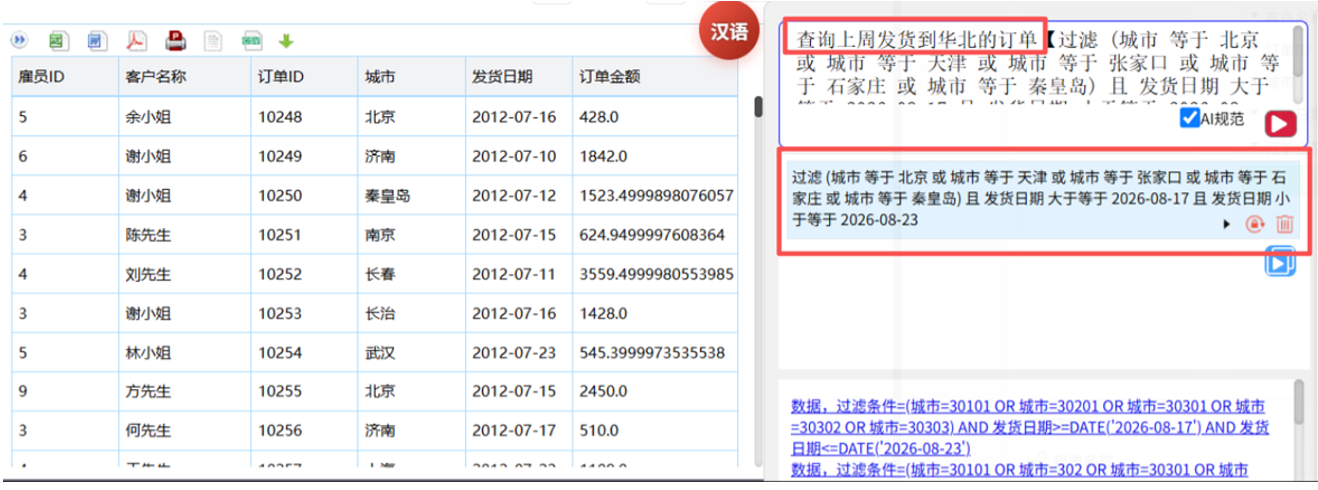
这种架构的好处在于:
• 过程可确认:LLM 翻译规范规后的命令是中文的,用户能读懂,如果有错可以及时纠偏
• 结果可信任:LLM 只负责翻译命令,核心查询由规则引擎完成,既能享受 AI 的灵活自由,又能确保查询结果的准确
• 成本更可控: LLM 只翻译命令,消耗 Token 少,可以部署私有小模型,成本可控;熟练后直接写出规范命令,甚至可以不用 LLM 了
• 安全易实施:整个过程数据不出私域,不会有安全问题;原有报表也不需要推倒重做,只是给老报表增加了 AI 接口,也不需要像 ChatBI 那样准确语义层元数据,实施成本很低
说在最后
给固定报表加上 AI 自然语言查询,也是数据分析 AI 化进程中不可或缺的重要一环
润乾报表的思路很务实——不动现有系统,不改已有报表,以最小的侵入、最低的成本,就能让固定报表瞬间拥有 "说话就能查" 的 AI 能力
更重要的是,润乾报表提供的是全面的 AI 报表能力——从固定报表的智能筛选,到复杂报表的自然语言制作,再到 AI 自助报表,全场景覆盖,而且所有 AI 功能均包含在三万买断随便用的工具版中
让 AI 真正落地,不一定需要大动干戈,润乾报表证明:低成本,也能玩转企业级 AI 数据分析