
人机双向可读的 DSL,是智能问数的生死线
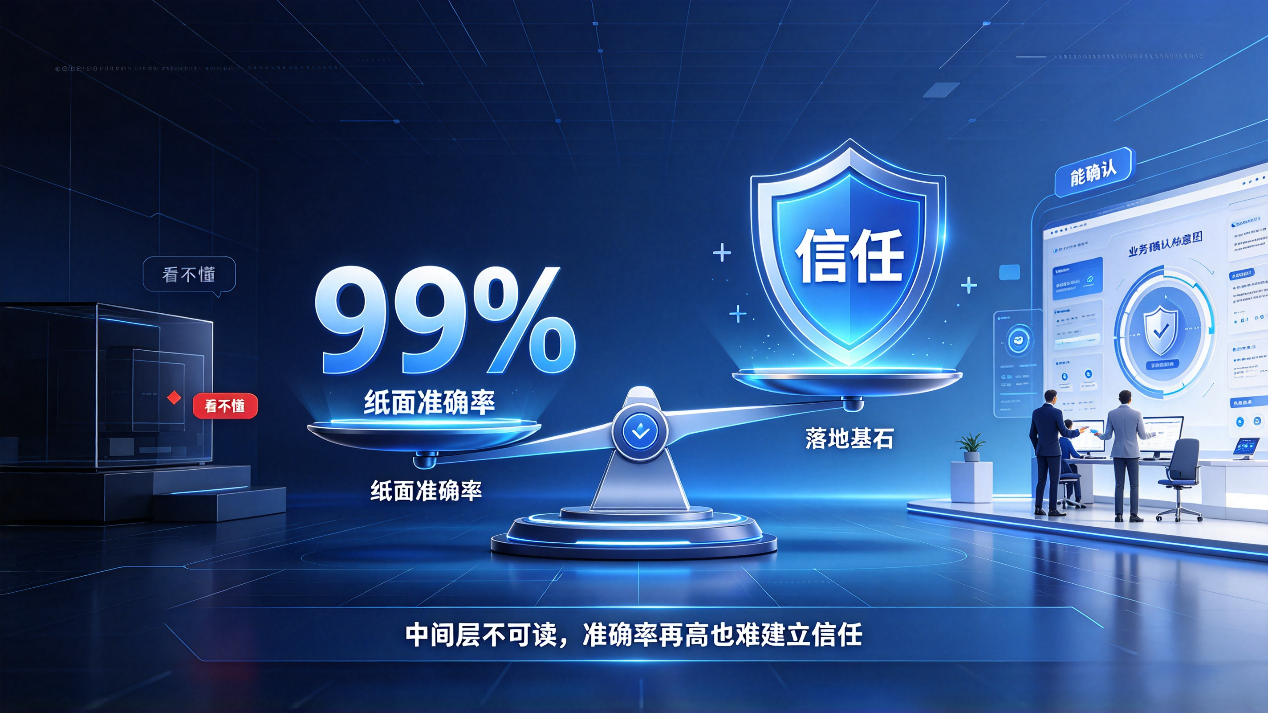
全行业都在卷 Text2SQL 准确率、模型参数与 RAG 增强,却普遍忽略了一个根本问题:业务用户看不懂中间过程,再高的准确率都是黑箱,而黑箱系统永远落不了经营决策的地。
行业普遍借助中间层 DSL 来破局,希望用结构化格式约束输出、减少幻觉。但绝大多数 DSL 都是机器导向的,结构越严谨,人越看不懂。
对业务用户而言,看不懂的中间层等于没有中间层。真正决定智能问数能不能落地的,从来不是测试集上的数字,而是有没有一层人机双向可读的 DSL,人能看懂确认意图,机器能解析确定性执行。这不是体验加分项,是真正的生死线。
机器可读的 DSL,救不了落地信任
目前大多数中间层 DSL 方案会先把自然语言转换成结构化的中间格式,再编译成 SQL 执行。思路是对的,但关键点被忽略了,这些 DSL 只考虑了机器导向。
它们的设计目标是约束 LLM 的输出空间,用严格的格式减少语法错误。但代价是,业务用户面对这些 JSON、XML、自定义 MQL 时,和面对 SQL 没有任何区别:都看不懂,都没法校验。
于是就形成了一个非常尴尬的局面:
测试集上的准确率确实从 75% 提升到了 90%;
但业务用户依然不敢直接用结果,因为他永远不知道这一次是不是刚好落在那 10% 的错误里。
更致命的是,很多错误是语义层面的跑偏,不是语法层面的错误。比如把 “发货城市” 理解成 “客户所在城市”,把 “没开单的客户” 理解成 “订单金额为 0 的客户”,SQL 语法完全正确,结果完全错误。这类错误藏在黑箱里,从代码层面根本查不出来,只有业务人员能识别 —— 但前提是,他能看到系统对意图的表达。
没有用户能看懂的中间层,再高的准确率都是纸面数字。系统越复杂、查询越复杂,出错的隐蔽性越强,用户的信任成本就越高。而信任恰恰是智能问数落地的基石。
为什么 “可确认” 是不可逾越的生死线
很多人觉得,不就是中间多一步确认吗,至于上升到生死线?
至于。
因为企业数据决策要求极其严谨。
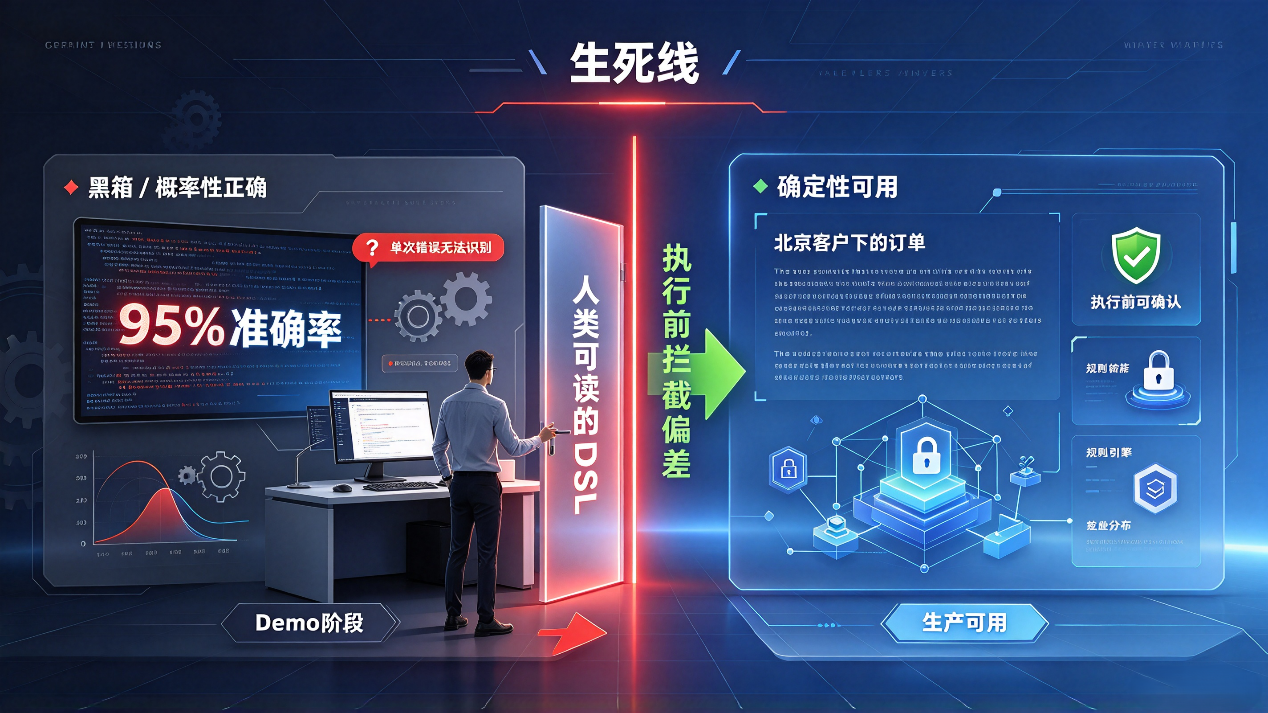
准确率是群体统计指标,是对一万次查询的正确率描述。但业务人员面对的永远是单次查询:这一次的结果对不对?能不能拿去汇报、能不能用来做决策? 哪怕系统整体有 95% 的准确率,只要单次查询的错误无法被识别,对用户来说就是不可控的风险。经营决策不是抽奖,一次错误的结论,就可能让用户对整个系统的信任彻底崩塌。信任崩塌只需要一次,重建却要无数次。
所以智能问数的核心矛盾从来不是 “能不能做对”,而是 “做错了能不能被及时发现”。 直接生成 SQL 做不到,机器可读 DSL 也做不到,因为用户看不懂,就没有校验能力。只有当中间层 DSL 是人类可读的,业务人员才能在执行前扫一眼,确认 “对,这就是我要查的”,或者 “不对,理解偏了”。
所有偏差都在执行前被拦截,所有结果都是确认后的产物,系统才从 “概率性正确” 变成 “确定性可用”。这一步跨不过去,智能问数就永远停留在 Demo 阶段。
润乾 NLQ 的规范文本:既是人话,也是严谨的 DSL
听到这里很多人会说:不就是把 SQL 再翻译成人话给用户看吗? 没那么简单。这里有一个最关键的原则:确认文本不能是对计算逻辑的反向解读,必须就是编译计算的源输入本身。
如果是 AI 先生成 SQL,再用 AI 把 SQL 翻译成自然语言给用户确认,那等于多了一次翻译环节,同样可能出错。用户看到的 “人话” 和实际执行的 SQL,仍然有一定概率不一致,幻觉只是换了个地方而已。
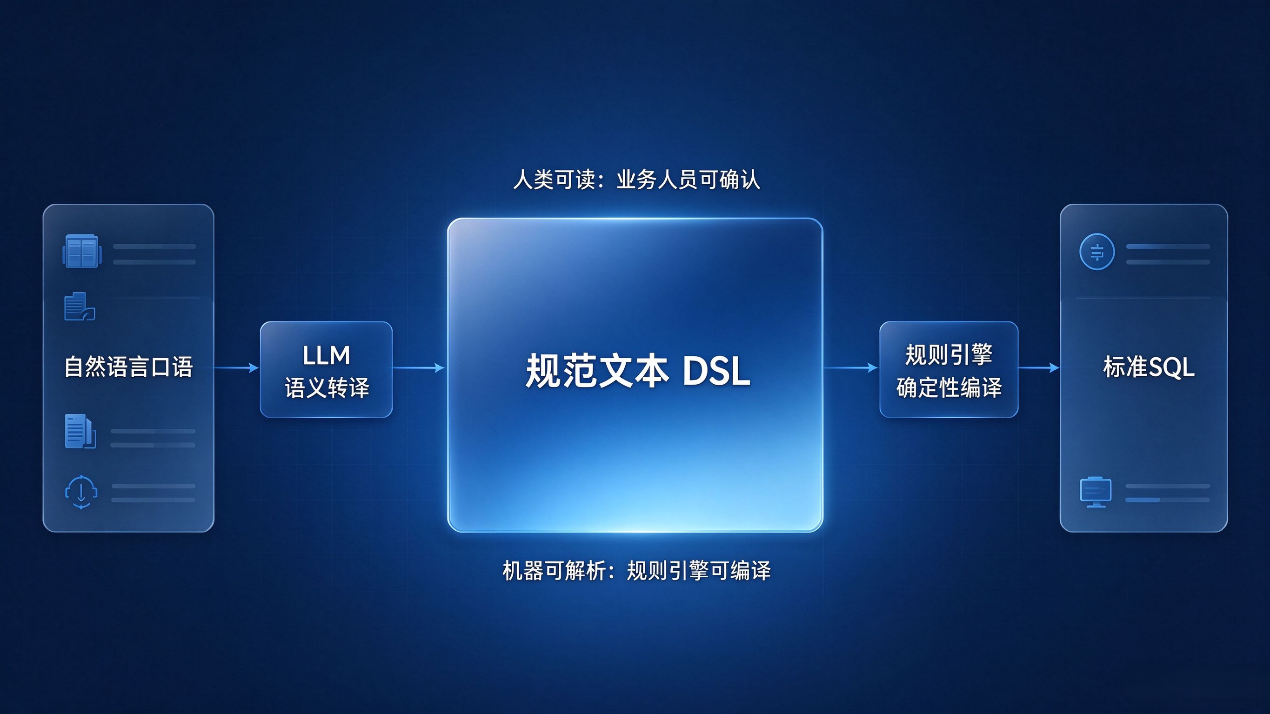
润乾 NLQ 的「规范文本」,是真正意义上的人机双向可读 DSL:同一个文本,既是业务人员能看懂的确认依据,也是规则引擎编译 SQL 的唯一输入。它同时满足两个核心属性:
人类可读:零技术门槛,一眼能判断对错
规范文本不用任何技术语法,没有 JOIN、没有子查询、没有函数表达式,就是接近日常的结构化表达。 比如用户问 “去年都有哪些客户没开单”,转换后的规范文本就是:“签单日期 去年 没有 订单 客户”,或者更简洁:“去年 没有 订单 客户”。 不需要任何数据库基础,业务人员扫一眼就能判断:对,就是这个意思;或者不对,这不是我想要的。
机器可解析:规则驱动,100% 确定性转换
规范文本不是随意的自然语言,有严格的词汇边界、结构规则和组合逻辑。背后的 NLQ 规则引擎可以基于词典将其确定性地编译为 SQL,没有 AI 发挥空间,没有概率猜测。 从规范文本到 SQL 是确定的、可追溯的、可复现的。只要规范文本确认无误,执行结果就一定正确。
在这套架构里,LLM 的角色被极度简化:它只做 “口语转规范” 的翻译工作,不需要懂表结构、不需要写 SQL、不需要做任何逻辑决策。它只做自己最擅长的自然语言理解,把五花八门的业务口语、行业黑话、模糊表达,整理成统一的规范文本。 出错了,用户一眼就能发现,调整提问方式即可;确认后,后续全程规则驱动,和 AI 再无关系。
双向可读 DSL 带来的是全链路可控性
这不止是体验问题,更是落地成本和维护成本的本质差异。
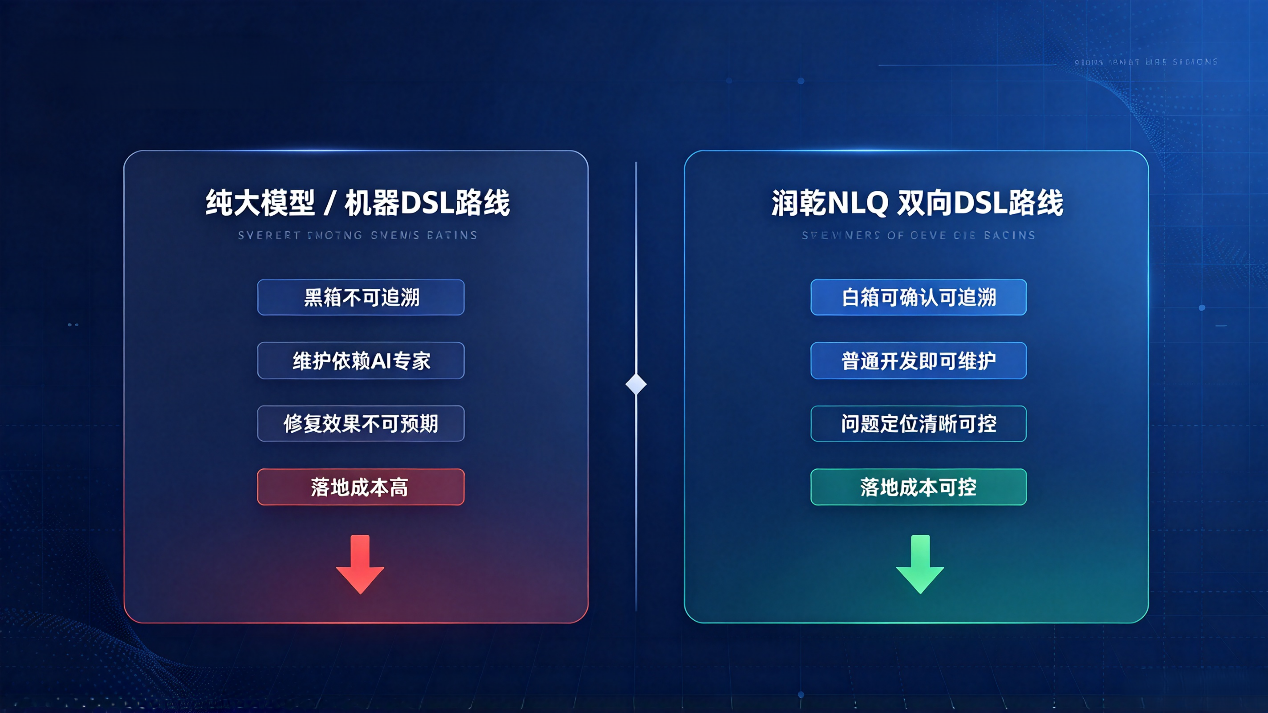
纯大模型路线的智能问数项目,为什么容易烂尾?因为整个链路是黑箱,出了问题找不到根因。结果错了,不知道是模型理解偏差、提示词不对、还是数据口径问题。修复靠 “调 prompt”“再训练”,效果不可预期,经常是修了一个问题,又冒出三个新问题。实施要 AI 专家团队,维护要持续投入,成本像无底洞。
而基于双向可读 DSL 的 NLQ 路线,整个链路都是透明、可控、可调试的:
意图错了:看规范文本一目了然,是 LLM 转译偏差,还是用户表述不清,立刻就能定位。
执行错了:查词典、查规则,是缺业务词条、还是表关联配置错误,定位清晰,补一条配置就能修复。
新增业务:更新词典、补充指标定义,规则式扩展,效果可预期,不会牵一发而动全身。
实施不需要 AI 专家,普通数据库开发人员就能构建业务词典;维护不需要持续调优,有问题改配置即可,小时级完成修复。这才是企业能接受、能落地、能持续运营的方式。
智能问数早已过了靠 Demo 惊艳的阶段,真正的比拼在落地。人机双向可读的 DSL,看似只是微小的设计,却是撬动落地信任的支点,更是智能问数的生死线。
过不了这条线,再高的准确率、再多的功能概念都是空中楼阁。跨过去了,才算真正拿到企业级落地的入场券。润乾 NLQ 走的这条路,不炫技、不超前,却最扎实,也最适配真实的业务场景。