
求助: nodes 函数效率问题
大佬们,月饼节快乐😄
有一个父子层级的题在用 nodes 函数解决时,发现效率不理想,以下写法的复杂度是不是 O(n×n):
表.new(表.nodes(字段,~))
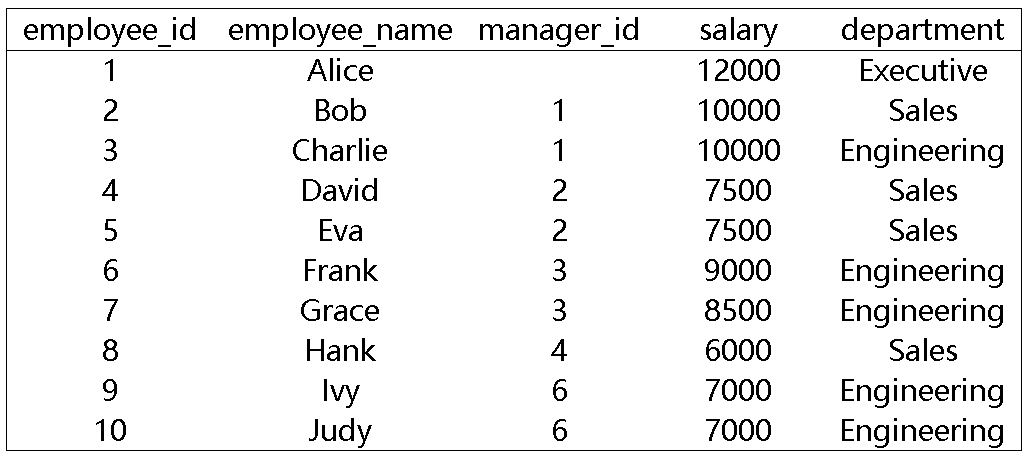
源表如下,其中 employee_id 是子级,manager_id 是父级:
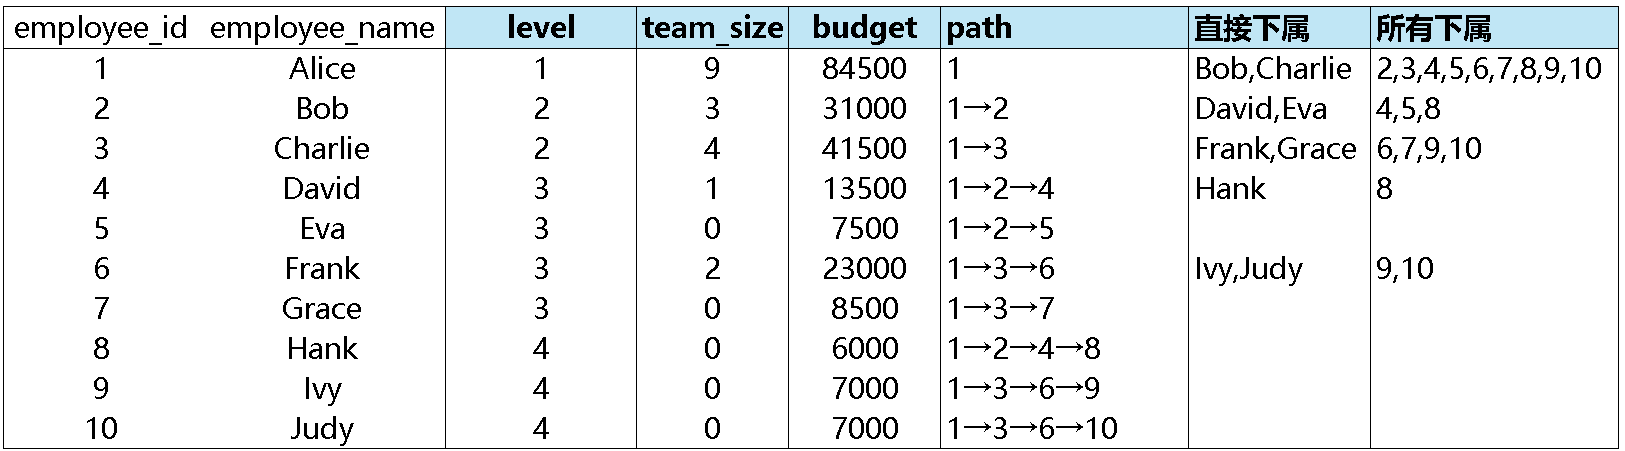
希望得到如下结果,右侧 6 列是需要计算得到的
SPL 有 switch、prior、nodes 函数非常方便解决这类父子层级的问题:
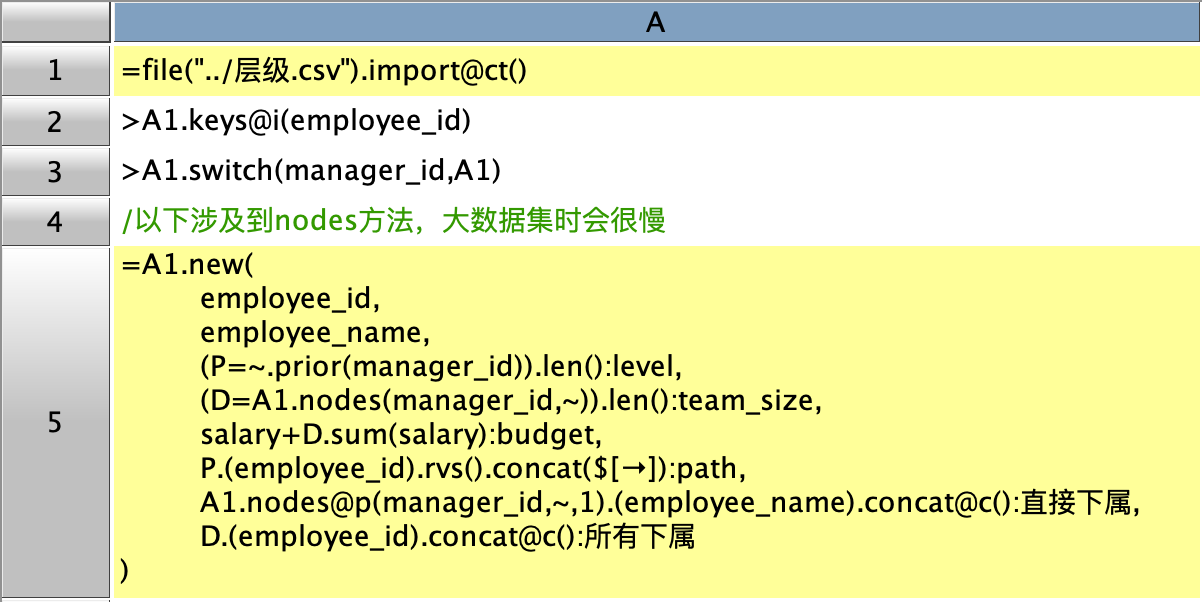
上述 A5 代码格中涉及到 prior 函数的没有问题,稍大数据集也能很快出结果,但涉及到 nodes 函数的在大数据集时会变的非常慢。比如计算 team_size,budget, 直接下属,所有下属那几句,都要先返回后代,似乎 nodes 在上述写法中变成了平方级的复杂度。
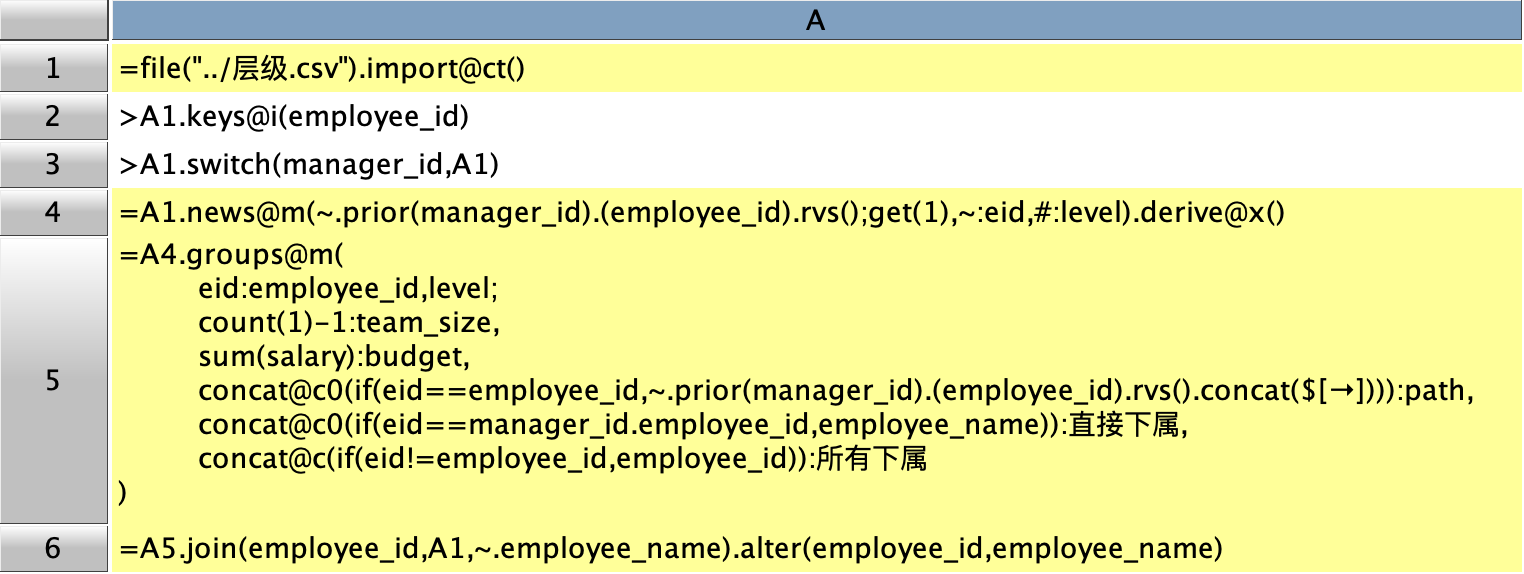
想了另外一种方法,switch 后用 prior 得到父子路径扩展行数,再用 groups 分组聚合,效率倒还可以,30 万行的表也能在 3 秒左右返回结果,但这就变得和 SQL 一样的思路了,有点冗长:
我想求助的是,用 nodes 方法怎么样写才会变的高效?恳请大佬们得空给予指导🙏
附件如下 (层级.csv,splx):
大文件 (层级 30 万行.csv) 传不上来,可以从以下网盘下载:
链接: https://pan.baidu.com/s/1uimnYHe3H8bfEmqvrK9Hhw?pwd=4f77 提取码: 4f77