
调试 SQL 该像调试代码一样
写 SQL 的调试体验,还停留在猜
跑完一段 80 行的 SQL,结果列的数字不对。你的第一反应是什么?再跑一遍。
写代码的人这时候会打开调试器,打断点,单步走,每个变量走到哪一步、变成多少,全看得一清二楚。写 SQL 的人呢?只能盯着最终那张表开始猜:是关联条件错了?还是窗口函数的分区漏了?想看中间那一步的结果?没有。你得把 CTE 甚至嵌套查询一个个拆开,改成 SELECT 单独跑,跑完再拼回去。
这不叫调试,这叫考古。
SQL 的调试体验,还停留在 "跑一遍,然后盯着输出猜"。
写代码时你不会接受这种调试方式,为什么写 SQL 就忍了?
一个真实的场景:按偏移量搜相邻记录
说起来太虚,来个具体的。
车间扫码记录表,每条记录是某条生产线某个时刻扫到的纸板编号。要求:按生产线分组,组内按时间排序后,找出编号等于指定字符串(比如 spL1ml82N4o)的记录,以及它们前后各 2 条记录,最后按 id 去重。
传统 SQL 写出来是这样(MySQL):
SELECT id,
  MAX(Cardboard_Number) AS Cardboard_Number,
  MAX(date_Time) AS date_Time,
  MAX(ProductionLine_Number) AS ProductionLine_Number,
  MAX(flag) AS flag,
  MAX(in_range) AS in_range
FROM (
  SELECT id, Cardboard_Number, date_Time, ProductionLine_Number, flag, in_range
  FROM (
    SELECT id, Cardboard_Number, date_Time, ProductionLine_Number,
      MAX(flag) OVER (
        PARTITION BY ProductionLine_Number
        ORDER BY ProductionLine_Number ASC, date_Time ASC
        ROWS BETWEEN 2 PRECEDING AND 2 FOLLOWING) AS in_range
    FROM (
      SELECT id, Cardboard_Number, date_Time, ProductionLine_Number,
        CASE WHEN Cardboard_Number = 'spL1ml82N4o' THEN 1 END AS flag
      FROM table1
    ) AS flagged
  ) AS marked
  WHERE in_range = 1
) AS filtered
GROUP BY id;
不逐行解释这段代码,只说观感:三层派生表嵌套,标记、窗口范围、筛选、去重全压在一个查询里;每一层都要把字段重新列一遍,想看中间结果,只能继续往里拆。
关键不在难看,在难查。这段 SQL 里最脆弱的是那个窗口范围 ROWS BETWEEN 2 PRECEDING AND 2 FOLLOWING:偏移量写错了,它不报错。分区键漏了,它也不报错。它们只是悄悄地把结果算错一点点——看起来有点对,又不太对,正好够让你在上线前手心出汗。而中间的标记列、窗口命中列在最终结果里根本不输出,你看不见它们,就没法验证它们。
SQLazy:分步写,单步调
如果换一种做法:不是一句 SQL 交付终态,而是把逻辑拆成几步,每一步都能执行、都能看结果。
这正是 SQLazy 在做的事。SQLazy 是直白易懂的结构化数据计算语言,分步清晰、输出确定、便于审计。同一道题,它写出来是 5 步:
Name |
Anchor |
Statement |
t1 |
table1 |
sort ProductionLine_Number, date_Time asc |
t2 |
compute if (Cardboard_Number = "spL1ml82N4o" then 1), as flag; partition ProductionLine_Number |
|
t3 |
compute max, flag[-2:2], as in_range; partition ProductionLine_Number |
|
t4 |
filter in_range = 1 |
|
t5 |
distinct id |
而且它有个专门的调试功能:单步执行。点一下,执行一步,当前步骤和之前所有步骤的结果表都摆在那里,随时翻看。这和调试 Python、Java 时用的单步是一个东西——区别只在于 SQLazy 的代码结构更简单,没有分支和循环以及子程序,所以用不着断点、step in、step out 那一套,每句代码本身就是一步。
回到刚才那道题,调试体验是这样的:
* 第 1 步排序,点开看组内顺序对不对;
* 第 2 步给目标行打标记,看标记有没有漏;
* 第 3 步取前 2 后 2,这一步是整道题最容易错的地方,窗口范围、分区键都在这里。单步走到第 3 步,点开 in_range 列,哪几行被命中、哪几行没命中,一清二楚;
* 第 4 步筛选,第 5 步去重,各点一下各看一眼。
在 SQL 里,窗口范围写错只能靠猜;在 SQLazy 里,单步走到第 3 步看一眼就行。
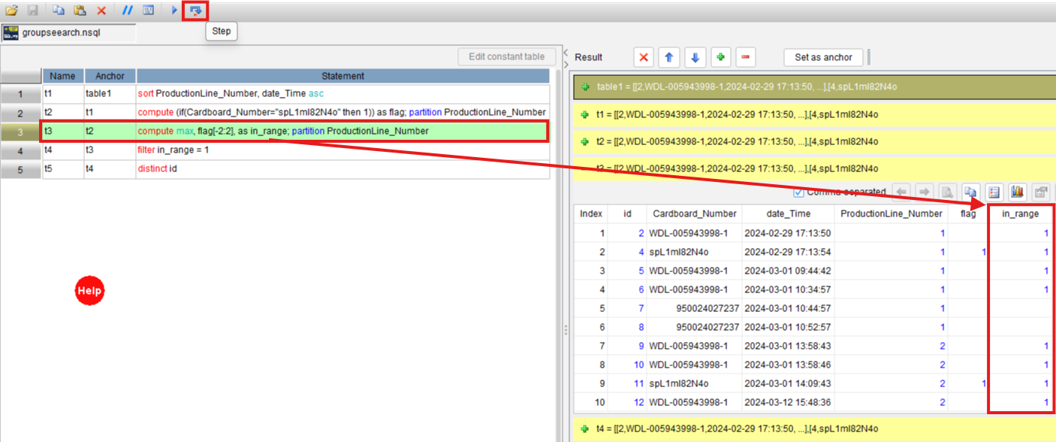
错在哪一步,就只改哪一步,不用整段重来。确认逻辑都对之后,也可以一键全部执行,几步连着跑完,直接拿最终结果。
改变的是形态,不只是写法
有人会说:我在 SQL 里把每个 CTE 都 SELECT 出来,不也能看吗?能,但那是你手工模拟的单步,改一次逻辑就得重拆一次,步骤永远不会替你保留。AI 也改不了这件事,AI 帮你写出来的,同样是一句终态 SQL,错了照样从头猜。
AI writes the logic. A compiler writes the SQL.
在 SQLazy 里,AI 负责把业务逻辑规划成一步一步,编译器负责把这些步骤编译成原生 SQL。步骤是给人看、给人调的,SQL 是给机器跑的,各管一段。
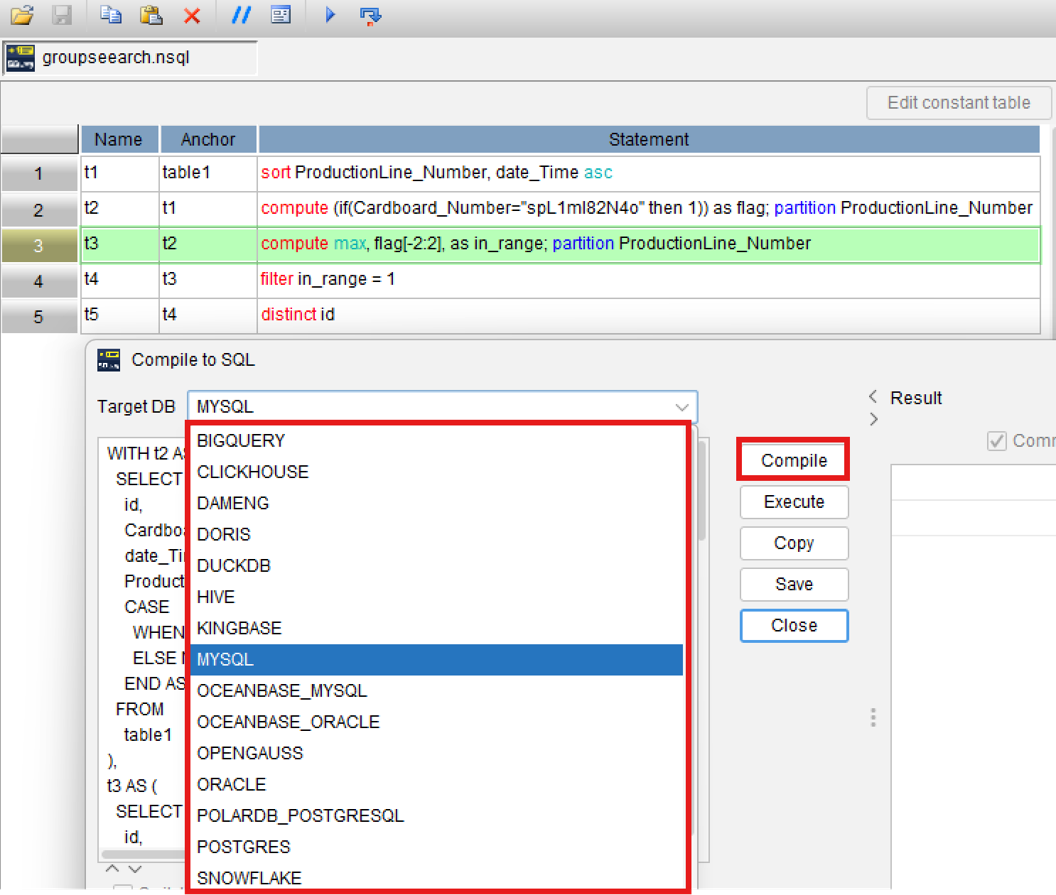
编译出来的 SQL 和你手写的等价,没有额外抽象层,复制即用,也不绑定某个数据库。
说句实话:简单的增删改查,直接写就行,用不上这套。真正值得分步调的,是分组取相邻、条件重置、分段对齐这类 "错一步全盘错" 的逻辑。
换个调试方式
想试试单步执行的味道?这个按偏移量搜相邻记录的例子直接能跑:https://www.sqlazy.com/?2Qk
会话化、连续区间、动态分组报表这些例子,都在示例库:https://github.com/SPLWare/SQLazy/tree/master/examples
你平时调 SQL 是怎么找错的?把 CTE 拆开单跑,还是盯着输出硬想?不管哪种,都比点一下单步执行累。