
(已解决 -runs like magic!)nodes 函数效率问题
大佬们,月饼节快乐😄
有一个父子层级的题在用 nodes 函数解决时,发现效率不理想,以下写法的复杂度是不是 O(n×n):
表.new(表.nodes(字段,~))
源表如下,其中 employee_id 是子级,manager_id 是父级:
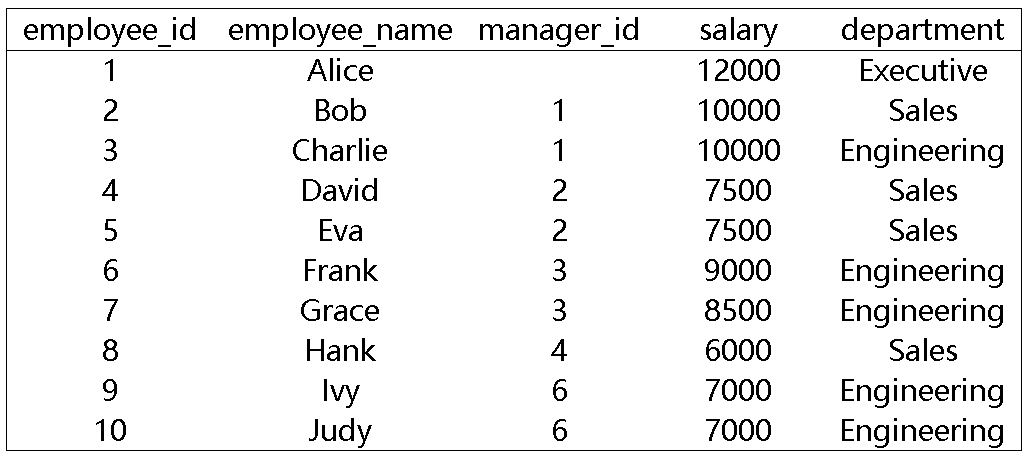
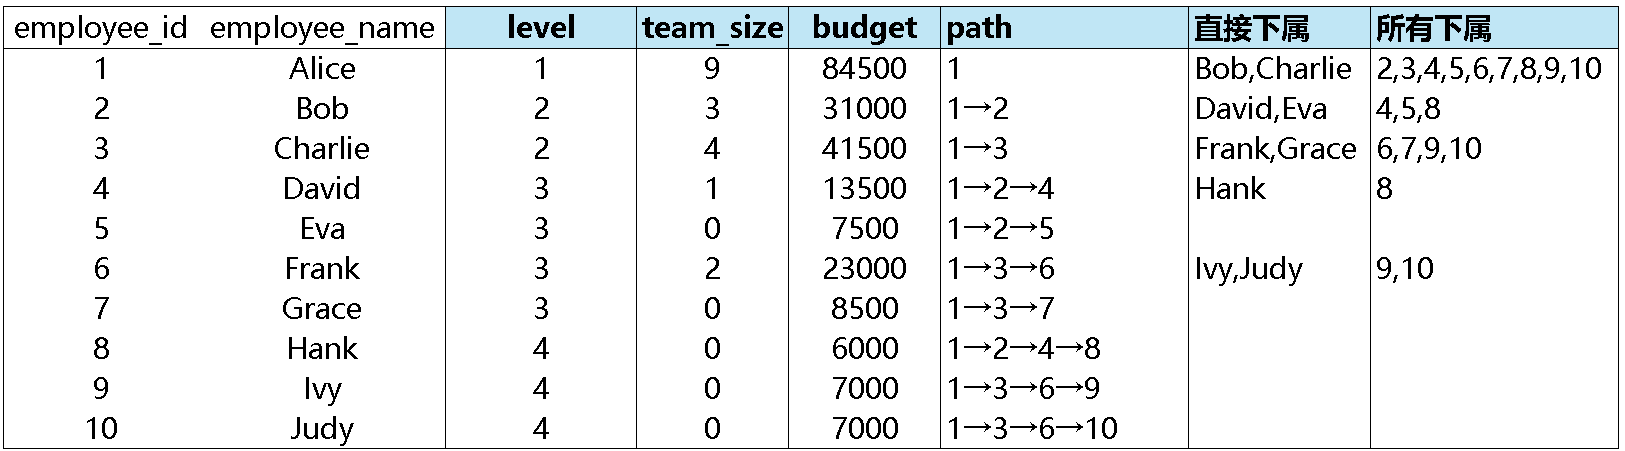
希望得到如下结果,右侧 6 列是需要计算得到的
SPL 有 switch、prior、nodes 函数非常方便解决这类父子层级的问题:
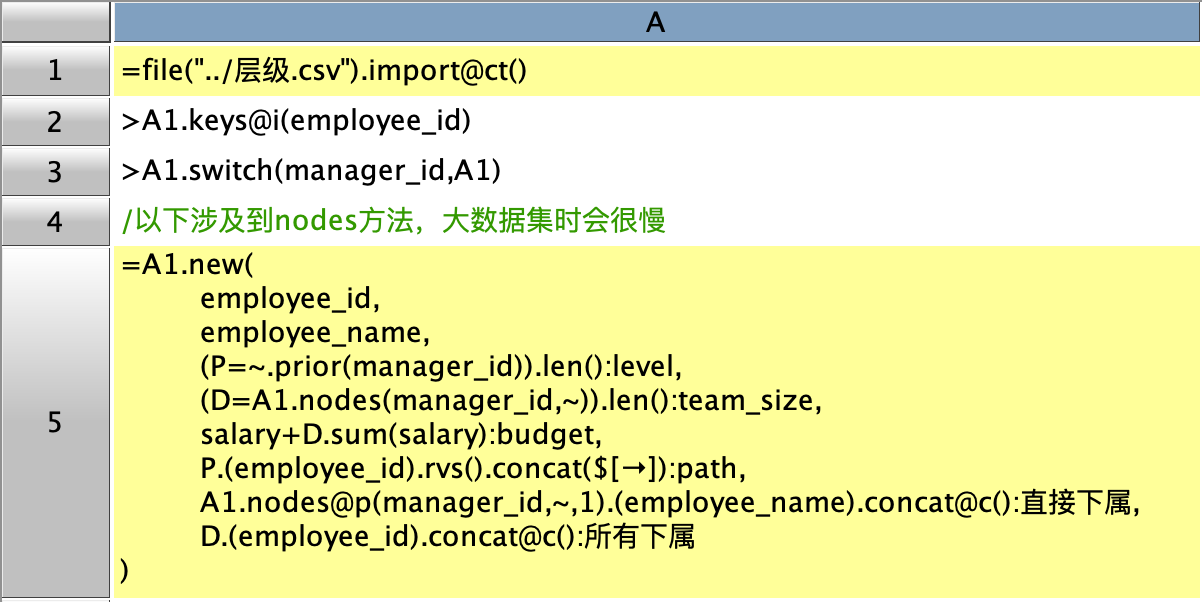
上述 A5 代码格中涉及到 prior 函数的没有问题,稍大数据集也能很快出结果,但涉及到 nodes 函数的在大数据集时会变的非常慢。比如计算 team_size,budget, 直接下属,所有下属那几句,都要先返回后代,似乎 nodes 在上述写法中变成了平方级的复杂度。
想了另外一种方法,switch 后用 prior 得到父子路径扩展行数,再用 groups 分组聚合,效率倒还可以,30 万行的表也能在 3 秒左右返回结果,但这就变得和 SQL 一样的思路了,有点冗长:
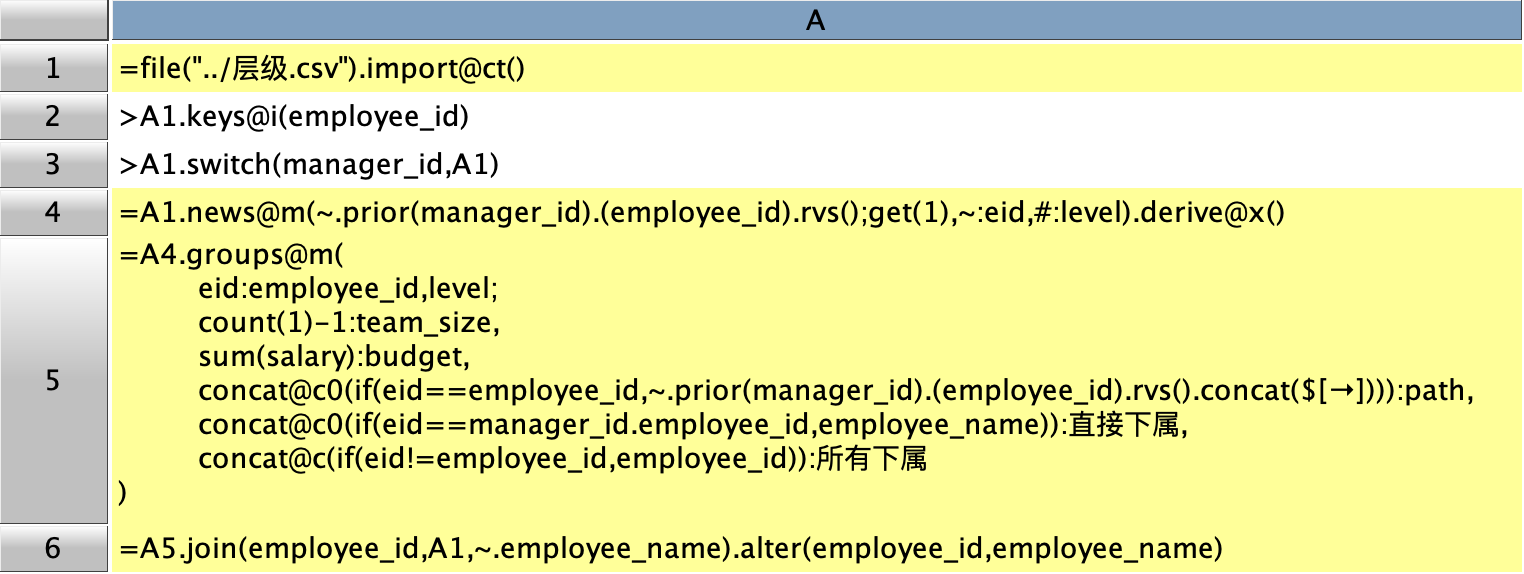
我想求助的是,用 nodes 方法怎么样写才会变的高效?恳请大佬们得空给予指导🙏
附件如下 (层级.csv,splx):
大文件 (层级 30 万行.csv) 传不上来,可以从以下网盘下载:
链接: https://pan.baidu.com/s/1uimnYHe3H8bfEmqvrK9Hhw?pwd=4f77 提取码: 4f77
nodes 函数本身没什么优化余地了,要想提速只能使用其它函数实现 nodes 的功能
😄 prior 函数很快,nodes 不快,这多少有点不甘心啊…nodes 函数那么好的函数。
第二种方法效率还行,但我非常拒绝 A4 中用到的 explode 成多行的这种思路,news 函数没问题,很好用,我就是不喜欢炸开这种野路子。
可以在导入后给源序表增加两个字段:直接下属、下属,做完 switch 后循环序表,然后对每条记录计算 prior,然后循环 prior 的结果添加下属记录。代码类似如下:=file(…).import@ct().derive([]: 直接下属,[]: 下属).run((a=,manager_id. 直接下属.insert(0,a),.prior(manager_id).to(2,).(下属.insert(0,a))))
握艹😂 …怎么会那么快,30 万行秒出, 谢谢大佬指导🙏
a=~,
manager_id. 直接下属.insert(0,a),
~.prior(manager_id).to(2,).(下属.insert(0,a))
)
(P=~.prior(manager_id)).len():level,
P.(employee_id).rvs().concat($[→]):path,
直接下属.(employee_name).concat@c(): 直接下属,
下属.sum(salary)+salary:budget,
下属.len():team_size,
下属.(employee_id).concat@c(): 下属
)
哈哈, 大佬, 你这个路子拍案叫绝了👍 👍 …欣赏两天,意犹未尽😂
咱那个 nodes 函数没得办法动他一动吗?nodes@r 的用法到现在我还不知道用来干啥😂
nodes@r 的数据结构是相反的,不是下属指向上级,而是上级包含所有的直接下级。
nodes@r 返回的是上级的所有最终下属,即一个树型结构中某一个节点的所有叶子节点。