
私域环境算力不足也能用 AI 对话式的 BI 自助报表
AI 对话式自助报表现在很火,说句话就能出报表,听起来确实方便,很多企业都想试试,但现实是,市面上的 AI 自助报表产品大多基于 LLM 实现,而不少机构对数据安全和合规有严格要求,不允许调用公网 LLM 的 API,想上线一套自助报表,就绕不开私域大模型这条路,可私域大模型背后,是高昂的算力成本,并不是每家企业都能轻松跨过这道门槛
对话式 BI,只是大算力玩家的游戏吗?
大模型需要 GPU 硬件,需要 AI 技术团队,还需要承担不小的电力和运维消耗
对企业来说,是否有能力搭建私有大模型是一道坎
搭建好之后,是否有充足的算力支撑日常使用,又是一道坎
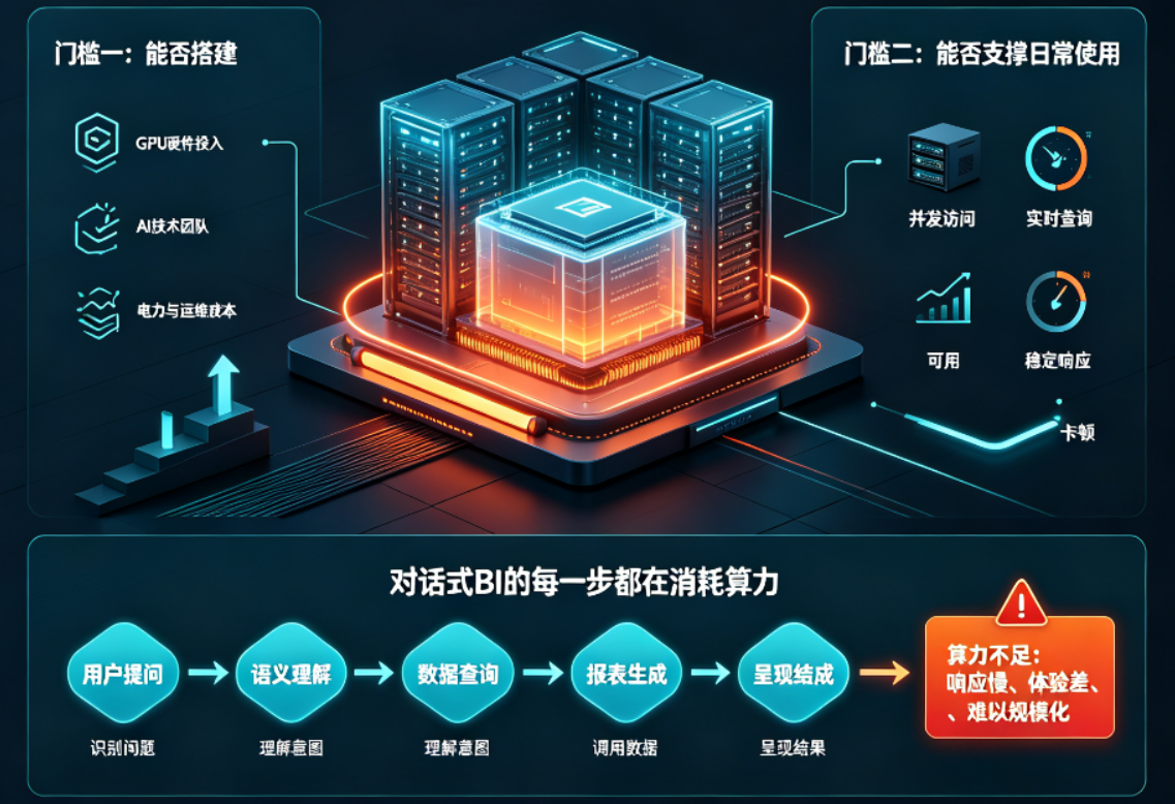
对话式 BI 并不是上线一个概念就够了,用户提问、语义理解、数据查询、报表生成,每一个环节都需要算力,如果没有充足的算力,系统响应慢,体验就会很差,根本用不起来,更谈不上规模化推广
而且企业的大模型,也不可能是给 BI 专用的,算力就会更加捉襟见肘
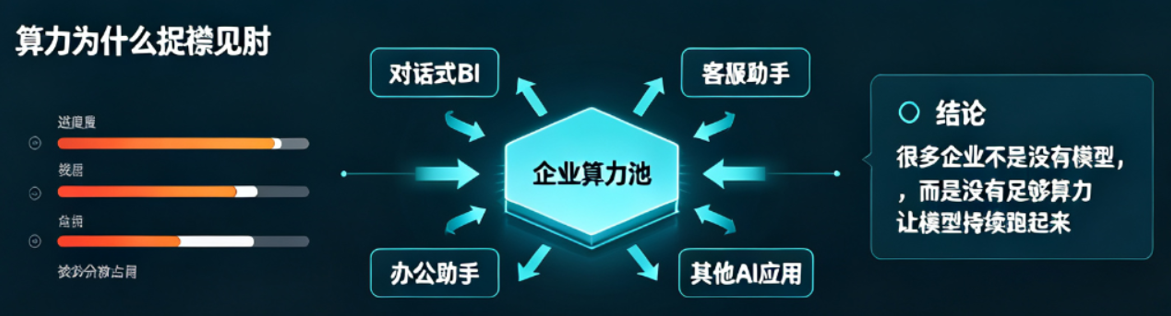
所以,很多企业被算力不足的问题卡住了
不用 LLM,也能“说话做报表”
没有充足算力的企业,就只能看别人用吗?
未必!
对话式 BI 不一定非靠大模型不可,如果能接受“没那么灵活,但仍然可用”的交互方式,其实完全可以用普通 CPU 就能跑起来的方案,实现 AI 对话做报表
润乾 AI 自助报表就提供了一种新的实现路径:没有大算力,也能用 AI
润乾自助报表可以不依赖 LLM,而是通过自研的规则引擎实现对话做表功能
它已经把报表的常规操作都纳入其中,可以将用户输入的自然语言命令解析为明确的操作步骤,然后自动完成操作
比如在下面的汉语输入框中,输入命令后,报表自己就做好了
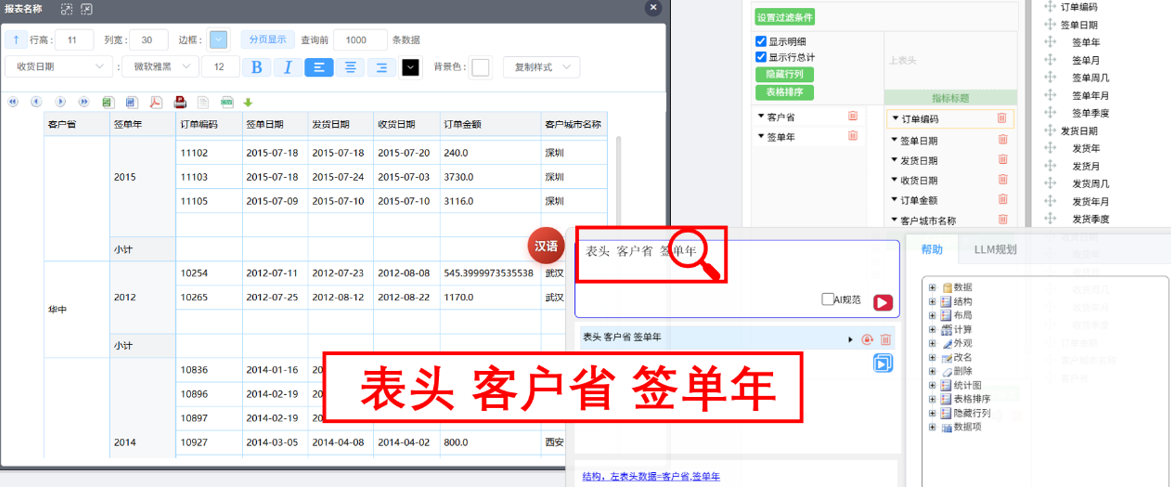
然后可以根据需求,一步步再用命令完善报表
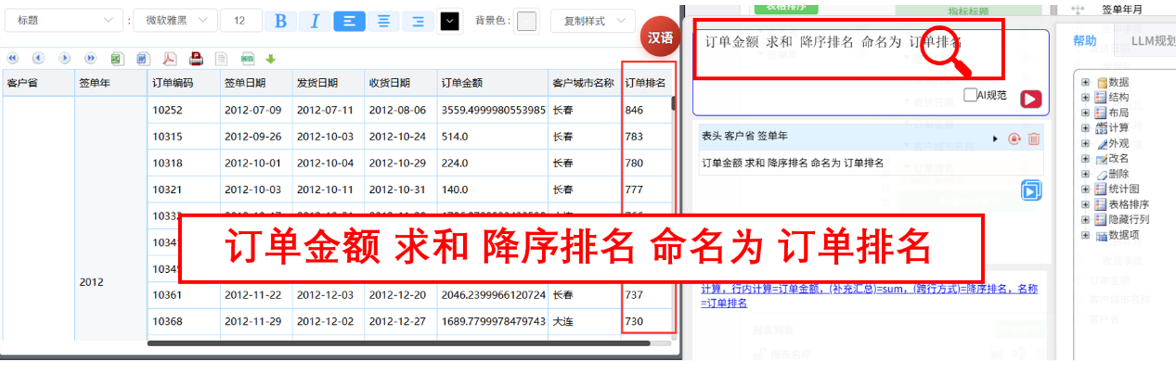
润乾 AI 自助报表的规则引擎直接包含在报表安装包中,是一个普通的 JAVA 应用,普通 CPU 服务器就可以运行,不需要 GPU,不消耗算力
相比完全依赖大模型的方案,这种方式更轻,也更适合算力有限、合规要求较高的企业
不过,这种模式也有它的边界,它更强调规范和可靠
用户需要输入相对规范的命令才可运行,如果表达过于口语化、模糊或复杂,引擎识别不到,就不会执行命令,不会去猜结果
当然,输入规范的命令也不难,输入时候有帮助提示,有可以参考的规范命令示例
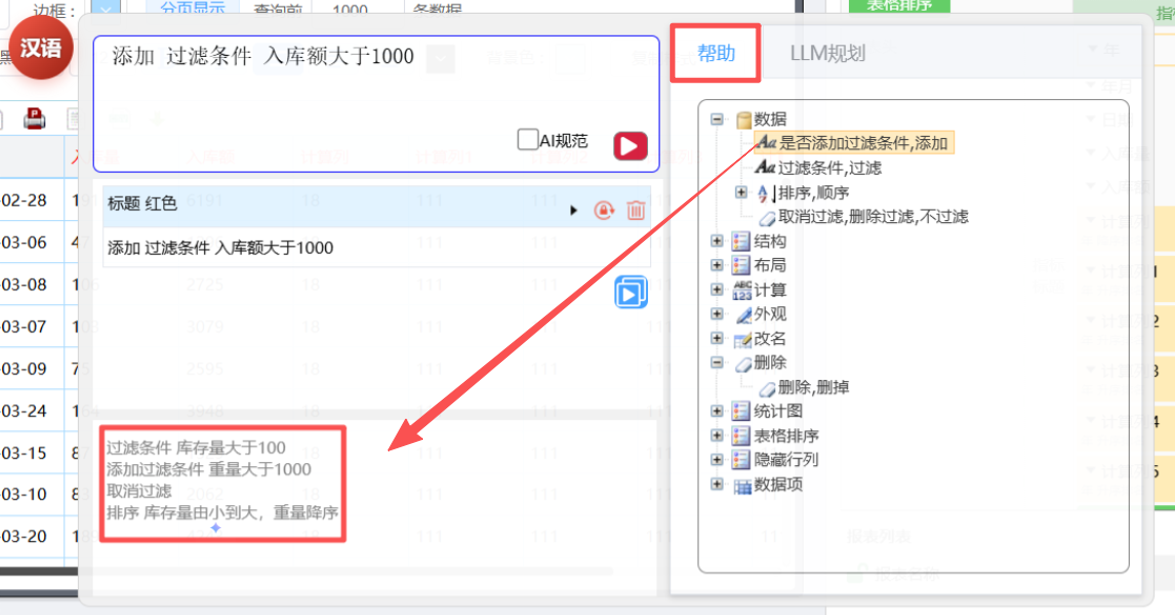
而且操作也可以撤销,试错了撤销就可以
规则引擎不是无限灵活的自然语言理解,而是一种更可控、可落地的交互方式,对很多企业来说,这种“规范但可靠”的方式,反而更适合内部报表场景
加上 LLM 也不费太多算力
有了 LLM,润乾自助报表也能支持更自由、灵活的方式,也就是 “规则引擎 +LLM”的混合模式
在这种模式下,LLM并不负责生成报表,而是只负责把用户自由、灵活的自然语言,翻译成规则引擎能够准确执行的规范命令,真正的数据查询、逻辑处理和报表生成,仍然由规则引擎完成
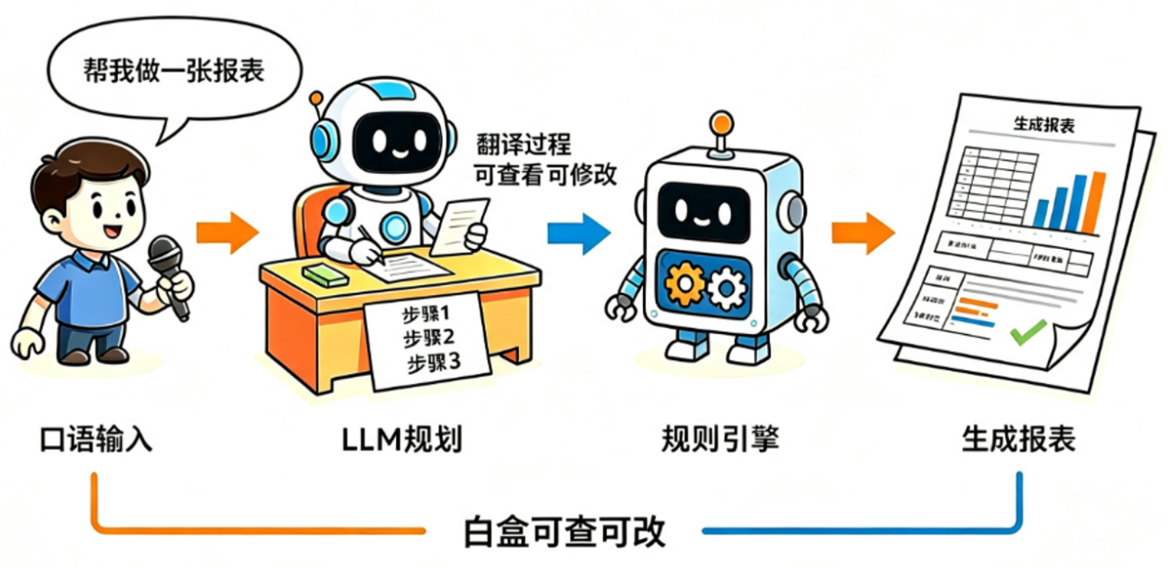
这个模式还有三个明显优势
第一:消耗算力极少
因为 LLM 只负责翻译命令,不涉及复杂的数据推理和报表生成,输入只有用户需求,输出只有几行命令,token 量忽略不计;而完全依赖大模型做报表的方案中,要输入所有数据并输出渲染后的页面,token 量直接高了两个数量级。两者消耗的算力天差地别
第二:没有安全问题
LLM 只翻译,只获得用户的需求并输出指令,不接触真实业务数据,即使是用公网 LLM,数据也仍然留在私域内部,守住了数据安全边界。而完全依赖大模型报表的方案则要把数据都送给 LLM 生成页面,数据风险极大
第三:解决幻觉困扰
LLM 有个通病,处理数据是个黑盒,还容易产生幻觉,难查难改,影响使用
但是在这个模式中,LLM 翻译后的命令是人机都可读的中文,用户可以读懂,报表工具可以执行
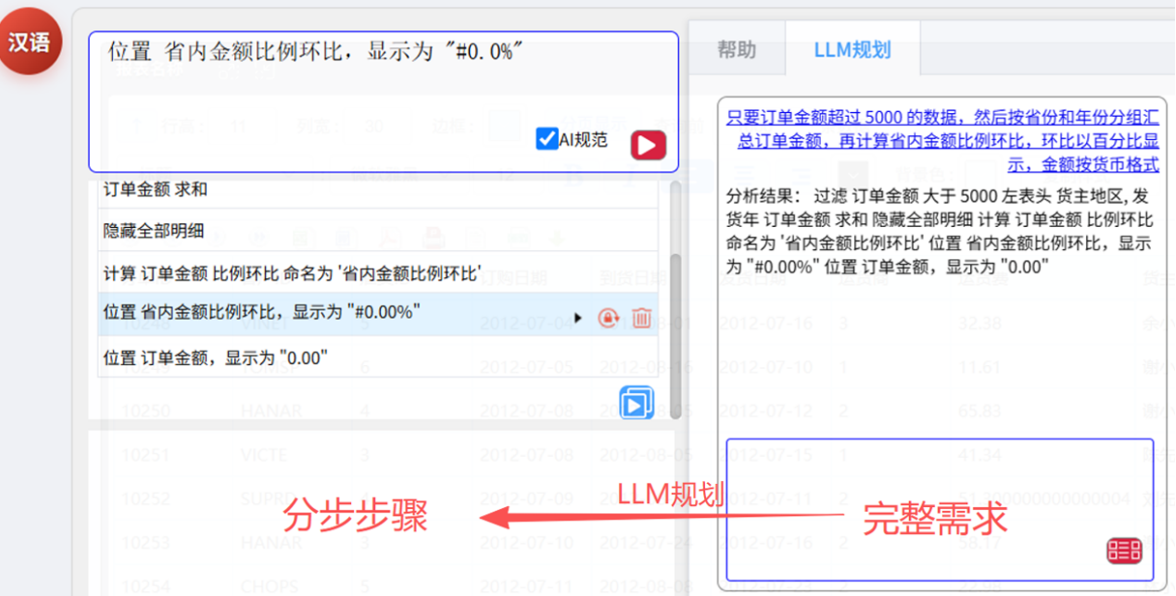
每一步都是白盒,可查可改,即使 LLM 有幻觉,翻译错误,也能及时发现并修正,彻底解决了幻觉问题的困扰
加上 LLM 的混合模式,更加灵活自由,但算力消耗却并不多,也给算力有限的企业提供了另外一种选择
结语
私域环境下算力不足,不代表就不能做 AI 自助报表
润乾这套模式,恰恰让企业绕开了大模型、大算力、大投入这些门槛,不用 LLM 也能享受 AI 对话式自助报表的能力,普通 CPU 就能跑起来,落地轻、维护简单
更关键的是,润乾报表本身价格也很实在,三万买断,不限用户、不限使用,对企业来说,花小钱就能把 AI 对话式报表用起来,不用再为算力和成本焦虑,这才是真正务实的选择