
都 ChatBI 了,俺做的固定报表却还不能用人话筛选数据?
ChatBI 如今很火,业务人员说一句话,系统就能自动查询数据,生成图表,实现从零开始的数据探索,体验很好
但企业里大量已经建好的固定报表,像销售周报、库存月报、管理层看板,依旧只能靠参数模板点选控件完成查询,不能用自然语言筛选
ChatBI 不能把这块也一起搞一下吗?
还真不能
1 ChatBI 为啥不能让固定报表也智能筛选
ChatBI 擅长从无到有,根据用户提问,查询数据,生成报表图表
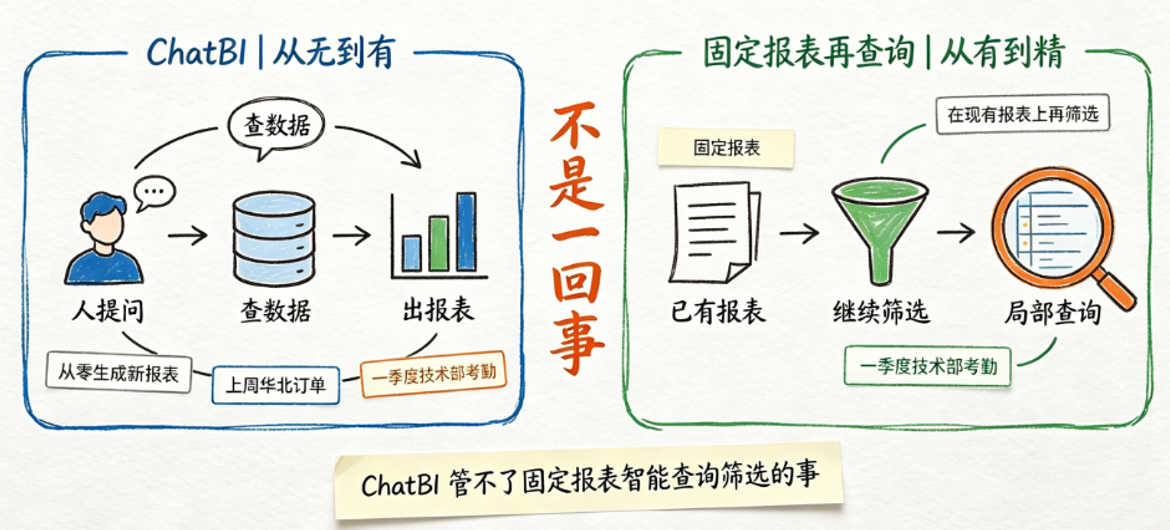
而固定报表报表的再次查询筛选,是从有到精,是在已经成型的报表基础之上,做再次筛选、局部查询,比如查看上周华北地区订单、一季度技术部考勤情况等
二者属于完全不同的业务场景,ChatBI 管不了固定报表智能查询筛选的事
2 直接用 AI 技术做是否可以
ChatBI 管不了,那直接让大模型把自然语言翻译成 SQL,不就可以实现筛选了?看似可行,实则隐患很大,因为LLM 有幻觉问题
主流测评显示,最聪明的大模型在编写 SQL 的任务上也只有不到 70% 的正确率
虽然固定报表场景下数据范围已经被限定在已知数据集上,筛选本质上只是生成 WHERE 子句,难度降低了不少,准确率确实会更高,但在较复杂的情况依旧存在幻觉问题
就算模型正确率做到 90%,剩下 10% 的错误对企业来说依旧不可接受,业务人员很难分辨 SQL 以及数据是否出错,一旦拿错误数据用于汇报决策,会带来严重业务风险
3 更好的解法是什么
专业报表厂商润乾报表提出了一个值得借鉴的思路:不让大模型直接生成 WHERE 子句,而是让它只做擅长的事——理解自然语言并将其规范化;最终的 SQL 生成交给确定性的规则引擎来完成
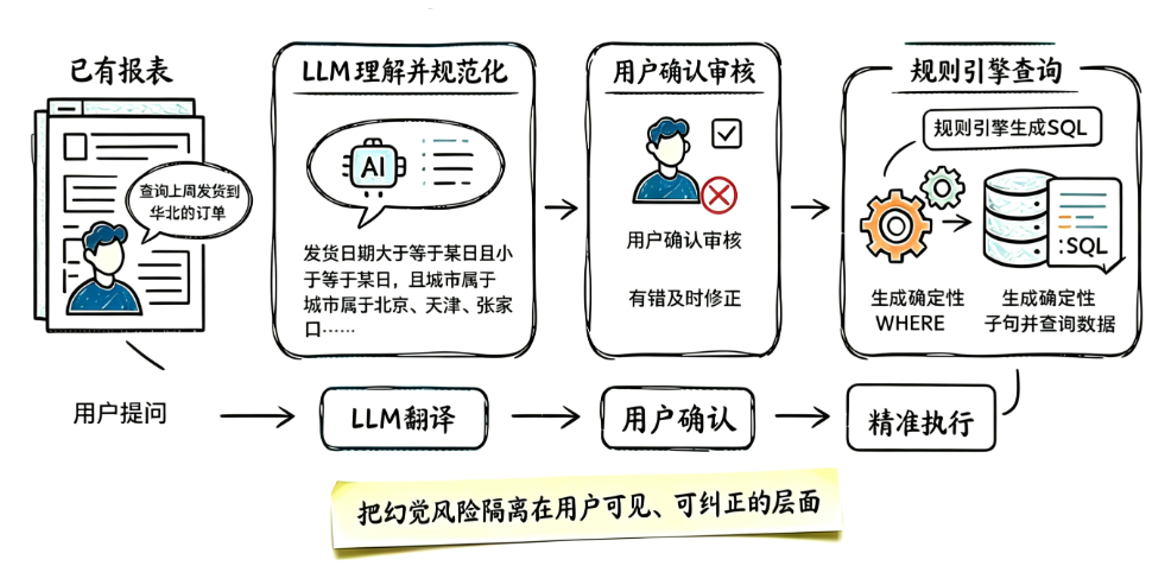
用户输入“查询上周发货到华北的订单”,LLM 将其规范化为“发货日期大于等于某日且小于等于某日,且城市属于北京、天津、张家口……”的结构化描述
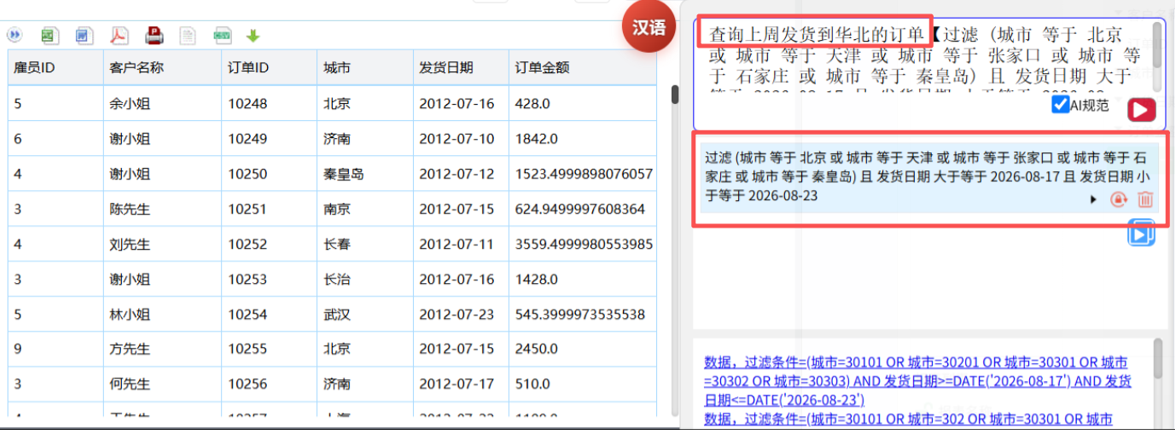
关键一步在于:规范后的汉语命令直接展示给用户确认,如果翻译有错误,比如存在非华北地区的城市,用户当场就能发现并拒绝,确认无误后,再由规则引擎生成准确的 WHERE 子句
这套架构的精髓在于:增加了用户可以确认的环节
将 LLM 的“幻觉”风险隔离在用户可见、可纠正的层面,不让它渗透到最终的 SQL 生成环节,既享受了 AI 的灵活性,又保证了结果的确定性
这套方案还有额外优势:
* LLM 只翻译命令,消耗 Token 少,可以部署私有小模型,成本可控;熟练后直接写出规范命令,甚至可以不用 LLM 了
* 原有报表不需要推倒重做,只是给老报表增加了 AI 接口,也不需要像 ChatBI 那样准确语义层元数据,实施成本很低
* 润乾报表本身也很便宜,还有不限项目无限分发的工具版模式,极低成本就可以让项目享受 AI 能力
说在最后
AI 浪潮之下,固定报表并不会被取代,它会长期、大量存在于企业日常工作中,让存量或者新增的固定报表也拥有自然语言筛选能力,让报表全流程的各个环节都享受到 AI 带来的便利,正是报表工具厂商 AI 化需要持续深耕努力的方向