
Trae+SQLazy 存量存储过程资产化与迁移
让沉睡的存量存储过程
变成看得懂、改得动、迁得走的资产
—— Trae + SQLazy 存量存储过程资产化与迁移 ——
导读 本文介绍如何借助 Trae(AI 编程助手)与 SQLazy,把海量"年代久远、无人敢动"的存量存储过程,改造成中文可读、逐行可验证、易于维护的代码资产;当需要更换数据库时,还能以低成本完成迁移。全文给出从环境搭建到三组实战的完整操作指引——只需照着做,你就能完成第一个存储过程的资产化改造。 |
前期知识储备:TRAE + SQLazy MCP 自动化编写 SQL 实践
一、痛点:为什么存量存储过程成了"包袱"
在大量企业的数据库里,沉淀着成百上千个存量存储过程。它们承载着核心业务逻辑,却普遍面临三大困境:
· 看不懂:年代久远、数量庞大,业务逻辑盘根错节,读懂已经很困难,要维护修改就更加困难。
· 迁不走:一旦需要移植到别的数据库,工作量和风险都会成倍放大,往往只能推倒重来。
· AI 也不是万能钥匙:AI 可以辅助移植,但不能保证结果的正确率。就算能做到 90% 以上的正确率,只要达不到 100%,就总要人工去读懂并维护——因为挑不出来哪些有错,结果还是要全量阅读。
存储过程中最难读懂、最核心的"计算部分",是一大段难以追踪的黑盒。把它变成人人都读得懂、每一步都看得见可的动作,上述困境就会迎刃而解。这正是 SQLazy 的用武之地。
二、SQLazy:把核心逻辑写成人人能读的中文
SQLazy 是一款基于半自然语言(中文/英文)的脚本,专门面向数据处理场景。它的核心理念是:
· 人话易读:代码由功能词与自然语言式表达构成,业务人员也能参与阅读和评审。
· 逐行可见:每一行都可以立即看到执行结果,debug 像看报表一样直观。
· 简洁高效:代码简洁,一大段复杂 SQL 往往可以压缩成寥寥数行。
· 易于维护:读得懂才能改得动,业务修改不再依赖"只有原作者明白"的历史包袱。
三、总体方案:三步实现资产化与迁移
整套方案可以用一句话概括:先把最难的部分"翻译"成 SQLazy 资产,再按需编译回写或跨库迁移。
第 1 步 资产化:计算部分转成 SQLazy 代码
将存量存储过程中最难读懂的计算部分转变成 SQLazy 代码,变成易读易维护的资产。此后所有的业务修改与维护,都直接在这份可读资产上进行。
第 2 步 编译回写:解决"读懂并维护"的难题
将第 1 步的结果编译回存储过程。整个过程配合测试数据逐段验证,结果正确性有保障,存量存储过程"读不懂、改不动"的难题就此化解。
第 3 步 迁移:按目标数据库分两条路径
如果需要迁移到别的数据库,按目标数据库的类型分两种情况:
· 目标数据库支持存储过程:只需把外围骨架迁移成目标数据库的代码。由于最难读懂的计算部分已经是 SQLazy 代码,这部分不需要迁移,所以迁移过程变得很容易、也很好读懂。由 AI 来做迁移,人工很容易看出结果是否正确,也很容易进行维护修改。
· 目标数据库不支持存储过程:将第 1 步的结果进一步改写成 SPL + SQLazy 代码。该代码易读易维护,且支持在所有数据库中运行,不需要再次迁移——直接免去了后续的迁移工作量。
前提条件 SQLazy IDE 打开测试数据(内存库),启动 MCP 服务,Trae 连上 MCP——这三件事就是全部准备工作,下一节手把手带你完成。 |
四、准备工作:十分钟搭好环境
实战需要一个带 SQLazy 插件能力的 Trae 环境。按下面四步操作:
第一步 安装 SQLazy IDE和SPL IDE
从官网下载安装:
SQLazy IDE:https://www.raqsoft.com.cn/download-SQLazy
SPL IDE(标准版):https://www.raqsoft.com.cn/download/download-jsq
将SQLazy IDE安装目录下lib目录下的jar,复制到SPL IDE(标准版)安装目录下的lib目录中(大部分同名的可不必复制,只复制SPL IDE中没有的)
第二步 启动 SQLazy IDE 和SPL IDE并分别连接数据库
连接的数据库必须是存量存储过程所支持的数据库类型。由于实际的数据量太过庞大、会耽误测试时间,这个测试库不需要任何表和数据——测试过程中会自动创建测试表和测试数据,数据量很小,方便测试。
第三步 启动 MCP 服务
在 SQLazy IDE 中点击【工具 / 启动 MCP 服务】。
第四步 在 Trae 中启用 SQLazy-MCP
打开 SQLazy 安装目录下的 MCP/TraeCode 或 MCP/TraeWork 文件夹(不同版本目录名可能略有差异,以实际安装目录为准),在 Trae 的 MCP 设置中激活 SQLazy-MCP。
图 1|MCP/TraeWork 文件夹
检查点 到这里,Trae 就具备了读写 SQLazy 脚本、操作内存表和数据库的全部能力。在 Trae 对话框中能看到 SQLazy-MCP 处于已启用状态,说明环境就绪,可以开始实战了。 |
五、实战一:SQLazy嵌入——让 AI 把计算部分翻译成 SQLazy
本实战以存量存储过程 PRC_1.sql 为例,把其中最难读懂的计算部分转成 SQLazy 代码,并回嵌到存储过程中。原存储过程内容如下:
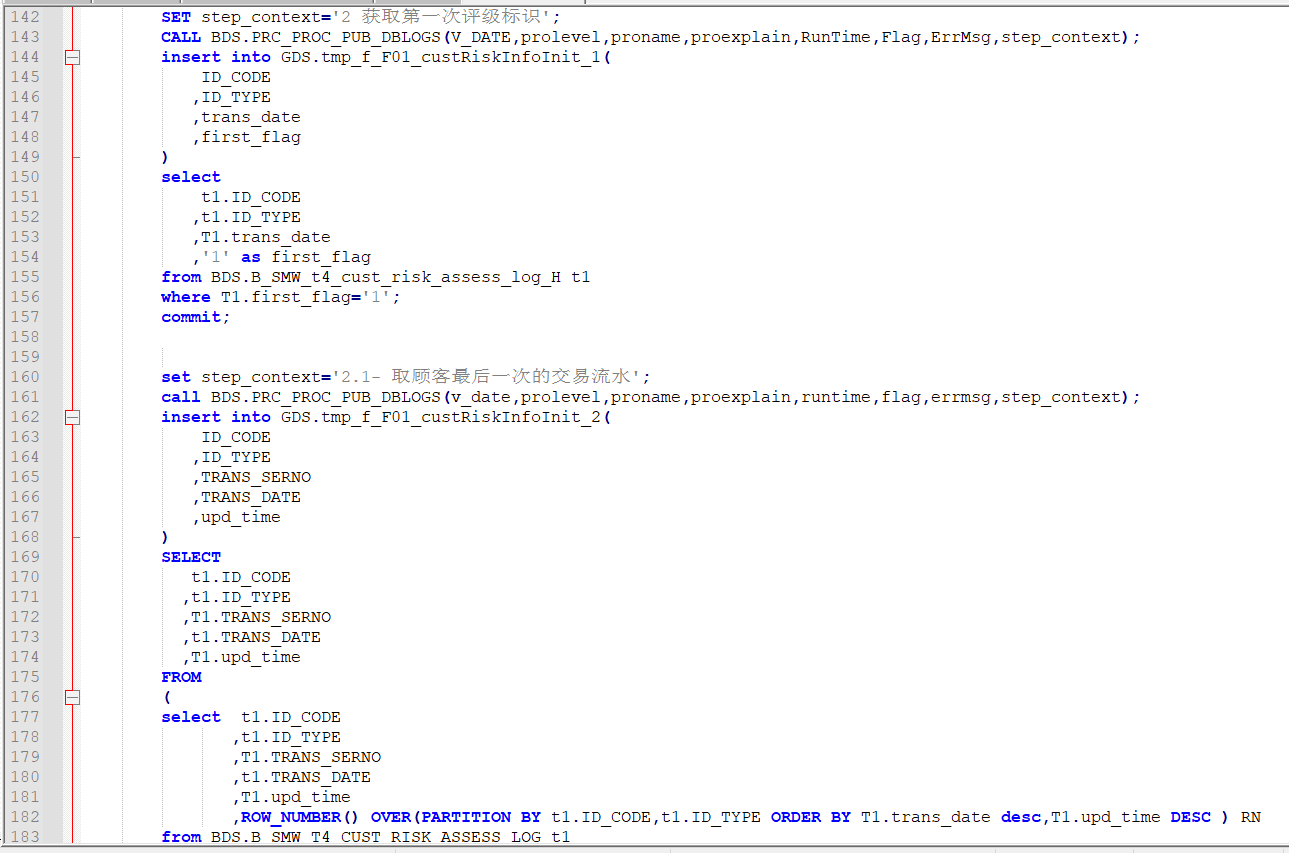
图 2|原始存储过程 PRC_1.sql
操作步骤
步骤 1 把 PRC_1.sql 文件放到工作目录的 sql 子目录中。
步骤 2 在 Trae 对话框中输入嵌入指令:
/SQLazy 嵌入 PRC_1.sql
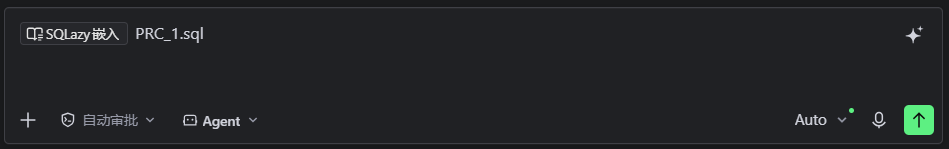
图 3|在 Trae 中输入 /SQLazy嵌入 命令
步骤 3 等待 AI 提示。AI 会按照如下步骤自动执行:
· 分析存储过程,识别其中有哪些 SQL 段需要转成 SQLazy 代码段;
· 根据剥离出来的待转化代码段,先造测试数据;
· 测试数据同步插入数据库和内存库;
· 提示内存库已建好,请你在 SQLazy IDE 中打开内存库,并等待回复。
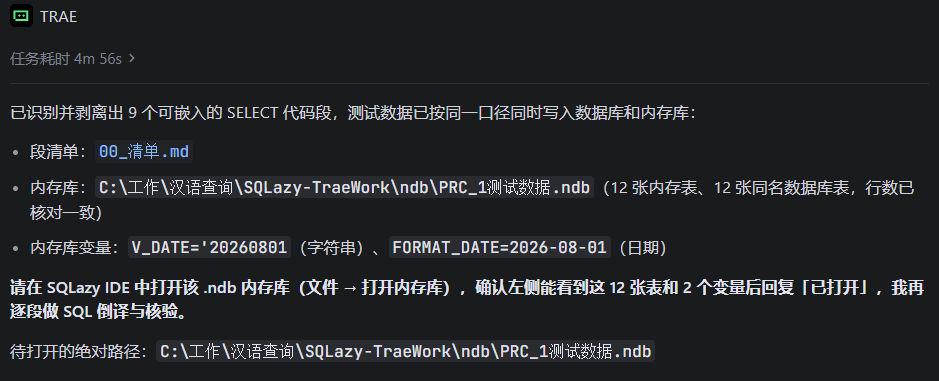
图 4|AI 提示打开内存库的界面
步骤 4 在 SQLazy IDE 里打开内存库,回到 Trae 界面回复"已打开"。
步骤 5 AI 继续往下执行,逐段翻译 SQL,并把翻译后的 SQLazy 代码段插入到存储过程中,执行结束后给出嵌入版文件名:
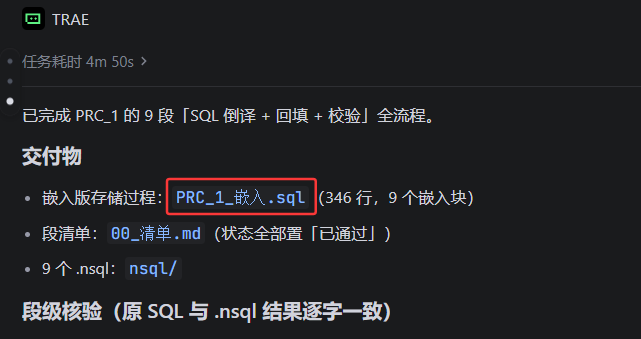
图 5|AI 输出嵌入结果与嵌入版文件名
步骤 6 打开嵌入版存储过程检查,计算部分已经成为可读的 SQLazy 代码段:(其中\和\\之间的部分)
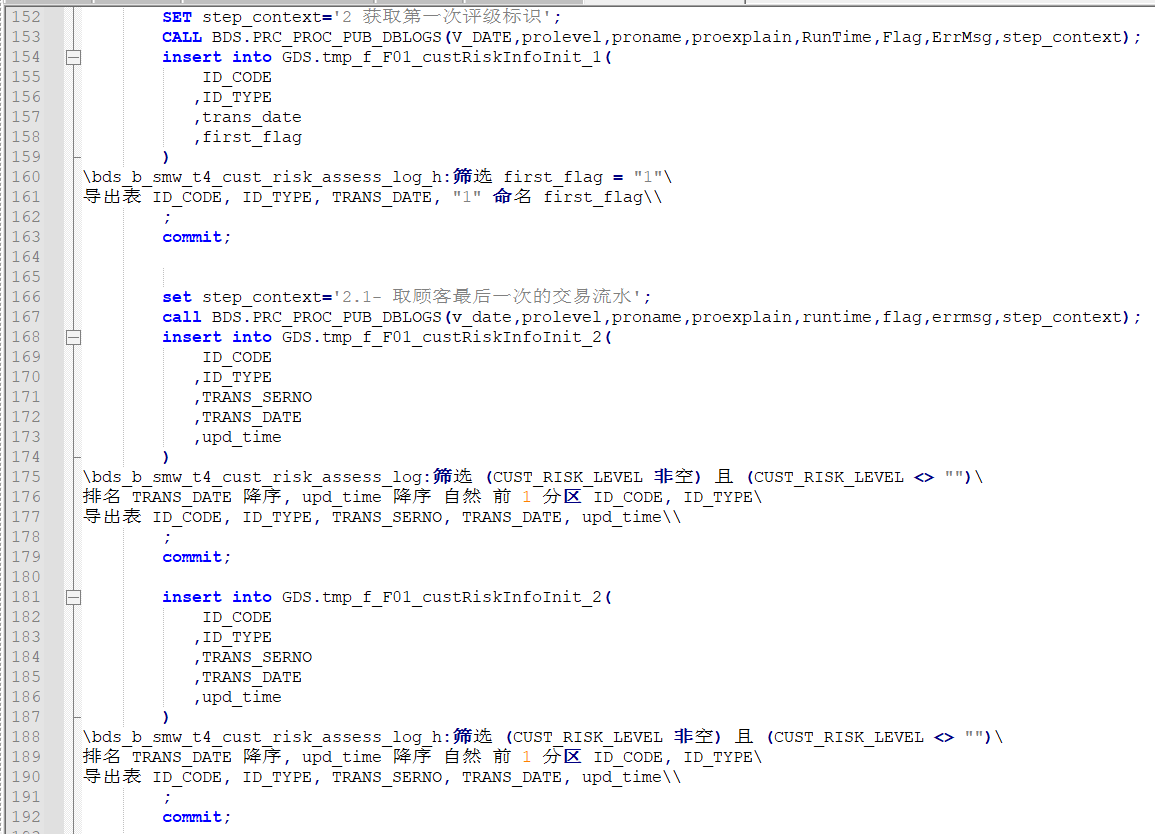
图 6|嵌入 SQLazy 代码段后的存储过程
轻量参与 整个过程你只需要做两件事:把文件放好、回复一句"已打开",其余工作全部由 AI 自动完成。 |
六、实战二:编译含 SQLazy 代码段的存储过程
嵌入完成后,就可以把 SQLazy 代码编译回存储过程,完成第 2 步"编译回写":
在 SQLazy IDE 中打开内存库,点击【程序 / 编译存储过程】,打开嵌入版文件 PRC_1_嵌入.sql,全选拷贝,粘贴到界面中:
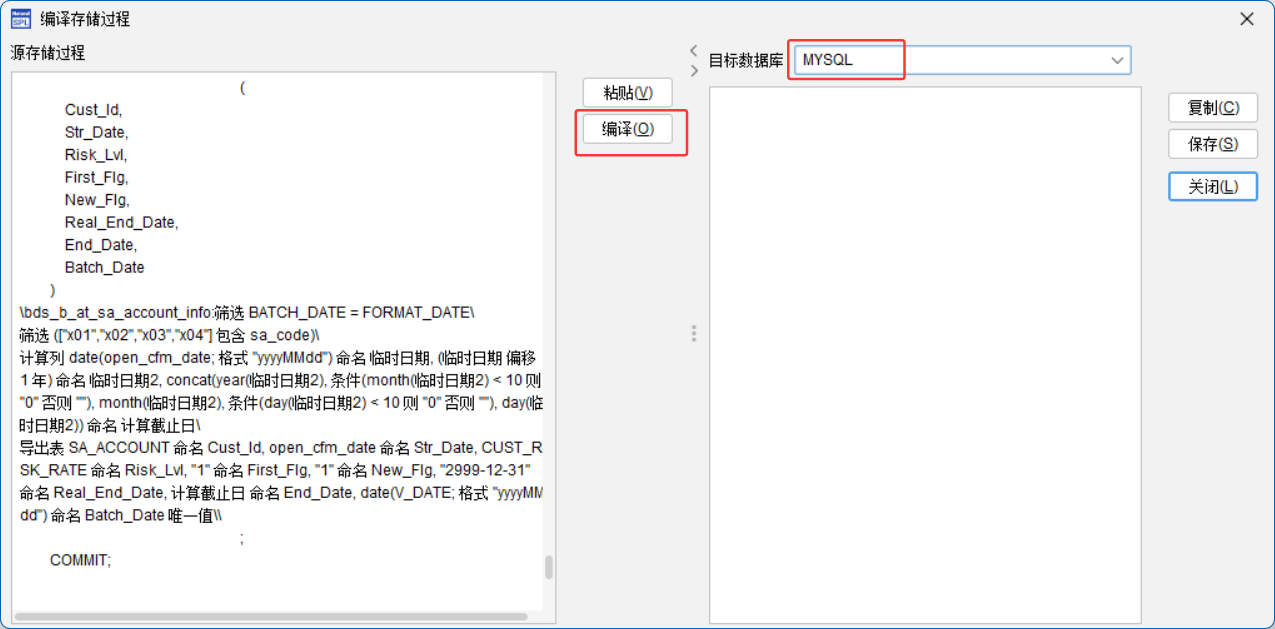
图 7|在 SQLazy IDE 中粘贴嵌入版存储过程进行编译
编译结果可以保存成文件,再自行调试:
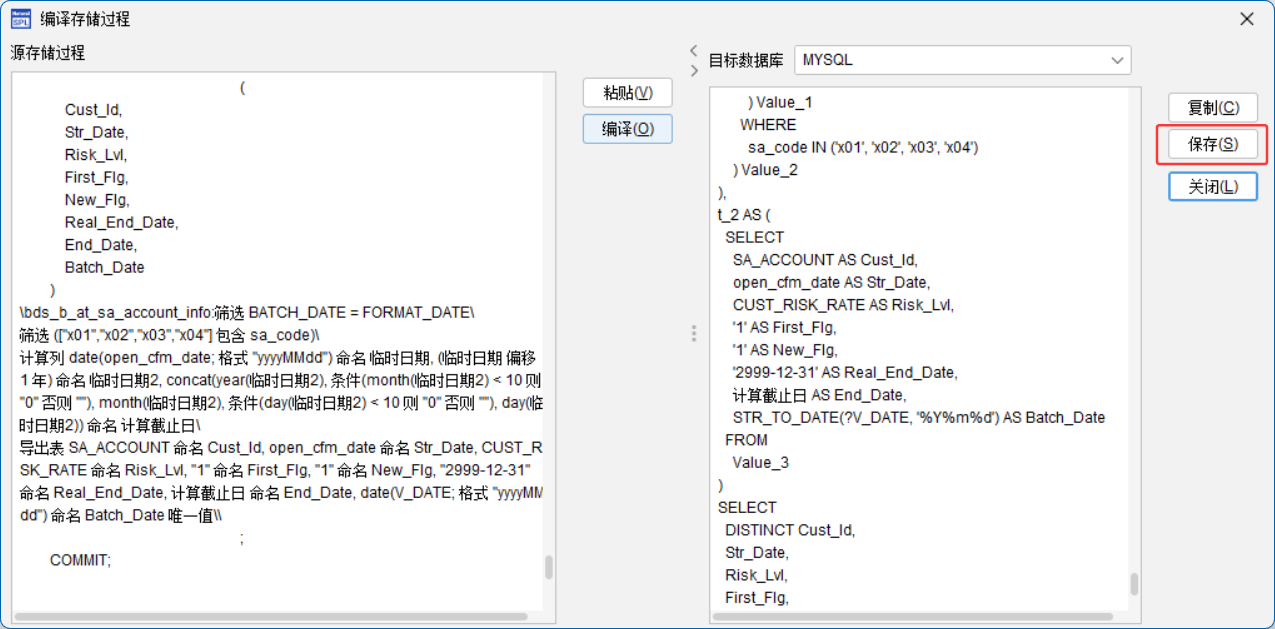
图 8|保存编译结果,继续调试
这一步的意义 编译回写后,存储过程即可在原数据库中直接运行;而其中最难读懂的计算部分,已经变成了随时可以查看、修改的 SQLazy 资产。读懂与维护的难题就此解决。 |
七、实战三:sqltospl——一次改造,跨库运行
当目标数据库不支持存储过程时,使用 sqltospl 技能,把含 SQLazy 代码段的存储过程进一步改写成 SPL + SQLazy 代码,实现"一次改造,所有数据库可运行"。
步骤 1 在 Trae 对话框中输入:
/sqltospl PRC_1_ 嵌入.sql
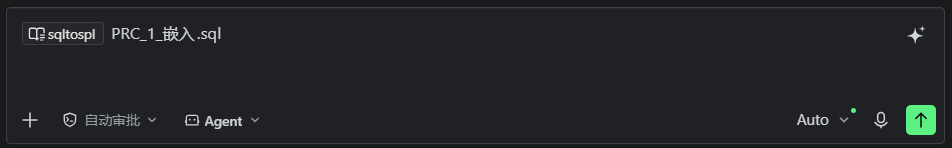
图 9|在 Trae 中输入 /sqltospl 命令
步骤 2 AI 执行结束后,会打印出结果 .spl 文件名:
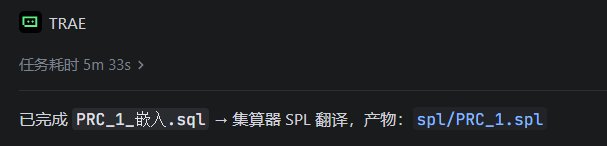
图 10|AI 输出 .spl 结果文件名
步骤 3 用集算器打开 spl 文件,连接数据库,执行:
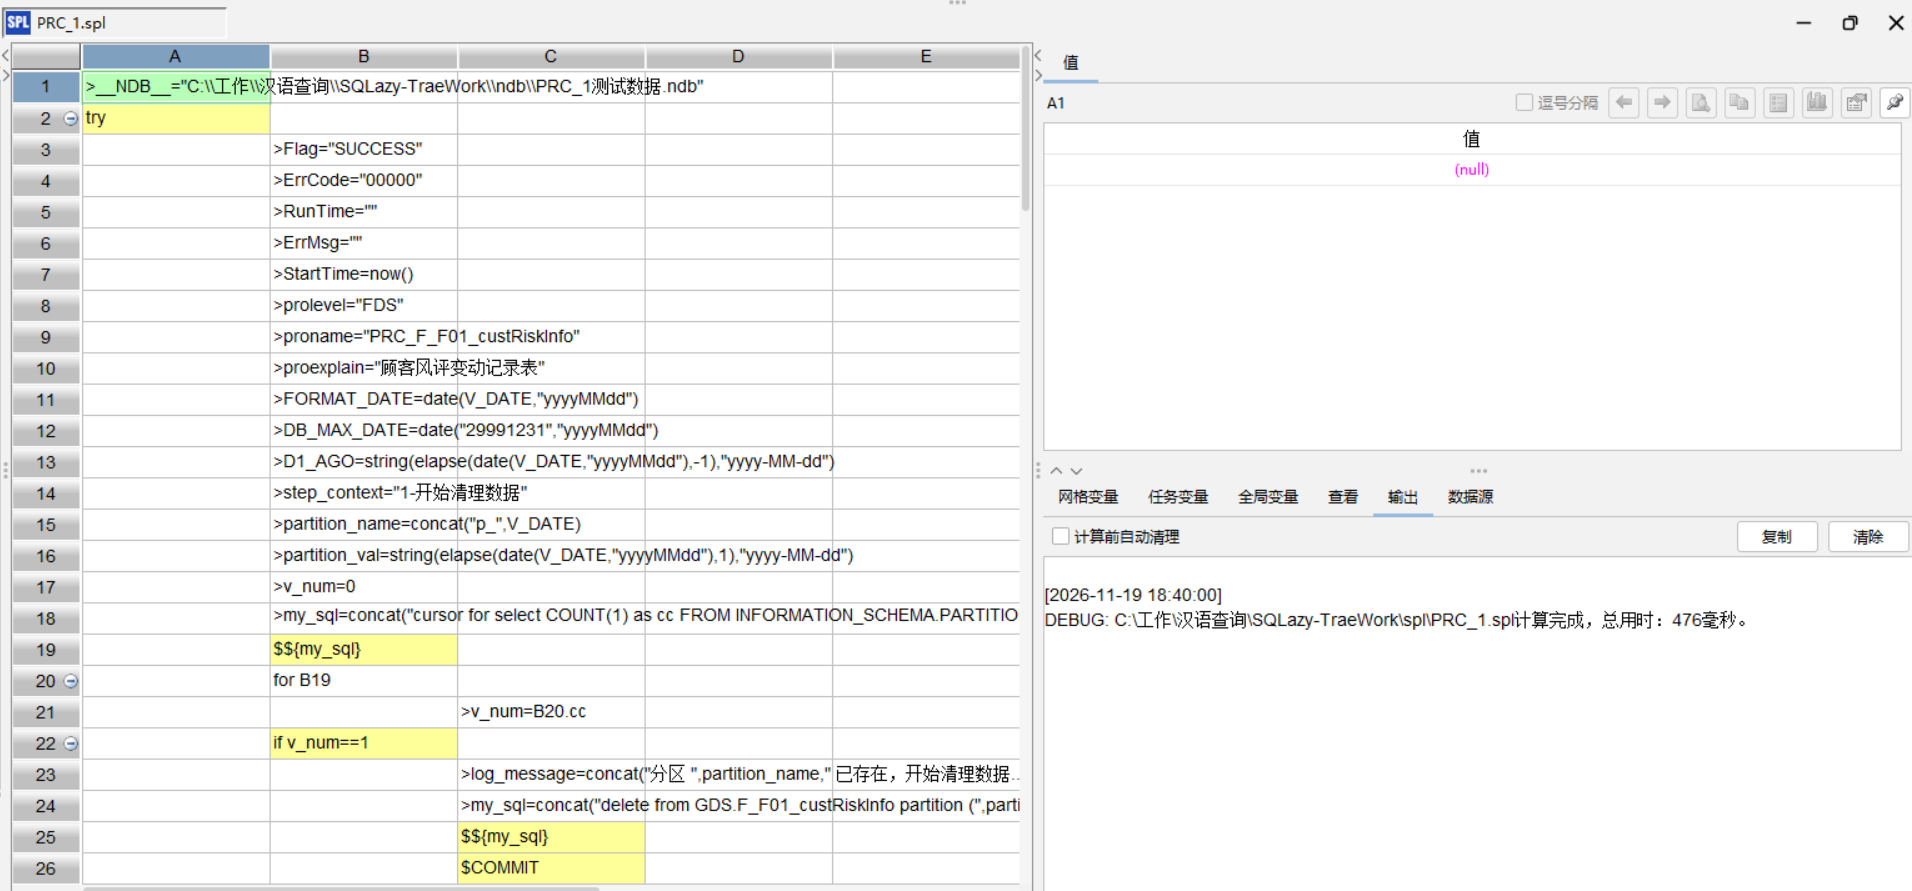
图 11|集算器中执行 spl 文件,全部执行正确
至此,全部执行正确——原来绑定在特定数据库上的业务逻辑,已经变成了可以跨数据库运行的 SPL + SQLazy 资产。
八、SQLazy 技能速查表
除了本文实战中用到的两个技能,SQLazy 还提供一组配套技能,覆盖存量改造的完整链路。在 Trae 对话框中以斜杠命令方式触发即可:
技能 |
触发命令 |
适用场景 |
SQLazy嵌入 |
/SQLazy嵌入 存储过程.sql |
把存量存储过程中的 SQL 段剥离、翻译成 SQLazy 代码段,并回嵌生成嵌入版存储过程(实战一) |
编译回写 |
SQLazy IDE【程序/编译存储过程】 |
把嵌入版存储过程编译回可运行的存储过程(实战二) |
sqltospl |
/sqltospl 嵌入版.sql |
把含 SQLazy 嵌入段的存储过程翻译成集算器 SPL 明文代码,实现跨数据库运行(实战三) |
SQL倒译 |
/SQL倒译 |
把一段原生 SQL 或带详细描述的需求,转换为等价的 SQLazy .nsql 脚本并校验 |
SQLazy规划 |
/SQLazy规划 |
从业务需求出发,生成全新的 SQLazy .nsql 脚本,或对已有脚本续调、调整 |
生成测试用例 |
/生成测试用例 |
为 SQLazy .nsql 脚本或数据库表生成测试数据(.ndb 内存库),为验证做准备 |
上手建议 推荐按"嵌入 → 编译回写 → sqltospl"的顺序完成第一次全流程实战(即本文实战一至实战三),再按需使用 SQL倒译、SQLazy规划、生成测试用例处理日常的 SQL 改写与数据准备。 |
九、写在最后
存量存储过程的价值不应该被"读不懂"埋没。借助 Trae + SQLazy:
· 读懂——计算部分变成逐行可见结果的中文代码,人人可读;
· 维护——在 SQLazy 资产上修改业务逻辑,改完编译回写即可验证;
· 迁移——核心计算部分无需迁移,或直接转成跨库运行的 SPL + SQLazy 代码;
· 可靠——AI 全程参与,但每一步都有测试数据与可核对的中间结果,正确性由人把关。
环境准备十分钟,三组实战跟着做一遍,你就完成了第一个存量存储过程的资产化改造。让沉淀多年的存量资产重新"活"起来,就从现在开始。
相关资源:SQLazy IDE 官网下载 https://www.raqsoft.com.cn/download-SQLazy