
Trae+ 润乾 NLQ 开发智能问数应用的实践
本文介绍了用润乾NLQ 中的 NLQPRE MCP,辅助智能问数部署的过程。这里使用 Trae 作为智能体,使用 nlqpre 技能,从基础数据源出发,从零开始构建智能问数所需的元数据和汉语词典,同时针对实际数据生成测试例句。经过技能中的调优处理,通过对元数据和汉语词典的修改,使得所有的例句均能够得到正确的查询结果。
1 NLQPRE MCP 及 SKILL 说明
1.1 NLQPRE MCP 的启动和配置
润乾NLQ 的 IDE 中集成了 MCP 服务,它可以与 AI 智能体连接,实现 lmd 元数据文件、nlq 词典文件的验证,以及查询测试的功能。使用这个 MCP 服务,可以辅助处理智能问数的上线准备。
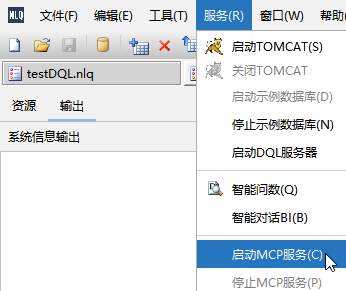
在汉语查询(NLQ20260916 或更新版本)的 IDE 界面中:点击 服务 -> 启动 MCP 服务,即可以启动集成的 MCP 服务:
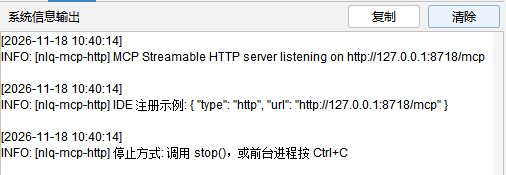
成功启动时,能看到弹窗提示,同时可以在系统消息输出中看到MCP 启动的相关信息:
MCP 提供三个基本工具:
工具名 |
说明 |
save_json |
上传json格式的相关配置文件,分为两种模式:lmd元数据文件或者nlq词典文件,参数依次为应用名称和文件全路径,文件类型根据扩展名是lmd或者nlq来区分。 |
load_query_service |
加载查询服务,服务会加载最后上传成功的lmd和nlq文件。需要上传的参数包括应用名称和服务配置信息。服务配置信息包括初始数据源配置信息以及查询服务的用户名和密码。 |
query_by_nl |
查询服务启动后,可以用自然语言测试查询结果。这个接口用作测试查询,会返回最多前10条数据以及结果集总数据条数。 |
nlqpre SKILL 将在智能体中,根据用户提供的任务信息,自动连接 MCP 并按进程自动生成参数,调用需要工具。
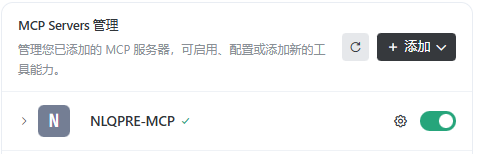
在TRAE 配置名为 NLQPRE-MCP 的 MCP 连接:
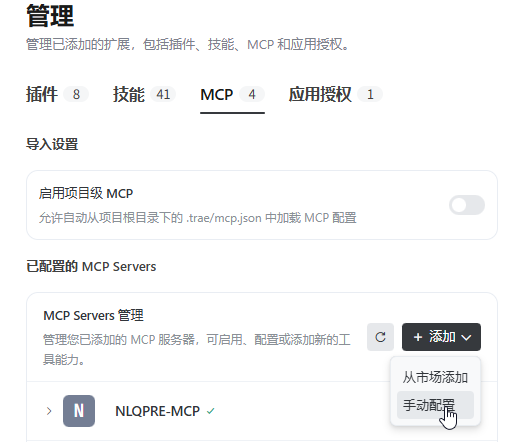
配置信息如下:
{
"mcpServers": {
"NLQPRE-MCP": {
"url": "http://127.0.0.1:8718/mcp"
}
}
}
默认的MCP 服务名称为 NLQPRE-MCP,如果改变这个名称,则需要修改技能中有关 MCP 名称的信息。配置成功后,如果能正常连接,右侧将显示为绿色:
1.2 nlqpre SKILL 在 TRAE 的安装
1.2.1 技能包信息
在润乾报表(含NLQ 查询的版本)中,[产品路径]\report\prompts\nlq下找到文件nlqpreskill.zip,内容如下:
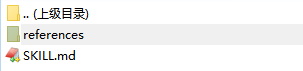
在nlqpre 路径中为技能使用的所有文件,SKILL.md 为技能主文件:
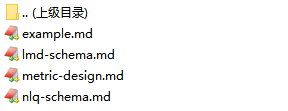
在references 路径中则为技能相关文件:
即可用这个压缩包在豆包中安装技能。
1.2.2 在 TRAE 中使用任务安装技能
在TRAE的侧边栏中选择「新任务」:
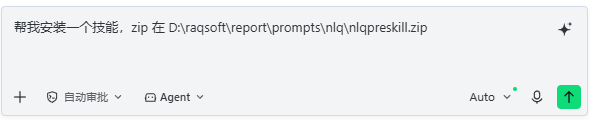
在任务描述中输入:帮我安装一个技能,zip 在 D:\raqsoft\report\prompts\nlq\nlqpreskill.zip,安装后技能名叫 nlqpre。
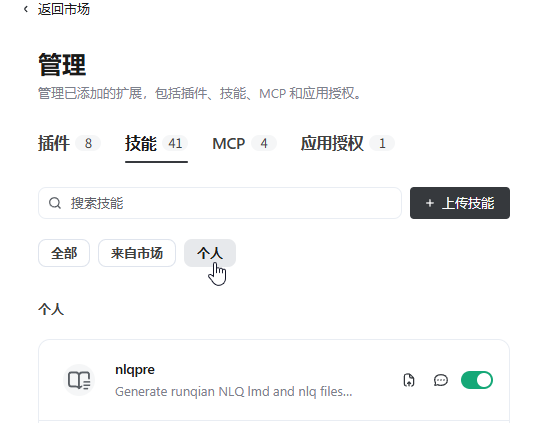
等TRAE 安装技能成功后,通常会需要重新启动 TRAE。在重启后,点击「插件市场」→「管理」→「技能」→「个人」,既可以看到新的技能:
1.3 SKILL 文件体系
技能目录建议按以下结构组织:
Nlqpre
├── SKILL.md # 主技能文件(触发词、流程、规则)
└── references/
├── example.md # NLQ 例句 HTML 生成模板
├── lmd-schema.md # lmd 元数据文件格式说明
├── metric-design # 聚合指标的生成规则与方案
└── nlq-schema.md # nlq 词典文件格式说明
2 nlqpre SKILL 的应用流程
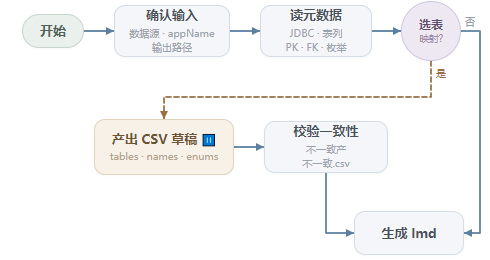
2.1 流程图
A. 任务准备
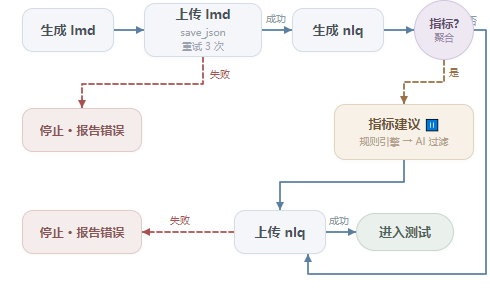
B. 文件生成和上传
C. 测试和调优
2.2 流程介绍
Step1:确认输入
获取任务信息,在最初的任务需求中,最基础的需求是提供初始数据库信息、应用名称、输出路径。同时还可以增加一些特别需求,包括从数据库中选表,设置映射信息,以及生成聚合指标。
数据源信息包括url、用户名、密码以及 JDBC 驱动文件,如果本地已有可以指明路径,否则 AI 会自行下载。
应用名称在MCP 生成查询测试时作为 DQL 服务名称使用,如果已存在则会覆盖已有的。已有的服务通常在[产品路径]\report\services下,MCP 生成测试查询服务时也会在这里。
输出路径用来存储智能体输出的各类文件,如果需要查看lmd 或者 nlq 文件,也建议在输出路径。
如果任务提示词中要求选表,在技能处理流程中可以选择在智能查数中使用哪些表;否则会选择数据源中的全部表。
如果任务提示词中要求设置映射初始信息,在技能处理流程中可以设置表、字段和常数词等对应哪些初始的词;如果未设置则这些词由AI 自动生成。
如果任务提示词中要求生成聚合指标,则会根据选用表的情况,生成聚合指标;如果未设置则不会生成聚合指标。
Step2:获取数据库元数据(AI 自动执行)
AI 用 JDBC 连接初始数据库,读取表名、字段、主键、外键、枚举值等信息。
Step3:用户设置选表及映射(选表及设置映射时执行,不需要则跳过)
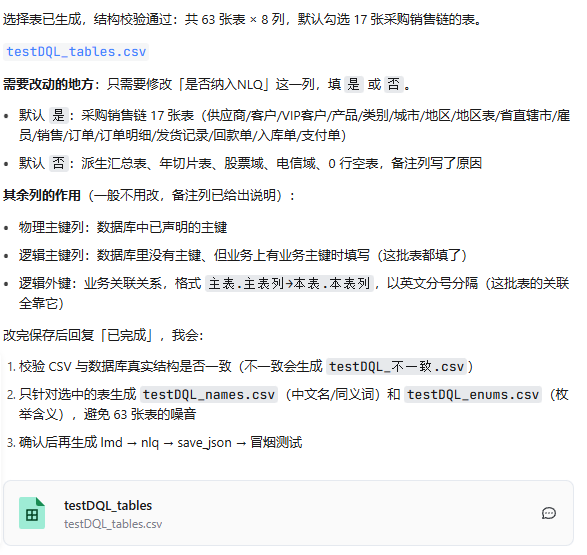
AI 根据 step2 的结果,在输出路径下,生成 xxx_table.csv,xxx_names.csv,xxx_enums.csv 三个文件的草稿,并暂停等待用户编辑后确认继续。
编辑tables.csv 可设置需要选用哪些表,在表名后设置是否使用。编辑 names.csv 可设置表名和字段名对应的初始名称,如“EMPID”需要识别为“员工号”,“雇员编码”等。编辑 enums.csv 可设置枚举型常数词的城市名称,如“北京”需要识别为“北京”,“北京市”,“首都”等。
用户编辑完成后,选择继续执行任务或输入”已完成“。
用户输入后,AI 将判断输入的合法性,如果有问题则会要求修改后继续。
Step4:生成 lmd 元数据文件(AI 自动执行)
AI 根据元数据生成json 格式的`<appName>.lmd`。如果执行了step3 则会参考设置的信息,否则会由 AI 自动分析。
Step5:上传 lmd 到 MCP(AI 自动执行)
AI 调用 MCP 的 save_json 上传 lmd 文件,如果上传未成功则判断问题,重新连接或者返回 step4 重新修改 lmd,如果执行失败超过 3 次则停止任务,提示错误信息要求用户修改;如果上传成功则继续执行。
Step6:生成 nlq 词典(AI 自动执行)
AI 根据元数据生成json 格式的`<appName>.nlq`。如果执行了step3 则会参考设置的信息,否则会由 AI 自动分析。
Step7:生成聚合指标(选择生成指标时执行,不需要则跳过)
AI 自动分析表中字段的信息,在输出路径中生成`指标建议.json`,用户可以修改或者增删需要添加的指标,确认后AI 将在 nlq 中增加指标信息。
Step8:上传 nlq 到 MCP(AI 自动执行)
AI 调用 MCP 的 save_json 上传 lmd 文件,如果上传未成功则判断问题,重新连接或者返回 step6 重新修改 nlq,如果执行失败超过 3 次则停止任务,提示错误信息要求用户修改;如果上传成功则继续执行。
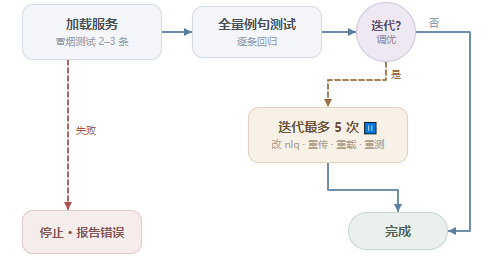
Step9:加载查询服务(AI 自动执行)
AI 调用MCP 的 load_query_service 加载查询服务,加载成功则执行冒烟测试,调用 MCP 的 query_by_nl 来查询几条基本语句,
如果查询服务加载失败或者冒烟测试失败,则停止任务并报告MCP 错误。
Step10:全量例句测试 + 生成 HTML 报告(AI 自动执行)
AI 自动生成 30-50 条例句,例句包括单表查询、实体计数、维值过滤、数值条件、聚合、日期条件、复合条件等,如果 nlq 中生成了聚合指标还会生成指标对应例句。
根据例句测试结果,AI 会输出 HTML 报告,报告中包括例句、执行情况以及总览信息。
Step11:迭代调优
上一步获得html 报告后,可以根据例句的执行情况,查看对应的 lmd 或者 nlq 提出修改建议,或者只要求 AI 去迭代尝试修改。迭代时 AI 会根据例句的错误信息,修改 nlq 中的设置,重新上传 nlq、重启查询服务后,再重测例句生成新的测试报告。
3 用 TRAE 开发 NLQ 查询的实践示例
下面用一个实际的例子来了解如何在trae 中使用 nlqpre 技能,准备 lmd 和 nlq 文件,以及基本例句。下面将按全部处理的流程来举例,如果不需要选表或者不需要生成聚合指标,则会跳过相应步骤。
3.1 任务准备
Step1:确认输入
输入:数据源url:jdbc:hsqldb:hsql://127.0.0.1/dqldemo,用户 sa,无密码,驱动用 hsqldb-2.7.3。以这个数据源为基础,生成 lmd 和 nlq 文件,应用名称名称是 testDQL。需要选表、设置映射初始信息,以及生成聚合指标。
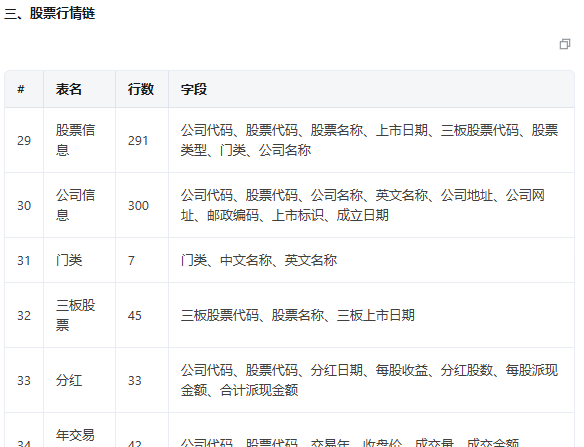
Step2:获取数据库元数据
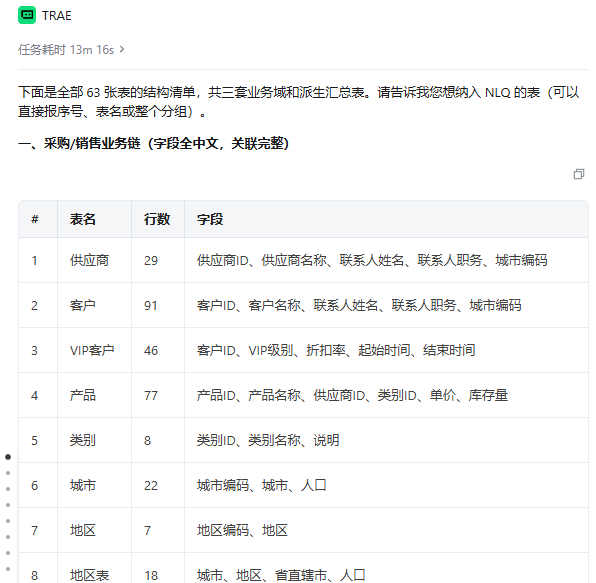
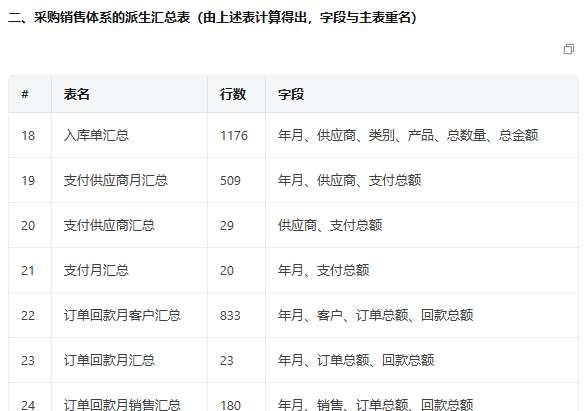
Step3:用户设置选表及映射(选表及设置映射时执行,不需要则跳过)
通过编辑这个文件,可以选择使用哪些表来执行。提交后,会继续生成映射文件,如果不需要改变,则可以直接继续。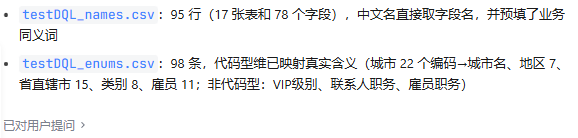
选择表后,在输出路径下会生成中文名映射的初始文件,可以按照需要修改初始映射值,如果不修改,或者最开始未选择处理映射,则全部自动生成。
3.2 文件生成和上传
Step4:生成 lmd 元数据文件
Step5:上传 lmd 到 MCP
Step6:生成 nlq 词典
Step7:生成聚合指标(选择生成指标时执行,不需要则跳过)
如果lmd 或者 nlq 上传到 MCP 时出现问题,则会修改后重新上传。nlq 初步生成后,如果选择了生成指标,则需要用户确认指标信息后继续。指标建议文件如下:
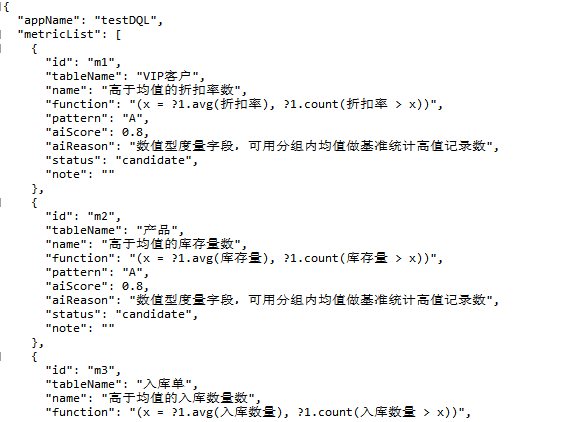
自动生成的指标中已自动生成指标函数,如有增删或者修改需要,则修改后继续即可。
Step8:上传 nlq 到 MCP
完全生成nlq 后会自动上传到 MCP。
3.3 测试和调优
Step9:加载查询服务
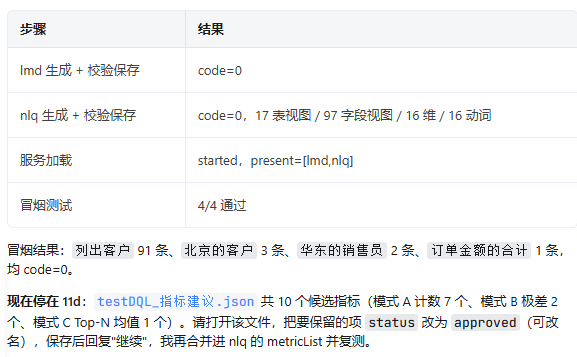
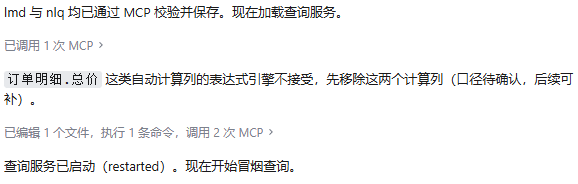
在lmd 和 nlq 成功上传到 MCP 后,SKILL 会自动启动 MCP 中的查询服务,并在通过冒烟测试后,开始生成测试例句并分析结果。

Step10:全量例句测试 + 生成 HTML 报告
Step11:迭代调优
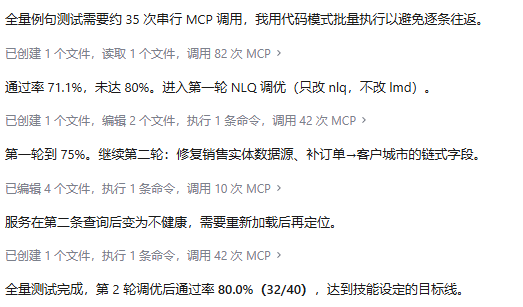
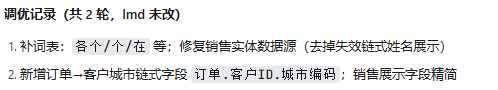
例句测试时,如果通过率不足会自动执行调优,这种规则也可以自行设置。
根据人工查看当前的nlq 词典,可以更准确地定位例句的错误信息,输入后可让 AI 继续修改测试。
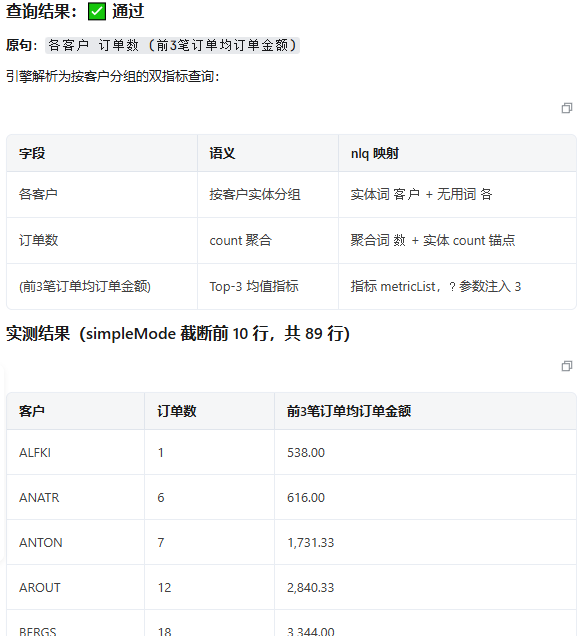
测试完成后,在TRAE 中也可以用”查询:“开头,再输入所需查询的复杂例句,进一步验证查询结果,如输入”查询:各客户 订单数 (前 3 笔订单均订单金额),结果如下:
3.4 测试报告
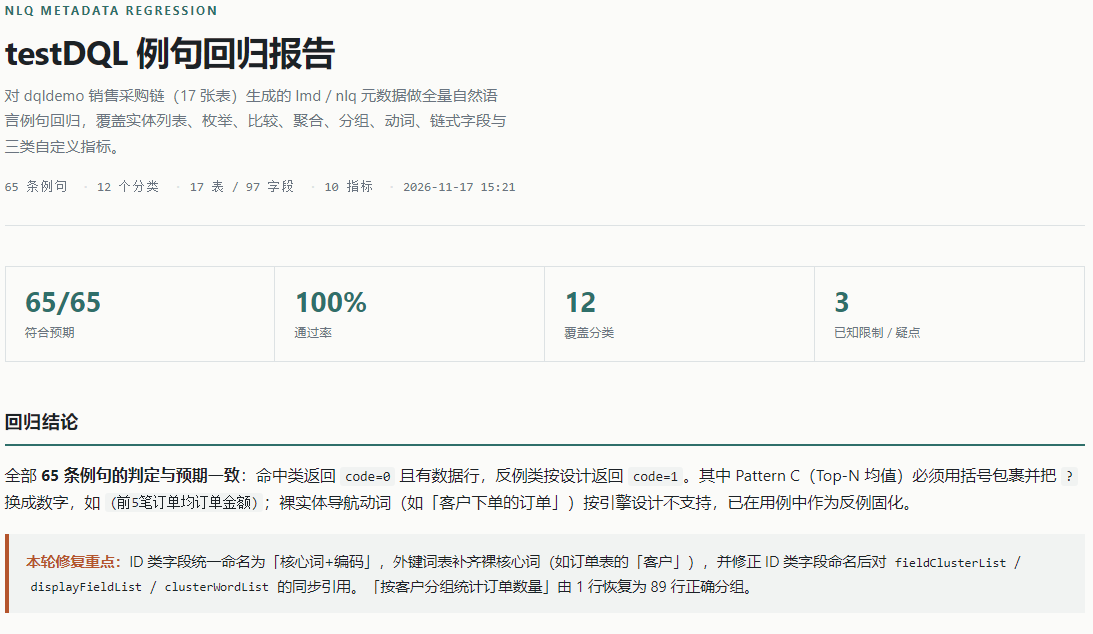
等调优结果满意后,可以查看最终的测试报告:
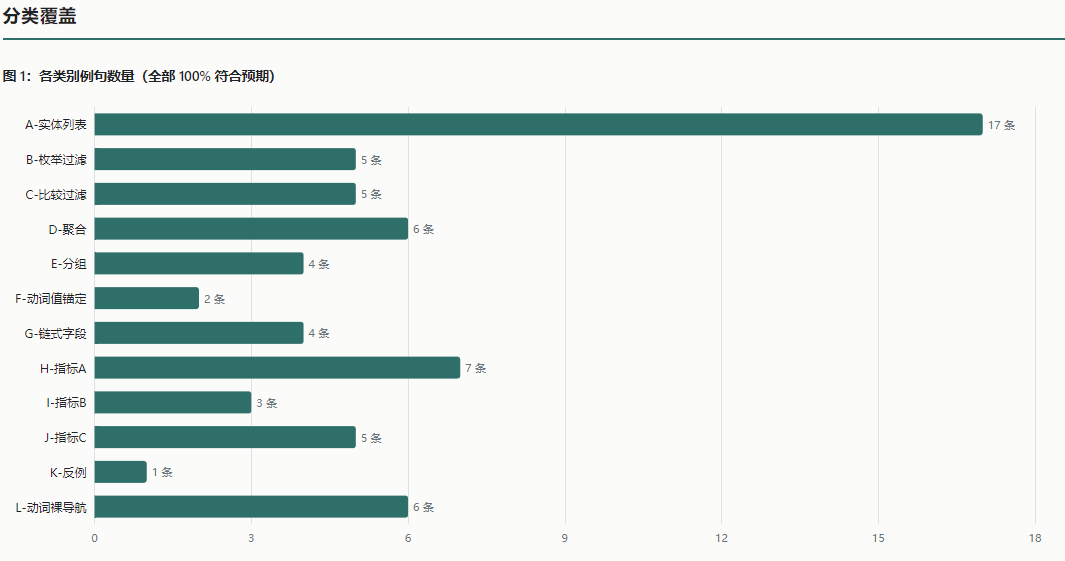
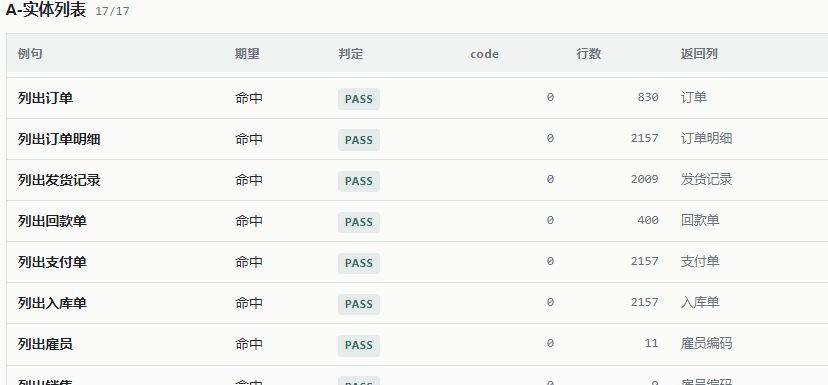
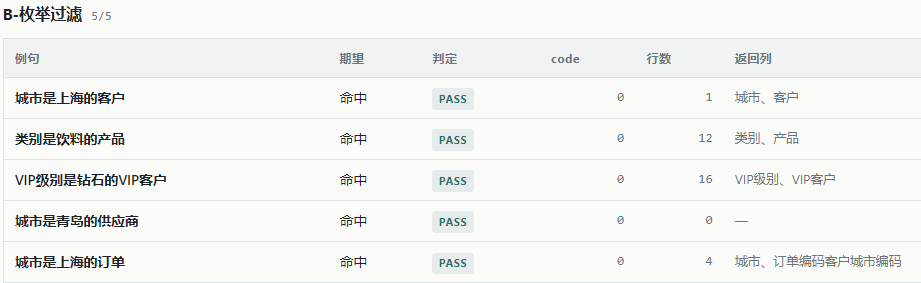
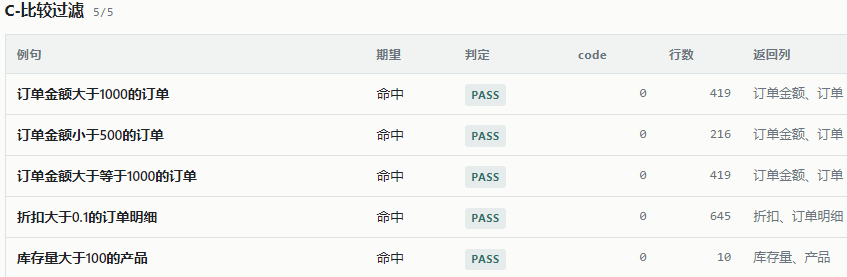
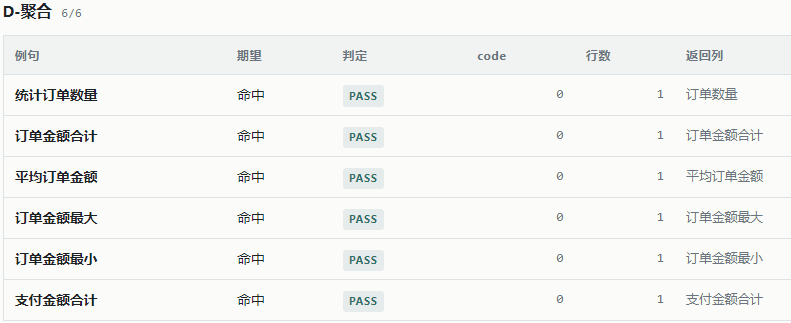
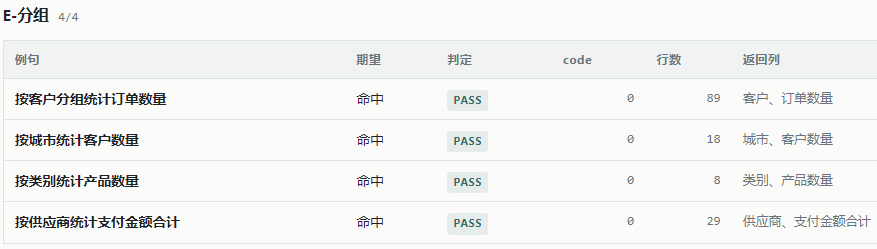
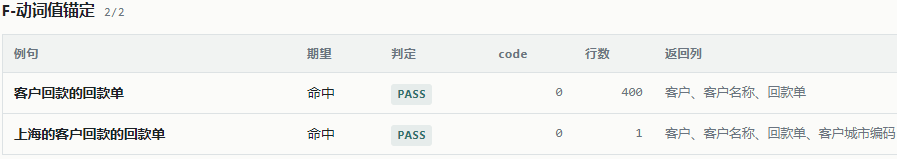
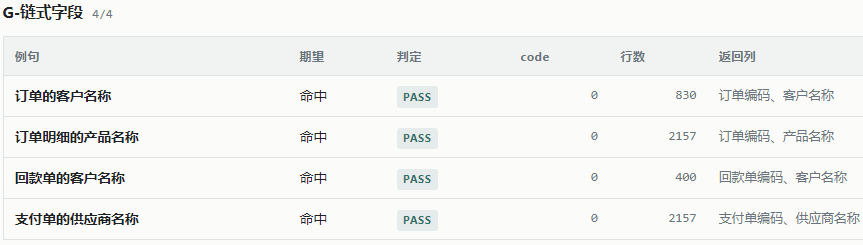
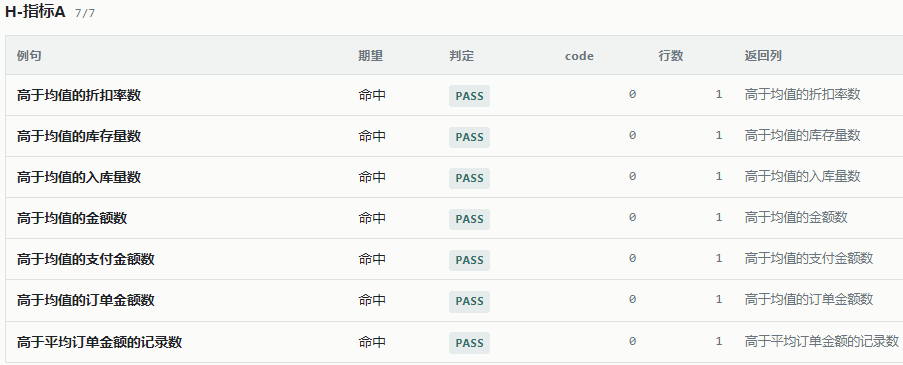
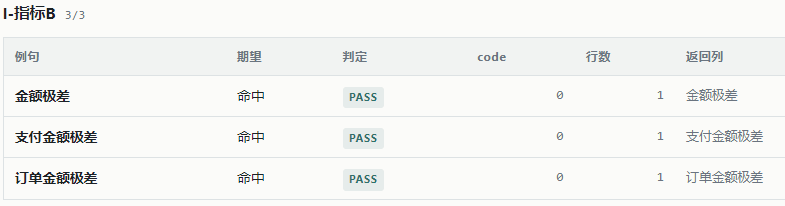
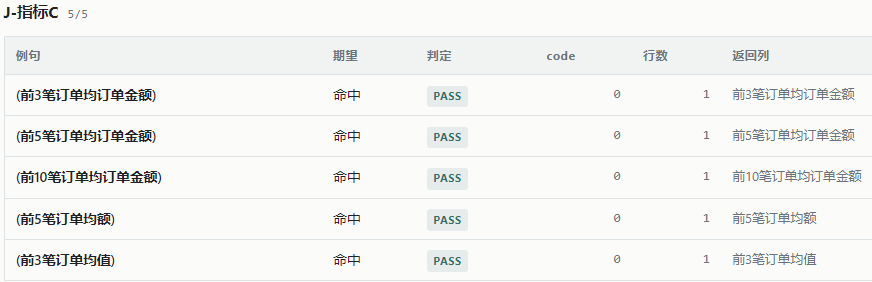
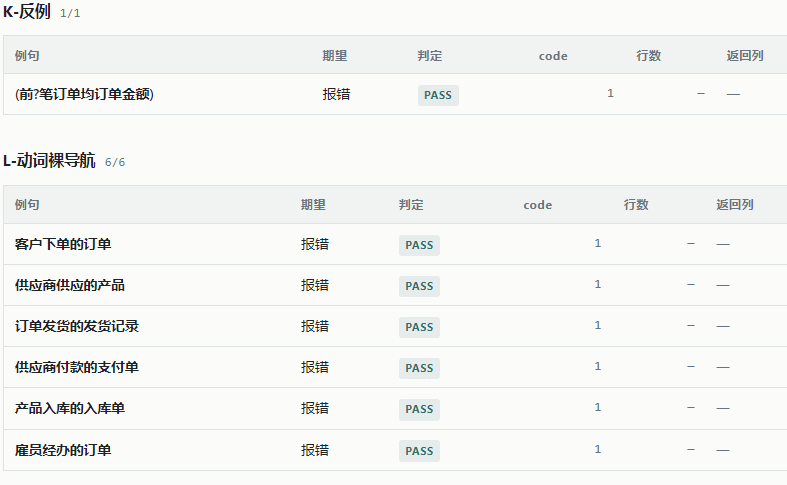
可以看到,例句中除了各类查询例句、指标相关例句之外,还会测试一些期待失败的错误查询。
3.5 任务总结
根据数据复杂程度和调优的执行轮数,全任务耗时大概在2~4 小时。
在这个实践示例中,虽然选择了“选表”和“设置映射”的环节,但是都是使用 AI 推荐的设置,如果需要人工处理,则需要在相应的步骤对 tables.csv,names.csv,enums.csv 和指标建议.json 编辑修改。
在测试和调优阶段,如果查看生成路径中的nlq 文件,针对每一轮的测试报告中的错误例句,提出有效的修改意见,如“缺少某个词”等,可以有效提升调优效率。
此时,输出路径中的lmd 文件和 nlq 文件,即可用于部署智能查数的服务。
本例中,最终共使用了17 个表,生成了 97 个字段(包括跨表宏字段),10 个聚合指标。共生成各类词,包括表词、字段词、指标词等,超过 500 个。共生成各类例句 65 条,调优后全部符合预期结果。