
在 SQL 中掌握金融时间序列:不用存储过程的会话化、缺失与连续区间
金融时间序列的计算,通常不是简单的 SQL 查询。常见的有三类:账户的交易流水要按时间间隔切成会话;股票停牌那几天缺失的价格要补上;收盘价序列要找出连续上涨最长的一段。三类计算在 SQL 里有一个共同点:过程中都会产生中间状态,如会话分组、填充值来源、区间编号,而这些中间列最终不会出现在结果里。
中间状态必须有地方存放。常见的做法是写存储过程或建临时表,先把中间结果保存下来,再逐步加工。这种做法本身没有问题,只是中间状态被锁在过程里:改动一个条件,就要把整段过程重新读一遍,也无法停在中间某一步核对结果。本文采用另一种做法。三个金融时间序列的例子都无须存储过程和临时表,而是用若干条可读的步骤把中间状态保留在结果表中,每一步都能单独执行、单独核对,最后由编译器生成原生 SQL。
当然,这类逻辑用现代 AI 也能直接写成一条 SQL。但无论人写还是 AI 生成,语句都会过于复杂,很难审计确认其正确性,出了错也不好调试。可见难点不在编写,而在能否被低成本审计和核验。改用步骤化方案后,不仅方便分析人员做审计检验,也更有利于 AI 生成。
会话化:一条交易流水,什么时候算一段
第一类是会话化。一张交易活动表记录账户和交易时间,要求按账户把交易切成会话:与上一笔间隔不超过一小时的,属于同一会话;超过一小时的,另起一段。除会话号外,还要给出会话内的序号。
用 SQL 实现的常规写法如下:
SELECT account, trade_time, session_id, seq
FROM (
  SELECT account, trade_time, session_id
    , ROW_NUMBER() OVER (PARTITION BY account, session_id ORDER BY CASE
      WHEN account IS NULL THEN 1
      ELSE 0
    END, account ASC, CASE
      WHEN trade_time IS NULL THEN 1
      ELSE 0
    END, trade_time ASC, account) AS seq
  FROM (
    SELECT account, trade_time
      , 1 + SUM(CASE
        WHEN (prev_time + INTERVAL 3600 SECOND <= trade_time) THEN 1
        ELSE 0
      END) OVER (PARTITION BY account ORDER BY CASE
        WHEN account IS NULL THEN 1
        ELSE 0
      END, account ASC, CASE
        WHEN trade_time IS NULL THEN 1
        ELSE 0
      END, trade_time ASC ROWS UNBOUNDED PRECEDING) AS session_id
    FROM (
      SELECT account, trade_time
        , LAG(trade_time) OVER (PARTITION BY account ORDER BY CASE
          WHEN account IS NULL THEN 1
          ELSE 0
        END, account ASC, CASE
          WHEN trade_time IS NULL THEN 1
          ELSE 0
        END, trade_time ASC) AS prev_time
      FROM trading_activity
    ) sub__3
  ) sub__4
) sub__5
ORDER BY CASE
  WHEN account IS NULL THEN 1
  ELSE 0
END, account ASC, CASE
  WHEN trade_time IS NULL THEN 1
  ELSE 0
END, trade_time ASC, account
这段 SQL 可以正确执行,但同一个计算被拆进四层子查询:最内层用 LAG 取上一笔时间,向外一层按间隔累计出 session_id,再向外一层用 ROW_NUMBER 编出 seq,最外层只挑出四列并排序。会话号是中间列,边界条件写在 CASE 中。要确认某个账户的边界是否正确,只能拿最终结果对照原始数据逐条回推;改动阈值后,四层都要重新验证。
中间状态不可见,就无法在过程中确认。分步写法换了一种思路:让中间状态成为结果表中实际存在的列,而不是藏在子查询或临时表里。下面三个例子都用 SQLazy 实现,它的作用是把逻辑拆成有顺序的步骤,每一步都能单独执行、单独查看结果。
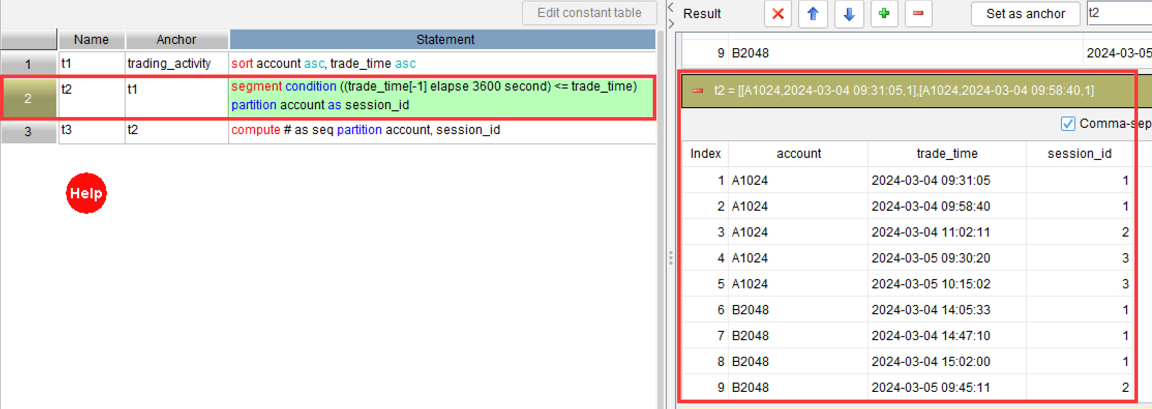
会话化在 SQLazy 中写成三步:
Name |
Anchor |
Statement |
trading_activity |
sort account asc, trade_time asc |
|
segment condition ((trade_time[-1] elapse 3600 second)<= trade_time) partition account as session_id |
||
compute # as seq partition account, session_id |
第一步,sort account asc, trade_time asc,把焦点表按账户和时间排序。后面所有相对位置的写法都依赖这个顺序,因此排序必须放在第一步。
第二步是核心。segment 按顺序给记录编组号,条件成立时组号加一。这里用的是条件表达式:trade_time[-1] 表示上一行的时间,方括号加负数即相对位置;elapse 3600 second 把上一行的时间向后推一小时;整个条件判断的是“上一行时间加一小时”是否不超过本行时间。<= 表示刚好间隔一小时仍属同一段,若写成 <,边界上的记录就会被切成新会话。partition account 让不同账户各自独立编号,互不影响。这一步的结果是每个会话得到一个 session_id。
第三步,compute # as seq partition account, session_id,计算会话内的序号。# 是行号列,按账户和会话分区后,每个分区内的行号从 1 重新开始,即所需的序号。
此时 session_id 和 seq 都是结果表中的实际列,可直接查询核对。用数据检查边界,比如账户 A1024 的前两笔为 09:31:05 和 09:58:40,间隔不足一小时,同属会话 1;下一笔 11:02:11 距 09:58:40 已超过一小时(09:58:40 加一小时为 10:58:40,早于 11:02:11),因此在此处开启第二个会话,seq 回到 1。账户 B2048 的 14:05:33、14:47:10、15:02:00 三笔间隔均在一小时以内,同属会话 1,seq 依次为 1、2、3。
这三步是给人读的,数据库仍需要 SQL,因此下一步是编译。编译器把这套步骤翻译成原生 SQL,目标库可选 Oracle、MYSQL、Hive 等,生成的 SQL 可直接执行;需要更换方言时,用同一段 SQLazy 再编译一次即可。
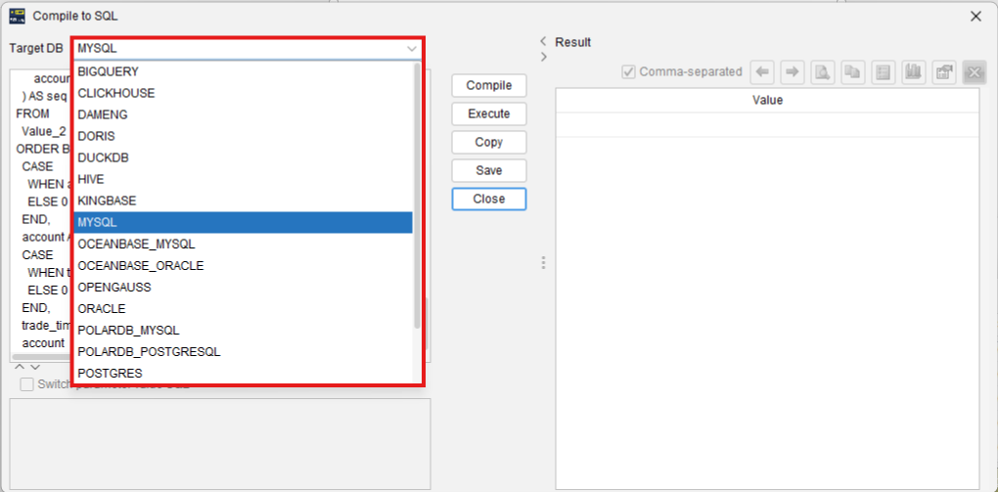
编译结果用 CTE 把中间结果分开,比上面那段多层嵌套的 SQL 清晰,也更容易修改。
WITH Value_2 AS (
    SELECT account, trade_time
      , 1 + SUM(CASE
        WHEN (col__2 + INTERVAL 3600 SECOND <= trade_time) THEN 1
        ELSE 0
      END) OVER (PARTITION BY account ORDER BY CASE
        WHEN account IS NULL THEN 1
        ELSE 0
      END, account ASC, CASE
        WHEN trade_time IS NULL THEN 1
        ELSE 0
      END, trade_time ASC ROWS UNBOUNDED PRECEDING) AS session_id
    FROM (
      SELECT Value_1.*
        , LAG(trade_time) OVER (PARTITION BY account ORDER BY CASE
          WHEN account IS NULL THEN 1
          ELSE 0
        END, account ASC, CASE
          WHEN trade_time IS NULL THEN 1
          ELSE 0
        END, trade_time ASC) AS col__2
      FROM Value_1
    ) sub__3
  )
SELECT account, trade_time, session_id
    , ROW_NUMBER() OVER (PARTITION BY account, session_id ORDER BY CASE
      WHEN account IS NULL THEN 1
      ELSE 0
    END, account ASC, CASE
      WHEN trade_time IS NULL THEN 1
      ELSE 0
    END, trade_time ASC, account) AS seq
FROM Value_2
ORDER BY CASE
  WHEN account IS NULL THEN 1
  ELSE 0
END, account ASC, CASE
  WHEN trade_time IS NULL THEN 1
  ELSE 0
END, trade_time ASC, account
缺失:停牌那几天,报价要接上来
第二类是缺失填充。行情表中,停牌或数据缺失的日期仍有记录,但价格为空。做时间序列分析前,需要用同一只股票上方最近的有效报价填充这些空值,即停牌期间沿用停牌前的最后一个价格。
用 SQL 实现的写法如下:
SELECT ticker, quote_date,
    MAX(close_price) OVER (PARTITION BY ticker, grp) AS close_price
FROM (
    SELECT ticker, quote_date, close_price,
        SUM(has_quote) OVER (
            PARTITION BY ticker ORDER BY quote_date
            ROWS UNBOUNDED PRECEDING
        ) AS grp
    FROM (
        SELECT ticker, quote_date, close_price,
            CASE WHEN close_price IS NOT NULL
                THEN 1 ELSE 0 END AS has_quote
        FROM quote_gap
    ) flag_rows
) grp_rows
ORDER BY ticker, quote_date;
同样是三层嵌套子查询:最内层判断报价是否为空,向外一层累计出分组号,最外层按分组取最大值回填。分组号 grp 是计算出来的,回填又依赖窗口最大值。某一天的空值使用了哪个报价,仅看这段 SQL 难以判断,需要拆分执行。
同一需求在 SQLazy 中是四步:
Name |
Anchor |
Statement |
quote_gap |
sort ticker asc, quote_date asc |
|
compute if((close_price notnull) then 1 else 0) cum as grp |
||
compute max close_price as filled_price; partition grp |
||
derive ticker, quote_date, filled_price as close_price |
第一步按股票和日期排序。ticker 不能省略:空值只能由同一只股票上方的报价填充,排序中包含股票代码,不同股票才不会混在一起。
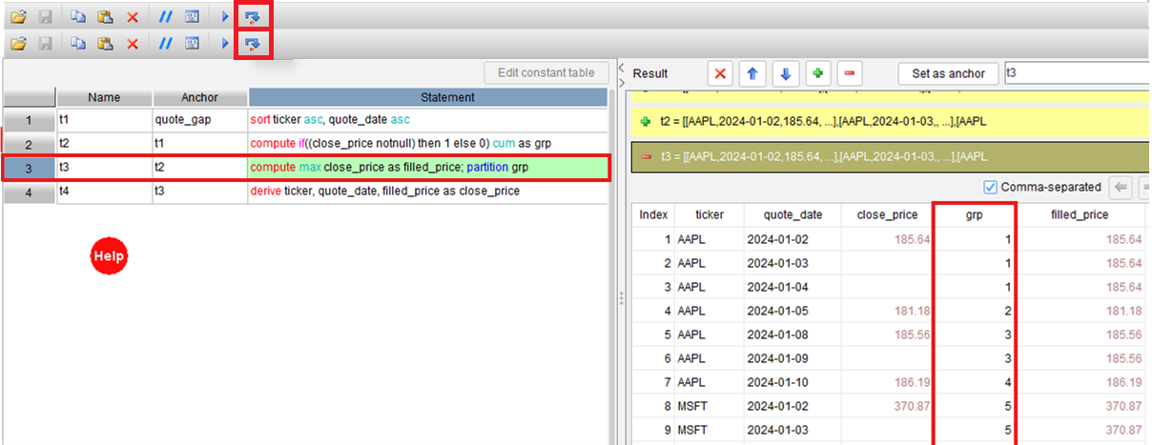
第二步生成分组标记。notnull 判断值是否非空,if 按判断结果返回 1 或 0,cum 表示累计计算,于是每个有效报价出现的位置都会把组号推进一格,其后的连续空值落入同一组。grp 是整个逻辑中最关键的中间状态,也是传统写法中最难验证的一列。
第三步,compute max close_price as filled_price; partition grp,在每个组内取收盘价最大值。组内只有第一条是有效值,其余为空,最大值即该组唯一有效的报价。
第四步把填充后的列改回原名,输出股票、日期和收盘价三列。
用数据核对,比如 AAPL 在 2024-01-03 和 01-04 两天的报价为空,落进同一个 grp,filled_price 均为 185.64;01-09 落在 185.56 那一组。哪个空值使用了哪个报价,查看 grp 和 filled_price 两列即可。这里的组号跨股票连续编号,MSFT 第一行接在 AAPL 之后,并非从 1 重新开始;由于回填时按 grp 分区,每个组只含一只股票,结果不受影响。
SQL 和存储过程在这类逻辑上都难以调试。中间结果要么在临时表中,要么被窗口函数包在子查询里,出现偏差只能修改整段代码并重新执行,观察结果是否变化。金融时间序列数据量大、边界多,反复尝试的成本更高。SQLazy 提供单步执行,点击一次执行一步,当前步骤和此前所有步骤的结果都可见,grp 在哪一行发生跳变可直接观察。
连续区间:顺序逻辑别压进嵌套
第三类是连续区间。一张行情表记录每只股票的每日收盘价,要求找出某只股票历史上最长连续上涨区间的起始日期和结束日期。需要注意,同样长的区间可能不止一段。
SQL 的写法如下:
with seq_calc as (
    select DT, CL,
        sum(UpDownTag) over(order by DT) NoRisingDays
    from (
        select DT, CL,
            case when CL>lag(CL) over(order by DT)
                then 0 else 1 end UpDownTag
        from stock
        where CODE = 100046
    ) tag_calc
),
streak_len as (
    select NoRisingDays, count(*) ContinuousDays
    from seq_calc
    group by NoRisingDays
)
select start_date, end_date
from (
    select NoRisingDays,
        min(DT) as start_date, max(DT) as end_date
    from (
        select DT, NoRisingDays
        from seq_calc
        where NoRisingDays in (
            select NoRisingDays
            from streak_len
            where ContinuousDays = (
                select max(ContinuousDays) from streak_len
            )
        )
    ) target_rows
    group by NoRisingDays
) agg_rows;
这段 SQL 用两个公共 CTE 把 lag 和累计的逻辑抽出来,这部分写法合理。问题在后半段:先要聚合出每段的长度,再与最大值比较,然后回到区间分组取首尾日期,中间套着几层子查询,NoRisingDays 和日期字段就这样逐层传递。若要在其中加入过滤条件,需要从内向外逐层梳理,确认每一层的语义没有被破坏。
同一需求在 SQLazy 中是六步:
Name |
Anchor |
Statement |
stock |
filter CODE = 100046 |
|
sort DT asc |
||
segment CL down as NoRisingDays |
||
compute count DT as ContinuousDays; partition NoRisingDays |
||
rank ContinuousDays max |
||
summarize min DT as start_date, max DT as end_date; group NoRisingDays |
第一步筛出目标股票,第二步按日期升序排序,顺序决定了“上涨”的比较方向。
第三步,segment CL down as NoRisingDays,是固定条件的用法。down 表示当前值小于上一行时组号加一,收盘价比前一天低即更换区间号,于是每一段连续上涨得到相同的区间号。
第四步按区间号分区计数,得到每个区间的天数。第五步中 rank ContinuousDays max 的 max 是过滤条件,取最大值对应的全部记录,而非只取一条。这一点很关键:如果历史上存在同样长的两段,两段都会保留,不会遗漏。
第六步按区间号分组,取最早和最晚的日期,即每个最长区间的起止日期。
中间状态同样可见:NoRisingDays 是区间号,ContinuousDays 是区间长度,第五步留下的记录直接表明最长的是哪几段。
这六步同样交由编译器处理,生成的原生 SQL 可直接执行。
写在最后
回头看三个例子,做的是同一件事:把原本需要分阶段完成的过程,从一条终态 SQL 或一段存储过程中取出,变成若干条按顺序排列的步骤。比如会话号、分组标记、区间号这些中间状态,在传统写法中是藏在子查询和临时表里的临时值,在这里是结果表中实际存在的列。
其代价也需要说明。这套写法对简单过滤和简单 CRUD 并不划算,一条 SELECT 即可完成的事情没必要拆成步骤。它面向的是足够复杂的分析逻辑。写存储过程也并非错误,只是中间状态被锁在过程里,他人无法单步验证,接手者只能推测。
AI writes the logic. A compiler writes the SQL.
如果手头也有一段难以维护的时间序列逻辑,可以放进 SQLazy 执行一遍,看它变成几步。示例库地址:https://github.com/SPLWare/SQLazy/tree/master/examples