
用 AI 编程写 SPL 入门实践
本文记录了一次用AI 编写 SPL 的闭环流程:人提要求 → AI 写码 → AI 跑码 → 人验收。在这个流程里,你不需要手写代码,你的任务是定口径、看探针、验结果;写码和排错主要由 AI 闭环,你只补它拿不到的素材。
目录:
| 节 | 标题 | 这一节解决什么 | 产出 |
| 0 | 构建SPL AI 编程环境 | 装skill 资料库 + 告诉 AI 如何执行,让 AI 既能写也能跑 | 安装skill + 自测跑通 |
| 1 | 例子一:统计学生成绩 | 让AI 写出第一个能跑的脚本 | 提示词、AI 回复、脚本、命令、预期输出 |
| 2 | 例子二:加探针自检 | 让AI 自己判断“对不对” | 在例子一上加一行断言,看到ok=true |
| 3 | 例子三:报错与反馈 | 报错时怎么跟AI 说 | 贴两样:报错现象、相关代码 |
| 4 | 核心提示词:查模板、定口径、加需求 | 换需求时直接复制 | 查模板、定口径、加需求,各一条 |
| 5 | 验收清单与附件 | 交付前检查什么、完整案例在哪 | 5 项清单 + 附件索引 |
第 0 节 构建SPL AI 编程环境
本地编程环境:Ubuntu 24.04 + esProc SPL标准版 + Trae/WorkBuddy。
0.1 安装 skill 资料库(让 AI 会写)
为了帮 AI 更好地掌握 SPL 语法规范和最佳实践,esProc 提供了配套的 skill 资料库。把它装进 Trae,等于给 AI 外挂了 SPL 专家经验,能大幅提升它写代码的专业度和准确率。
1. 下载附件:spl-skill.zip
2. 解压并配置(以 Trae 为例):
unzip spl-skills.zip -d ~/skills-pkg
mkdir -p ~/.trae-cn/skills
cp -r ~/skills-pkg/skills/* ~/.trae-cn/skills/
| 目录 | 内容 |
| esproc-spl/ | SPL 通用规则 + 案例(主入口,先读 SKILL.md) |
| esproc-spl-teaching/ | 入门教学案例包(含可跑数据/ 脚本) |
| spl-cookbook/ | 《SPL CookBook 2022》转写 |
| excel-spl/ | 《帮你早下班》转写(Excel 场景) |
| _index/ | 机器索引(供检索) |
| tools/ | 索引脚本 |
其他客户端换目录:
opencode:~/.config/opencode/skills/;
WorkBuddy:~/.workbuddy/skills/
装完重启 AI 客户端,skill 清单在启动时加载。
0.2 告诉 AI 如何执行(让 AI 能跑)
AI 本身不知道 esProc 装在哪里,也不知道用什么命令执行 .spl 脚本。如果不提前说明,它会去全盘遍历查找,甚至瞎猜。
直接把以下“执行规范”喂给 AI 就可以了,也可以写在项目的 AGENTS.md 里:
【给 AI 的环境指令】
1. esProc 执行引擎安装在:/usr/local/esproc/esProc【请替换为你本机的实际路径】
2. 当需要执行 .spl 脚本时,必须使用命令:$ESPROC_HOME/bin/esprocx.sh【Windows 下为 esprocx.exe】
3. 运行参数:必须带上 -r(用于在控制台打印结果和 output 日志),
   示例:bash /usr/local/esproc/esProc/bin/esprocx.sh -r test.spl
4. 注意:执行脚本必须在脚本所在的目录下运行(保证相对路径数据文件能被正确读取)
测试 AI 是否听懂:
现在问 AI:
我要跑一个测试脚本 /tmp/demo.spl,你应该在哪个目录,用什么命令执行?把完整命令写出来给我看。如果AI 能正确拼出类似
cd /tmp && /usr/local/esproc/esProc/bin/esprocx.sh -r demo.spl 0.3 开工前自检
让AI 自检:
请列出你当前安装的 SPL skill 资料库清单。如果 AI 能报出上面的目录清单,说明资料库配置成功。
若没有识别,则对AI 说:
将解压后的 esProc SPL skill资料库导入本地AI 编程环境;第 1 节 例子一:统计学生成绩
这一节做什么:让AI 写一个脚本,读 CSV、按学号汇总、加等级、导出,你把它放进 IDE 里跑出预期结果。
1.1 准备数据:建scores.csv
在项目目录下新建 scores.csv,内容如下(注意用UTF-8 无 BOM 格式存储,且逗号为英文半角):
学号, 科目, 分数
U1, 数学,95
U1, 英语,85
U2, 数学,60
U2, 英语,60对 AI 说出以下提示词:
用SPL写:读 scores.csv,按学号汇总总分、平均分;
平均>=60为及格,否则不及格;
输出学号、总分、平均、等级到out.csv。
先别写代码,先告诉我:
1) 你准备分几格,每格干什么;
2) U2 的期望结果是什么。
我确认后你再写脚本。
AI 应该回复如下计划和期望值:
A1 读 scores.csv
A2 按学号分组,算总分、平均
A3 加等级列
A4 只留学号、总分、平均、等级
A5 导出 out.csv
U2:数学60、英语60,平均60.0,等级“及格”。
1.4 生成脚本:保存grade.spl
你确认后,对AI 说:
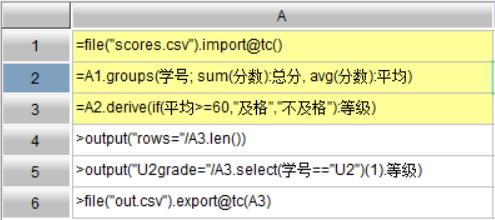
写出脚本文件grade.spl;# A B
1 =file("scores.csv").import@tc()
2 =A1.groups(学号; sum(分数):总分, avg(分数):平均)
3 =A2.derive(if(平均>=60,"及格","不及格"):等级)
4 >output("rows="/A3.len())
5 >output("U2grade="/A3.select(学号=="U2")(1).等级)
6 >file("out.csv").export@tc(A3)方式一:看 AI 反馈(推荐) 对 AI 说:
“执行一下grade.spl,把控制台输出贴给我。”AI会调用命令并返回日志。方式二:自己在IDE 里看(可选)
如果你想亲眼看看运行过程,直接打开esProc IDE 加载grade.spl运行即可:
1.6 验证结果:核对期望值
应该看到:
rows=2
U2grade= 及格

out.csv:
学号, 总分, 平均, 等级
U1,180,90.0, 及格
U2,120,60.0, 及格
1. 输出有 rows=2、U2grade= 及格
2. U2 平均 60.0、等级“及格”
3. out.csv 有 2 行数据如果报错,直接把报错原文和代码贴给 AI,它能自己分析(详见第 3 节)。
第 2 节 例子二:加探针自检
这一节做什么:在第1 节的脚本基础上,让 AI 加入自动断言。不用人眼去核对一堆输出,只要看到 ok=true 就代表这几条断言通过。
2.1 复用数据与脚本
不需要新建文件和重写代码。
数据继续复用上一节建好的 scores.csv。我们直接在现有的grade.spl脚本上做增量修改。
2.2 对 AI 说:增加断言探针
对 AI 说出:
在现有的 grade.spl脚本中,在导出那一行之前插入一行探针:判断 U2 的平均分是否为 60,
且等级是否为“及格”。如果是,就在控制台打印 ok=true,否则打印 ok=false。
2.3 看 AI 回:探针逻辑与预期
AI 会告诉你:它准备用 && 把两个条件连起来,并打印结果。预期控制台会新增一行ok=true。
2.4 生成脚本:保存 grade_debug.spl
让AI 把修改后的脚本另存为 grade_debug.spl。此时在导出代码前,多出了一行 ok= 的探针断言:
# A B
1 =file("scores.csv").import@tc()
2 =A1.groups(学号; sum( 分数): 总分, avg(分数): 平均 )
3 =A2.derive(if( 平均 >=60,"及格","不及格"): 等级 )
4 >output("rows="/A3.len())
5 >output("U2grade="/A3.select(学号 =="U2")(1). 等级 )
6 >output("ok="/f=(A3.select(学号 =="U2")(1), f. 平均 ==60 && f. 等级 =="及格"))
7 >file("out.csv").export@tc(A3)
2.5 让 AI 执行:运行并观察日志
对AI 说:
你执行一下 grade_debug.spl,把控制台输出贴给我。2.6 验证结果:核对 ok=true
脚本运行后,控制台应该看到:
rows=2
U2grade= 及格
ok=true
核对以下两条,全对即跑通:
1. 控制台输出了 ok=true(证明 AI 的探针起作用了)。
2. out.csv 文件正常生成。
2.7 结果不符(ok=false)怎么办
如果输出 ok=false,说明脚本的实际表现与预期口径不符。
此时可直接把 ok=false 的截图和当前代码贴给 AI,请它排查(“贴两样”见 3.6):
1. 是不是及格条件的判断写错了(比如 >= 写成了 >,或者 60 写成了 70)?
2. 是不是取错列了(比如本该用平均分,结果用了总分)?
第 3 节 例子三:出错了怎么反馈
这一节做什么:故意制造一个错误(把 >= 改成 >),演示当结果不符合预期时,如何通过“贴两样”让 AI 瞬间定位问题并改对。
3.1 准备数据:制造一个边界错误
打开上一节的 grade_debug.spl,手动(或让AI)把第 3 行的判定条件改错:
将 if(平均 >=60,"及格","不及格") 改为 if(平均 >60,"及格","不及格")。
保存为 grade_error.spl。
3.2 对 AI 说:执行错误脚本
对 AI 说:
执行一下 grade_error.spl,把控制台输出贴给我。3.3 看 AI 回:发现断言失败
AI 执行后,会回复你如下日志:
rows=2
U2grade= 不及格
ok=falseAI 回复:结果表里 U2 平均 60.0 却被判为“不及格”,说明断言未通过——U2 被判“不及格”,
与“平均 60.0 应及格”的口径不符。当前 grade_error.spl 里的条件与口径不一致(用了 >60 而不是
>=60)。需要我直接读一下原文,帮你改成符合“平均 >=60 及格”的版本吗?看到 AI 已经精准预判了问题根源,你不需要再去慢慢排查。直接对 AI 说:
是的,就是边界写错了。请你按>=60 的口径修复代码,另存为 grade_fixed.spl。让 AI 执行修好的 grade_fixed.spl ,确认控制台重新输出 ok=true , U2 的等级回到了“及格”。
3.6 排错时怎么跟 AI 说(贴两样)
报错或结果不符时,AI 凭代码 + 数据基本能自己定位根因。你只需把 AI 拿不到的两样素材贴给它——报错现象和相关代码——它就能给出修复。别只丢一句 "报错了帮我修",那样只会多绕几轮、拉低排查效率。
【报错现象】:(贴报错原文,或 ok=false)
【相关代码】:(贴出报错所在的那几行代码)
请定位到具体哪一格,给出根因并修复。
比如,如果你把 scores.csv 名字写错了,AI 执行后会报错,你只需这样贴:
【报错现象】:`File not found: scores.csv`
【相关代码】:`=file("score.csv").import@tc()`
请定位根因并修复。
第 4 节 核心提示词:查模板、定口径、加需求
4.1 查模板:找对参考案例
当你不知道怎么下手时,让 AI 去 skill 资料库找现成的同类案例。
对AI 说:
我要做 [一句话描述需求,如:计算每个用户的连续登录天数]。
先别写代码, 去 skill 资料库里检索能参考的案例,把候选案例名称,以及各自的适用场景报给我。
4.2 定口径:先对期望值,再写代码
对AI 说:
需求:读 xxx.csv,按 xxx 汇总,口径是 xxx,输出到 xxx.csv。
先别写代码。先告诉我:
1) 你准备分几格,每格干什么?
2) 挑出数据里的边界值(比如刚好及格、刚好 0),展示你推算的期望结果。
我确认无误后,你再动手写代码。
4.3 加需求:在跑通的代码上增量修改
代码跑通后,业务口径变了(比如及格线从60 改成 70),或者要加一列新指标,如何在已跑通的脚本上做最小增量改动?
对AI 说:
在现有跑通的代码基础上,做以下调整:
1. 口径变更:把及格线从 >=60 改为 >=70。
2. 增加指标:在聚合时多加一列“最高分”。
3. 探针更新:请同步更新断言探针里的期望值。
改完后,告诉我改了哪几格。
第 5 节 验收清单与附件
这一节做什么:AI 说写完了不算完,必须通过这 5 条硬性标准,才能把这套脚本交出去。
5.1 交付前的 5 项验收清单每次 AI 生成完最终脚本,你对照以下 5 项逐一打勾。全部通过,才算真正完工:
· □ 1. 能跑:让 AI 执行脚本,控制台能正常输出日志且无报错。。· □ 2. 输出对:控制台打印的行数、关键数值,与 1.3 定口径时确认的期望值一致。
· □ 3. 探针真:带着 ok=true 的断言脚本能跑通,证明 AI 写的自测逻辑有效。
· □ 4. 文件对:导出的 CSV/Excel 文件能正常打开,无乱码,行数和内容正确。
· □ 5. release 版干净:把带 >output(...) 探针的调试版 "派生" 为纯净的 _release.spl
· 对AI 说:
把 grade_debug.spl 里的 >output(...) 探针行删掉,按顺序重新排好行号,
另存为纯净的 grade_release.spl。
5.2 最终交付物与附件索引
你交付给同事或上线的,不是一段聊天记录,而是一个完整的文件包(通常是四类交付物):
□ 1. xxx_debug.spl:带探针的调试版(留着自己以后排查用)。□ 2. xxx_release.spl:去掉了探针的纯净发布版(交给生产环境用)。
□ 3. out.csv 及对应的原始数据:测试数据与跑完的结果。
□ 4. README.md(你项目的说明文档,区别于 skill 资料库根目录的 README):写清楚口径是什么、期望值是多少、怎么运行。交付时让 AI 基于 4.2 的口径与 4.3 的最终代码生成草稿,你核对后交付。
更多案例去哪找?本节的例子只是最简单的入门。如果在实际工作中遇到复杂场景(如多表关联、组内累计、TopN),请直接查阅随附 skill 资料库:esproc-spl/ 下的 case-*.md 案例(含测试数据、debug/release 脚本与期望值说明),以及教学包 esproc-spl-teaching/cases/。你可以直接让AI 去读这些案例作为参考。