
时间列转行再转置为新交叉表
问题描述
表 tb 可以看成一个交叉表:ID 与 PartNum 两个字段的组合是行头,EnteredOn、PickedTime、DeliveredTime 三个字段名是列头,格子里放的是时间点。行头的内容和数量都不固定。现在要把这张表翻过来:原来的格子(时间点)变成新表的行头,原来的行头(PartNum 与 ID 的组合)变成新表的列头,原来的三个列头换成字符串 ENTERED、PICKED、DELIVERED 填进格子里。
源数据
ID |
PartNum |
EnteredOn |
PickedTime |
DeliveredTime |
100 |
50A |
2024-03-28 08:59:13.727 |
2024-03-28 09:30:20.237 |
2024-03-28 09:56:42.570 |
125 |
60B |
2024-03-28 08:59:22.290 |
2024-03-28 09:31:32.543 |
2024-03-28 09:56:50.683 |
171 |
50A |
2024-03-28 14:31:28.480 |
||
211 |
70B |
2024-03-28 14:31:33.613 |
期望结果
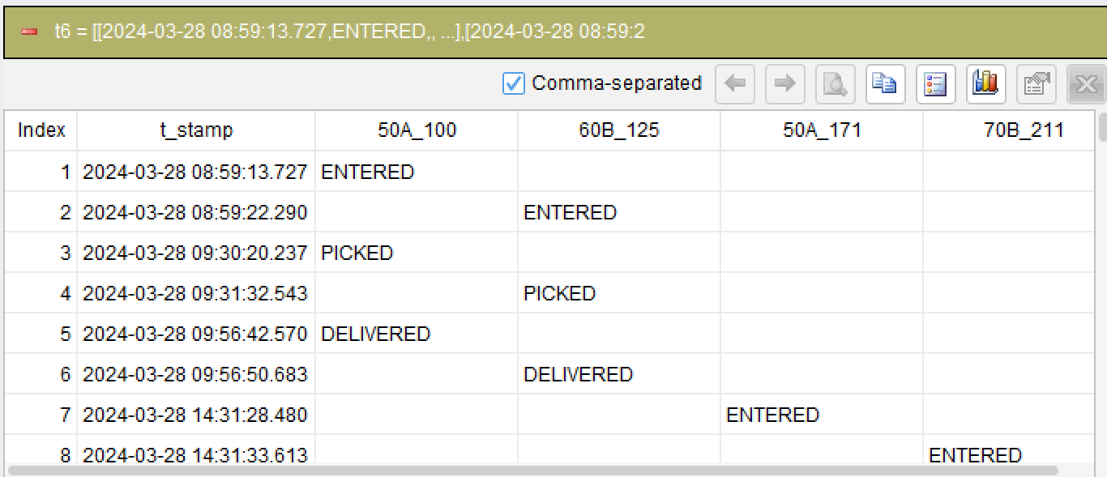
列头是 PartNum 与 ID 拼成的组合,行头是时间点,格子里是动作名:
t_stamp |
50A_100 |
60B_125 |
50A_171 |
70B_211 |
2024-03-28 08:59:13.727 |
ENTERED |
|||
2024-03-28 08:59:22.290 |
ENTERED |
|||
2024-03-28 09:30:20.237 |
PICKED |
|||
2024-03-28 09:31:32.543 |
PICKED |
|||
2024-03-28 09:56:42.570 |
DELIVERED |
|||
2024-03-28 09:56:50.683 |
DELIVERED |
|||
2024-03-28 14:31:28.480 |
ENTERED |
|||
2024-03-28 14:31:33.613 |
ENTERED |
第一行 2024-03-28 08:59:13.727 落在 50A_100 这一列,值是 ENTERED,说明这是 ID=100、PartNum=50A 这条记录的进入时间。同一列往下还能看到 PICKED 和 DELIVERED 两行,分别是这条记录的取件时间和送达时间。也就是说,原来横着排在一行里的三个时间点,现在竖着排成了一列。
ID=171 和 ID=211 这两条记录只有进入时间,取件和送达是空的,所以结果里 50A_171 和 70B_211 这两列各只有一个 ENTERED,没有 PICKED 和 DELIVERED。空值必须先滤掉,否则会在新表里多出两行没有意义的时间点。
新表的列数等于源数据里 "行头组合" 的个数(本例 4 个),行数等于三个时间列里非空值的总条数(本例 6 加 2 共 8 条),两个方向都不固定,所以这道题不能用写死列名的办法做。
SQLazy 分步实现
这道题的本质是旋转两次。第一次把三个时间列旋转成行,让每个时间点单独占一行,同时记下这个时间点属于哪个动作;第二次把行再旋转成列,用 PartNum 与 ID 拼出来的组合当新列名。两次旋转都用旋转功能,第一次用它的逆向模式(列转行),第二次用默认模式(行转列)。中间还要做两件小事:滤掉空的时间点,把动作的字段名换成题目要求的短名。
下面逐一解释这些步骤。
Name |
Anchor |
Statement |
t1 |
tb |
pivot group ID, PartNum; name action_type; value t_stamp; inverse |
t2 |
t1 |
filter (t_stamp notnull) |
t3 |
t2 |
compute if(action_type = "EnteredOn" then "ENTERED", action_type = "PickedTime" then "PICKED", action_type = "DeliveredTime" then "DELIVERED") as status |
t4 |
t3 |
compute concat(PartNum, "_", ID) as col_name |
t5 |
t4 |
derive t_stamp, col_name, status |
t5 |
pivot group t_stamp; name col_name; value status |
第 1 步:把三个时间列转成行
pivot group ID, PartNum; name action_type; value t_stamp; inverse
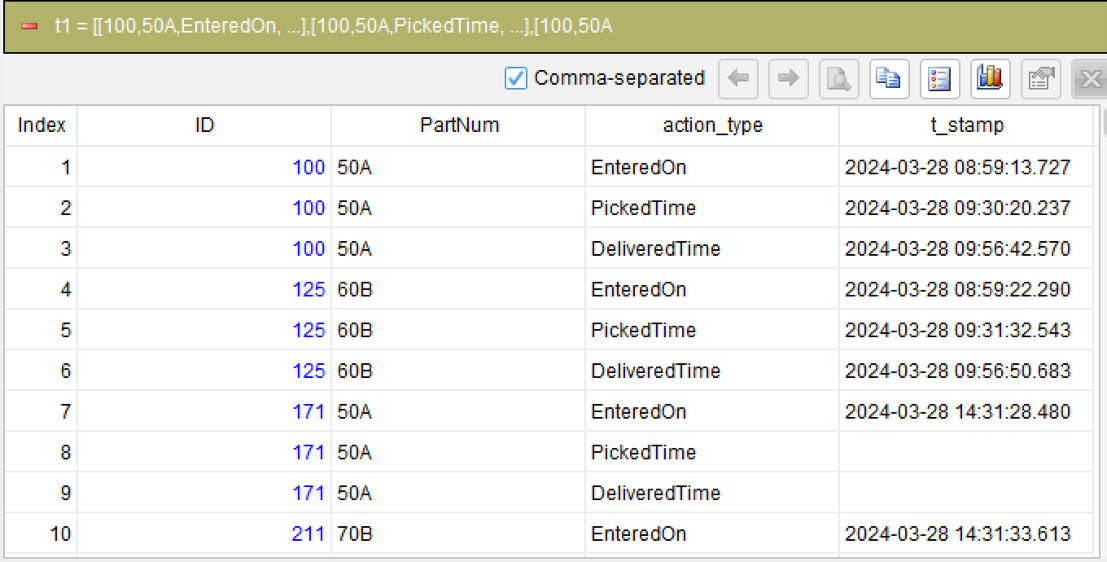
这是本题的第一个关键动作。旋转功能默认是把行转成列,加上逆向参数就切换成列转行:ID 和 PartNum 两个分组列保持不动,其余三个时间列被展开成行,原来的列名 EnteredOn、PickedTime、DeliveredTime 变成新列 action_type 的值,原来的列值(时间点)变成新列 t_stamp 的值。
这一步之后,一行宽记录变成了三行长记录:ID=100 这条记录会变成三行,分别带着 EnteredOn、PickedTime、DeliveredTime 三个动作名和对应的时间点。行头组合有几个、列头有几个都不影响这个动作,所以行头数量不固定也不怕。
第 2 步:滤掉空的时间点
filter (t_stamp notnull)
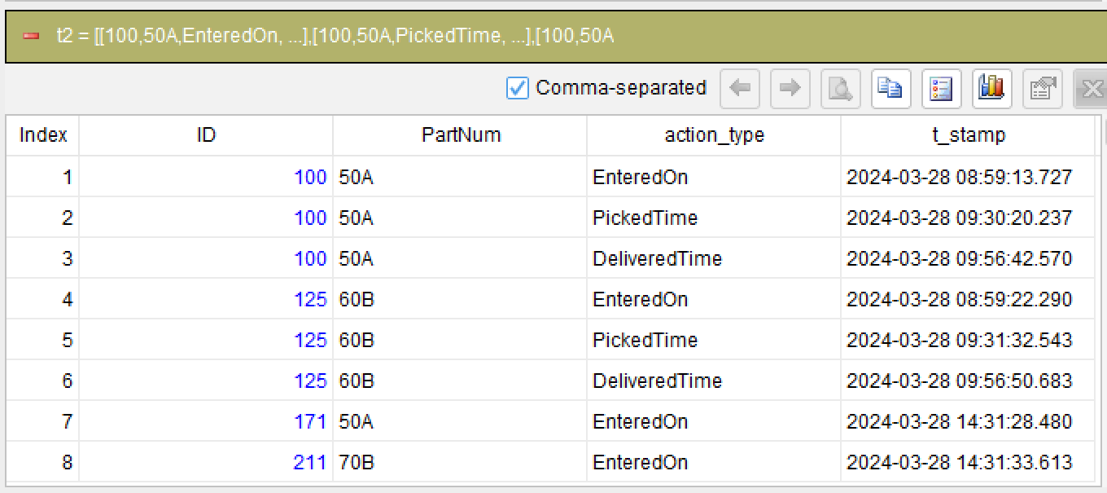
源数据里 ID=171 和 ID=211 这两条记录只有进入时间,取件和送达是空的。列转行会把空值也展开成行,这些行没有实际意义,先滤掉。判断空值用的是非空函数,整个条件式写在筛选功能的括号里。
第 3 步:把动作名换成题目要求的短名
compute if(action_type = “EnteredOn” then “ENTERED”, action_type = “PickedTime” then “PICKED”, action_type = “DeliveredTime” then “DELIVERED”) as status
题目要求格子里的内容是 ENTERED、PICKED、DELIVERED,而列转行得到的是原始的列名,所以用计算列加条件函数做一次映射:动作名等于 EnteredOn 就换成 ENTERED,等于 PickedTime 就换成 PICKED,等于 DeliveredTime 就换成 DELIVERED,结果写入新列 status。条件函数可以依次判断多个条件并返回对应的值,正好适合这种多个等值分支的映射。
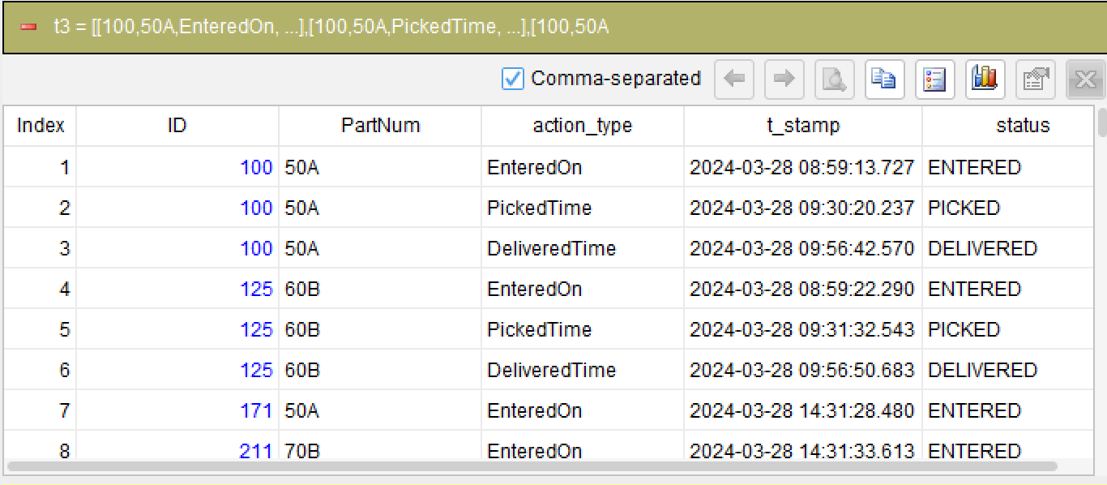
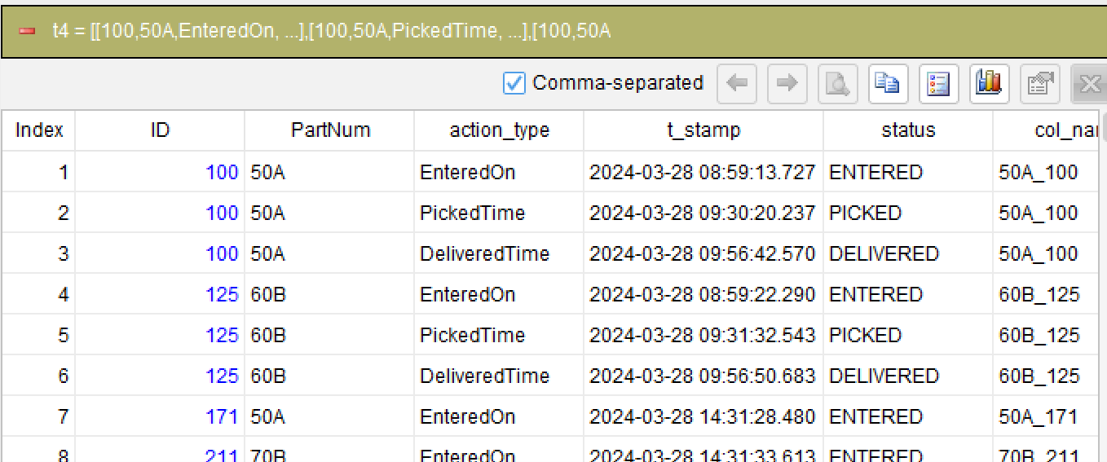
第 4 步:拼出新表的列名
compute concat(PartNum, “_”, ID) as col_name
新表的列头是 PartNum 与 ID 用下划线拼起来的组合,比如 50A_100。用连接函数把两个字段和中间的下划线拼成一个字符串,写入新列 col_name。列名不是事先知道的,是数据算出来的,这也是这道题不能写死列名的原因。
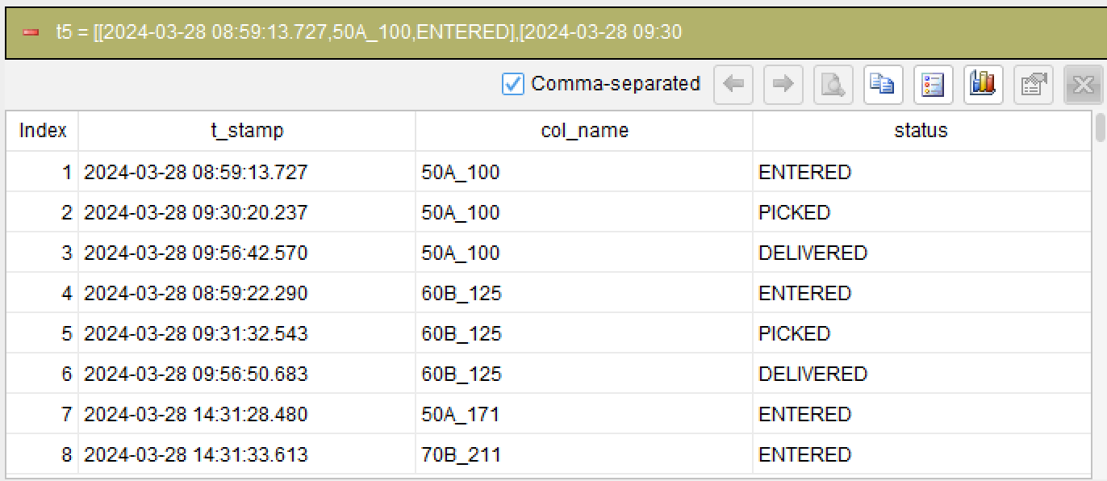
第 5 步:只留需要的三列
derive t_stamp, col_name, status
前面的步骤留下了 ID、PartNum、action_type 等中间列,第二次旋转只需要时间点、列名、动作名三列,用导出表挑出来即可。
第 6 步:把行转成列
pivot group t_stamp; name col_name; value status
第二次旋转不写计算方法,用默认模式行转列:按 t_stamp 分组,col_name 的每个取值变成一个新列的列名,status 的值填进对应的格子。同一行同一列在数据里只会出现一次(一个时间点只属于一条记录的一个动作),所以不需要指定聚合算法,缺省的取组内第一条就够了。
这里不写逆向参数,与第 1 步正好相反:第 1 步是把列转成行,这一步是把行转成列,两次旋转合起来完成了整张表的翻转。
编译生成 SQL
确认上述 6 步逻辑后,SQLazy 编译器自动生成原生 SQL(这里是 MySQL 语法):
WITH t1 AS (
    SELECT ID, PartNum, 'EnteredOn' AS action_type, EnteredOn AS t_stamp
    FROM tb
    UNION ALL
    SELECT ID, PartNum, 'PickedTime' AS action_type, PickedTime AS t_stamp
    FROM tb
    UNION ALL
    SELECT ID, PartNum, 'DeliveredTime' AS action_type, DeliveredTime AS t_stamp
    FROM tb
  ),
  t2 AS (
    SELECT ID, PartNum, EnteredOn, PickedTime, DeliveredTime
    FROM t1
    WHERE t_stamp IS NOT NULL
  ),
  t4 AS (
    SELECT ID, PartNum, action_type, t_stamp
      , CASE
        WHEN action_type = 'EnteredOn' THEN 'ENTERED'
        WHEN action_type = 'PickedTime' THEN 'PICKED'
        WHEN action_type = 'DeliveredTime' THEN 'DELIVERED'
        ELSE NULL
      END AS status
      , concat_ws('', PartNum, '_', ID) AS col_name
    FROM t2
  ),
  t5 AS (
    SELECT t_stamp, col_name, status
      , FIRST_VALUE(status) OVER (PARTITION BY t_stamp, col_name ORDER BY NULL) AS FIRST_2
    FROM t4
  )
SELECT t_stamp
  , MIN(CASE
    WHEN col_name = '50A_100' THEN FIRST_2
  END) AS `50A_100`
  , MIN(CASE
    WHEN col_name = '50A_171' THEN FIRST_2
  END) AS `50A_171`
  , MIN(CASE
    WHEN col_name = '60B_125' THEN FIRST_2
  END) AS `60B_125`
  , MIN(CASE
    WHEN col_name = '70B_211' THEN FIRST_2
  END) AS `70B_211`
FROM t5
GROUP BY t_stamp
SQLazy 让你用业务语言描述逻辑,而不是用 SQL 语法写嵌套查询。这道题的两次翻转各用一句旋转语句就能表达:第一次用逆向模式把三个时间列展开成行,第二次用默认模式把行再转成列,读代码时一眼就能看出 "先列转行、再行转列" 这两步,不必在 SQL 里逐个手写 UNION ALL 和写死的 CASE 分支。
旋转功能的两种模式是这道题的关键。同一个功能,加不加逆向参数就切换了方向,而两个方向共用分组列、标题列、取值列这套说法,业务上说的 "哪个字段当新列名、哪个字段当新值" 可以直接照抄成参数,不需要先想清楚 SQL 里该用 CASE 还是该用 UNION。
新列名来自数据本身(PartNum 与 ID 拼接)时,SQL 只能把列名写死在语句里,数据一变就得改语句;SQLazy 把拼接列名也当成一步普通的计算列,列名随数据自动生成,行头和列头数量变化都不用改代码。
分步计算让每一步都能单独查看:第 1 步之后能看到展开后的长表,第 2 步之后能看到空值已经被滤掉,第 4 步之后能看到拼好的列名,出错时不必把整条语句跑完再猜哪一段不对。
官方链接
SQLazy 在线体验:sqlazy.com(免费,无需注册)
SQLazy 项目仓库:github.com/SPLWare/SQLazy
英文版:https://c.esproc.com/article/1792648788870