
高级分析师最怕的 5 类 SQL:不是不会写,是没法验证
这样的场面见得太多:dbt 模型里要加一个口径,或者报表里要改一个分组条件,评审的时候大家都觉得这事很简单,一句话就说明白了。但等 SQL 改出来,没人敢说“这段肯定对”。
能写出来的人,往往就是团队里资历最深的那几个人。
问题是改完之后,中间过程全被压进一条终态 SQL 里。区间边界在哪里?累计什么时候重置?会话边界怎么切?缺口到底拿了谁的值?动态列名从哪里来?类似这样的问题,没有一个能直接从结果表里看出来。
高级分析师不会在群里说自己心里没底。他们只会再跑一遍,再猜一次。
下面这 5 类 SQL,就是最常出现这种局面的场景。如果你曾经搜过 complex SQL help,多半也是被它们卡住的。
连续区间(streak):连续上涨只是表面
这类问题就是:在一串有顺序的记录里,找出连续满足某个条件的记录段,再算出它的长度或者起止位置。
它不是金融专属问题。连续登录了多少天、某个 SKU 连续缺货多少天、一台设备连续停机多久,都是同一类问题。下面用股票连续上涨做例子:找出某只股票历史上最长连续上涨区间的起始日期和结束日期。
输入是一张股票行情表,每行记录某支股票某天的收盘价,字段就 3 个:CODE(股票代码)、DT(日期)、CL(收盘价)。目标是输出最长连续上涨区间的起止日期:
NoRisingDays |
start_date |
end_date |
1 |
2009-01-07 |
2009-01-12 |
2 |
2009-01-13 |
2009-01-16 |
业务逻辑不难:按日期排序,依次判断每天是不是比前一天高,把连续上涨的区间标出来,数每个区间有多长,取最长的那个,再拿它的起点和终点。
但落到 SQL 里,它长这样(MySQL):
WITH seg AS (
    SELECT DT, CL,
        SUM(UpDownTag) OVER (ORDER BY DT) AS NoRisingDays
    FROM (
        SELECT DT, CL,
            CASE WHEN CL > LAG(CL) OVER (ORDER BY DT) THEN 0 ELSE 1 END AS UpDownTag
        FROM stock
        WHERE CODE = 100046
    ) flagged
),
counted AS (
    SELECT NoRisingDays, COUNT(*) AS ContinuousDays
    FROM seg
    GROUP BY NoRisingDays
)
SELECT NoRisingDays, MIN(DT) AS start_date, MAX(DT) AS end_date
FROM seg
WHERE NoRisingDays IN (
    SELECT NoRisingDays
    FROM counted
    WHERE ContinuousDays = (SELECT MAX(ContinuousDays) FROM counted)
)
GROUP BY NoRisingDays;
```
这段 SQL 不用逐行读,看结构就够了:判断涨跌、生成区间编号、统计区间长度、找最长区间、取起止日期,全部压在一个查询里;区间编号和区间长度虽然各自只算了一次,但“最长区间”这个条件被塞进 IN 子查询里,里面还要再嵌一层 MAX。想知道它到底筛掉了哪些区间,只能把整段拆开跑。
长不是问题。问题是涨跌标记、区间编号、区间长度、最长区间这 4 个中间状态全被藏起来了,最后只丢给你一张起止日期表。结果一旦不对,你根本不知道是哪一层出的问题。是分段条件写错了?还是最长区间的判断偏了?还是日期传递的时候串了组?
不是不会写,是没法验证。这句话在连续区间这个场景里特别具体:你知道逻辑是什么,但你没有地方可以停下来确认它。
有一种写法能让这些中间状态重新露出来。
SQLazy是直白易懂的结构化数据计算语言,分步清晰、输出确定、便于审计。同一道题,它不要求你一口气交付终态,而是按业务顺序写出来:
1. 先筛出目标股票;
2. 按日期排序;
3. 按下跌分段,给每个连续上涨区间一个编号;
4. 统计每个区间持续了多少天;
5. 找出持续天数最长的区间;
6. 汇总这个区间的起始日期和结束日期。
这 6 步在 SQLazy 里写出来就是这样:
stock:filter CODE = 100046
sort DT asc
segment CL down as NoRisingDays
compute count DT as ContinuousDays; partition NoRisingDays
rank ContinuousDays max
summarize min DT as start_date, max DT as end_date; group NoRisingDays
分步写下来之后,涨跌标记、区间编号、区间长度、最长区间、起止日期全都留在了中间结果里。第 3 步执行完,就能直接看到 NoRisingDays,区间边界对不对,当场就知道;第 4 步执行完,能看到每个区间持续了多久;第 5 步执行完,才确定哪一个是最长区间。改错的时候,也只需要回到出错的那一步,不用整段重来。
写得更快只是顺带的。真正的问题是,这份分析能不能交给别人、能不能过评审、能不能在线上站得住,取决于每一步是不是看得见。
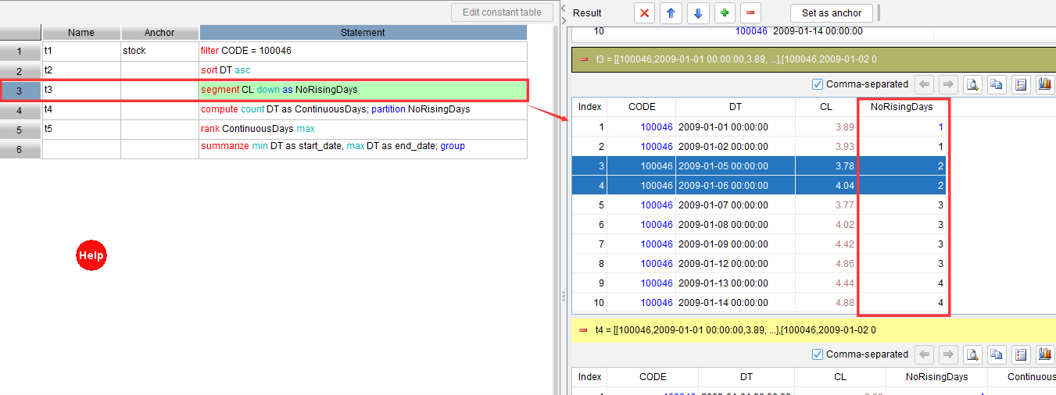
这个例子在 Playground 里能跑出一个有意思的结果:
想自己跑一遍:https://www.sqlazy.com/?4OY
注意这个结果里有 2 段,如果数据中存在同样长的连续区间,最长区间就不止一段。这也是为什么中间状态必须看得见:分段规则切得对不对,光看这几行结果判断不了。
这 6 步不是终点:每一步都能执行、都能看结果,最后编译器会把它们编译成原生 SQL。它不绑定某一个数据库:同一套步骤可以编译成 MySQL、PostgreSQL、Snowflake、BigQuery 的方言,输出的是纯原生 SQL,复制即用,没有 vendor lock-in。逻辑是人能读的步骤,交付给数据库的仍然是 SQL。
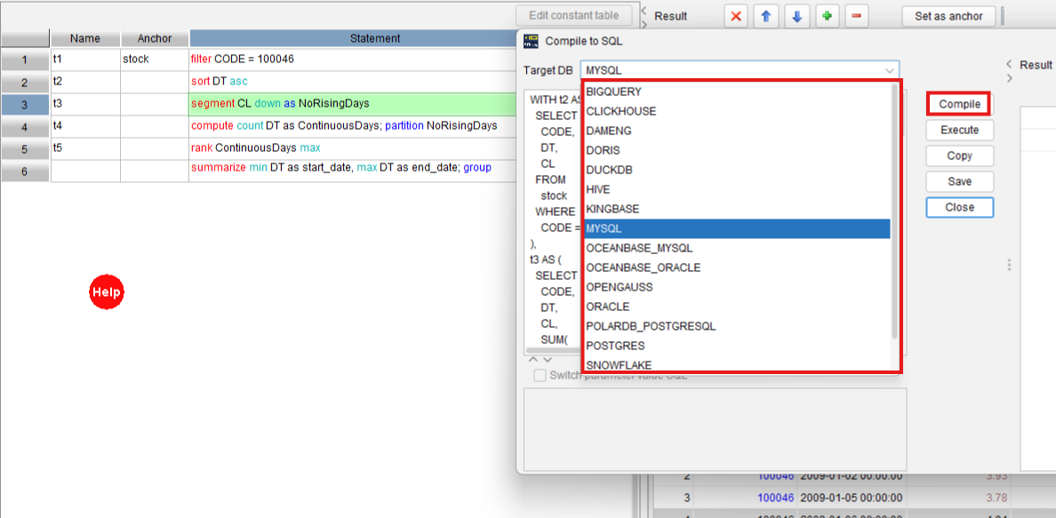
它和“再写一条更长的 SQL”的区别就在这里:每一步都能看见了,也就能被验证。
后面这 4 类就不展开讲了,每一类只看一件事:那个卡住你的中间结果,能不能直接看到。
条件累计:累计到一半,条件突然要求清零
累计本来是最简单的聚合,但业务加一句“遇到 t 就重新算”,事情就变成了两层窗口套在一起:先标出重置点,再按重置区间累计。
例子只有三列:id、logic、val。按 id 顺序累计 val,遇到 logic=t 时输出重置为 1,否则继续上一行的累计。
写成 SQL 是这样(MySQL):
SELECT id, logic, val
    , SUM(CASE
        WHEN logic = 't' THEN 1
        ELSE val
    END) OVER (PARTITION BY logic_run ORDER BY CASE
        WHEN id IS NULL THEN 1
        ELSE 0
    END, id ASC ROWS UNBOUNDED PRECEDING) AS output
FROM (
    SELECT id, logic, val,
        SUM(CASE
            WHEN logic = 't' THEN 1
            ELSE 0
        END) OVER (ORDER BY CASE
            WHEN id IS NULL THEN 1
            ELSE 0
        END, id ASC ROWS UNBOUNDED PRECEDING) AS logic_run
    FROM table_t1
) calc
ORDER BY CASE
    WHEN id IS NULL THEN 1
    ELSE 0
END, id ASC;
这段 SQL 里最关键的中间列是 logic_run:它标记了哪一行触发了重置,后面的累计又按这个重置区间分组。可它被埋在内层子查询里,最终结果里不出现。output 算得对不对,只能靠人拿原始数据一格格核对。
在 SQLazy 里,这件事被拆成 3 步:先按 id 排序,再标记重置条件,最后按重置后的区间累计。先看 logic_run,重置点对不对一目了然;再看 output,累计有没有沿着正确的区间继续,也能当场确认。
table_t1:sort id asc
compute if(logic="t" then 1 else 0) cum as logic_run
compute if(logic="t" then 1 else val) cum as output partition logic_run
想自己看 logic_run 和 output 怎么一步步算出来,这段代码可以直接跑:
会话化(sessionization):什么时候该换一个新会话?
同一个账号,一天可能来好几次。哪几次算同一次会话,取决于两次事件之间隔了多久。这就是会话化:按时间间隔或状态变化,把连续发生的事件切成若干段。
场景是账号的事件流,表里只有账号和时间两列;两次事件隔了一小时以上,就重新开一个会话。
用 SQL 写出来是这样(MySQL):
SELECT account_number, dt,
    ROW_NUMBER() OVER (PARTITION BY account_number, grp ORDER BY account_number ASC, dt ASC) AS seq
FROM (
    SELECT account_number, dt, 1 + SUM(CASE
            WHEN col__2 + INTERVAL 3600 SECOND <= dt THEN 1
            ELSE 0
        END) OVER (PARTITION BY account_number ORDER BY account_number ASC, dt ASC) AS grp
    FROM (
        SELECT event_tb.*, LAG(dt) OVER (PARTITION BY account_number ORDER BY account_number ASC, dt ASC) AS col__2
        FROM event_tb
    ) sub__3
) t3
ORDER BY account_number ASC, dt ASC;
这段 SQL 用了两层窗口:一层判断时间差、生成会话分组,另一层按分组编号。两层还分别藏在不同的子查询层里:要看懂 seq,得先翻到最里面看 col__2,再往外看 grp,最后才轮到 seq。麻烦在于,会话边界 grp 不输出,序号对不对,光看结果判断不了。
超过一小时的那一行,seq 会重新从 1 开始。至于它是怎么判断出来的,结果里没有任何线索。
SQLazy 只需要 3 步:排序、按时间间隔分段、分组内编号。分段那一步执行完,grp 和 seq 都在表里,边界切在哪里,不用猜。
event_tb:sort account_number asc dt asc
segment condition ((dt[-1] elapse 3600 second) <= dt) partition account_number as grp
compute # as seq partition account_number grp
排序、分段、编号这三步都在这里:https://www.sqlazy.com/?4M4
缺口回填:NULL 不是空,前面的值要接上来
报表里最怕看到的不是数字错,是空着。dept 列有几行是 NULL,业务的要求就两个字:补上。
一张员工表就能复现:id、name、dept。第 2 行部门空着,沿用第 1 行的 Marketing;第 4、5 行空着,沿用第 3 行的 Sales。
业务只说“补上”,SQL 里却要多出好几层:先构造分组,再找到有效值,最后把它写回原来的行。补完之后,谁也说不清某个 NULL 到底沿用了哪一行。
同样的逻辑用 SQL 写(MySQL):
SELECT id, name, filled_dept AS dept
FROM (
    SELECT id, name, dept, grp
        , MAX(dept) OVER (PARTITION BY grp) AS filled_dept
    FROM (
        SELECT id, name, dept
            , SUM(CASE
                WHEN dept IS NOT NULL THEN 1
                ELSE 0
            END) OVER (ORDER BY CASE
                WHEN id IS NULL THEN 1
                ELSE 0
            END, id ASC ROWS UNBOUNDED PRECEDING) AS grp
        FROM forwardFill
    ) g
) f
ORDER BY CASE
    WHEN id IS NULL THEN 1
    ELSE 0
END, id ASC;
这段 SQL 里,grp 决定每个空值归属于哪一段,MAX(dept) 再把这一段里的有效值回填给空值。分组和回填分别埋在两个子查询里:grp 不输出,filled_dept 虽然改名成 dept 输出,但它到底沿用了哪一行,无从查证。
换成 SQLazy,这件事是 4 步:标记非空值、按连续区间分组、取组内的有效值、写回原表。第 2 步执行完,能确认空值归属于哪一段;第 3 步执行完,能确认它拿到的具体值。
forwardFill:sort id asc
compute if ((dept notnull) then 1 else 0) cum as grp
compute max dept as filled_dept; partition grp
derive id, name, filled_dept as dept
完整的四步可以在这里跑:https://www.sqlazy.com/?39E
动态透视:列名不是固定的
业务方要的是一张宽表:每行一个时间点,每列一个订单。可原始数据里,三个时间点是三列,订单信息在行里。这就是动态透视:让列名跟着数据走。
例子是四个订单的流转记录,每行有 ID、PartNum 和 EnteredOn、PickedTime、DeliveredTime。要求把这 3 个时间列转成“事件类型+时间”的长表,再把 PartNum 和 ID 拼成列名,最后转置成宽表。
SQL里这类需求会把列转行、状态转换、动态列名拼接和再次透视压在一起。最终宽表看起来整整齐齐,但中间的列名是怎么来的、状态值是在哪一步换的,从结果里完全看不出来。
完整 SQL 长这样(MySQL):
SELECT t_stamp,
    MIN(CASE WHEN col_name = '50A_100' THEN FIRST_2 END) AS `50A_100`,
    MIN(CASE WHEN col_name = '60B_125' THEN FIRST_2 END) AS `60B_125`,
    MIN(CASE WHEN col_name = '50A_171' THEN FIRST_2 END) AS `50A_171`,
    MIN(CASE WHEN col_name = '70B_211' THEN FIRST_2 END) AS `70B_211`
FROM (
    SELECT t_stamp, col_name, status,
        FIRST_VALUE(status) OVER (PARTITION BY t_stamp, col_name ORDER BY NULL) AS FIRST_2
    FROM (
        SELECT ID, PartNum, action_type, t_stamp,
            CASE
                WHEN action_type = 'EnteredOn' THEN 'ENTERED'
                WHEN action_type = 'PickedTime' THEN 'PICKED'
                WHEN action_type = 'DeliveredTime' THEN 'DELIVERED'
                ELSE NULL
            END AS status,
            concat_ws('', PartNum, '_', ID) AS col_name
        FROM (
            SELECT ID, PartNum, action_type, t_stamp
            FROM (
                SELECT ID, PartNum, 'EnteredOn' AS action_type, EnteredOn AS t_stamp FROM tb
                UNION ALL
                SELECT ID, PartNum, 'PickedTime' AS action_type, PickedTime AS t_stamp FROM tb
                UNION ALL
                SELECT ID, PartNum, 'DeliveredTime' AS action_type, DeliveredTime AS t_stamp FROM tb
            ) u
            WHERE t_stamp IS NOT NULL
        ) f
    ) s
) v
GROUP BY t_stamp;
像 50A_100 这样的列名,不是原表里就有的;ENTERED 也不是原值。它们都是在中间步骤里生成出来的,而这几步被压成四层嵌套:status、col_name、FIRST_2 在最终宽表里一个都看不到。列名和值的来历,最终宽表里一个字都没留下。
同一道题在 SQLazy 里是 6 步:列转行、过滤空值、状态转换、生成动态列名、整理中间字段、再次透视。每一步的结果都能单独看,列名和值到底从哪来,就不用猜了。
tb:pivot group ID, PartNum; name action_type; value t_stamp; inverse
filter (t_stamp notnull)
compute if(action_type = "EnteredOn" then "ENTERED", action_type = "PickedTime" then "PICKED", action_type = "DeliveredTime" then "DELIVERED") as status
compute concat(PartNum, "_", ID) as col_name
derive t_stamp, col_name, status
pivot group t_stamp; name col_name; value status
想看看动态列名是怎么生成的,可以跑这个例子:https://www.sqlazy.com/?2Yx
写在最后:看得见,才能验证
这 5 类问题,表面上是五件事:切区间、重置累计、分会话、补缺口、转宽表。
骨子里是一件事:它们都要分几步走,而 SQL 只让你交一个最终结果。
不是不会写,是没法验证。
写出来不难,难的是证明它每一步都对。做 dbt optimization 的人最有体会:改一个口径,整条链路都得重新验一遍。
看得见,才能验证。
SQLazy把过程拆成有顺序的步骤,每一步都能执行、都能看结果。AI 帮助把业务逻辑规划成一步一步,编译器负责把这些步骤编译成原生 SQL。逻辑给人看,SQL 给机器跑。
想把复杂 SQL 真正拆开看一遍,5 个例子都能在 Playground 里直接跑,链接已经放在每一类的段末。想看更多会话化、连续区间、动态分组和报表转换的例子,可以去示例库:https://github.com/SPLWare/SQLazy/tree/master/examples
这 5 类 SQL,你最怕哪一类?