
SQLazy:AI 编写可信 SQL,审计成本直降 90%
三行五行的简单 SQL 只存在于教科书里。真实业务中的 SQL 往往动辄上百行、多层嵌套,逻辑盘根错节,编写烧脑、调试耗时、交接如同 “拆弹”,而贯穿全流程最大的隐性成本,就是审计。
有了 AI 编程也不能解决这个问题,生成是快了,但敢信吗?逻辑对不对、结果准不准,还是要靠人工 review,读懂 AI 写的复杂 SQL 再审计的成本,比自己重写一遍也差不了太多。
SQLazy 给出了另一条路:用线性易读的 “人话步骤”来描述复杂 SQL 的运算逻辑,再用确定性编译替代概率模型生成可执行 SQL,从编写、调试到跨库、传承全链路透明可控,让复杂 SQL 的审计成本直降 90%。
一、告别嵌套烧脑:SQL 也能写成 “人话步骤”
同样是 “计算某支股票最长连续上涨天数”,原生 SQL 需要四层嵌套 CTE 叠加窗口函数,写完自己都要反复核对:
select max(ContinuousDays)
from (
    select count(*) ContinuousDays
    from (
        select sum(UpDownTag) over (order by DT) NoRisingDays
        from (
            select DT,
                case when CL > lag(CL) over (order by DT) then 0
                else 1 end UpDownTag
            from Stock
            where CODE = 110838
        )
    )
    group by NoRisingDays
)
而在 SQLazy 里,同样的逻辑只需 5 步:
stock: 筛选 CODE=110838
排序  DT 升序
分段 CL 变小 命名 不涨标记
汇总 DT 计数 命名 连涨天数; 分组 不涨标记
汇总 连涨天数 最大 命名 最长上涨天数
每一步只做一件事:筛选、排序、分段、聚合…… 逻辑线性展开,像读业务操作清单一样清晰。
SQLazy 脚本就是一份可编译的 spec,把规格驱动开发(SDD)的模式贯彻到了极致。脚本确认无误后,编译器生成目标 SQL,100% 准确,无幻觉。目标 SQL 本身甚至不需要审计,因为它是从你确认过的脚本确定性编译出来的。
二、分步可视调试:找 bug 效率提升 10 倍
复杂 SQL 调试一向是老大难:要排查错误,得手动逐层拆解子查询,分别执行验证,内外耦合的逻辑牵一发而动全身,往往写半小时 SQL,调一小时 bug。AI 生成的 SQL 也是如此,出错了不知道错在哪,排查全靠试。
SQLazy 专属 IDE 支持每一步单独执行、实时预览中间结果。点击任意步骤,就能看到对应输出的完整数据,过滤条件对不对、分组计算准不准,当场就能验证。
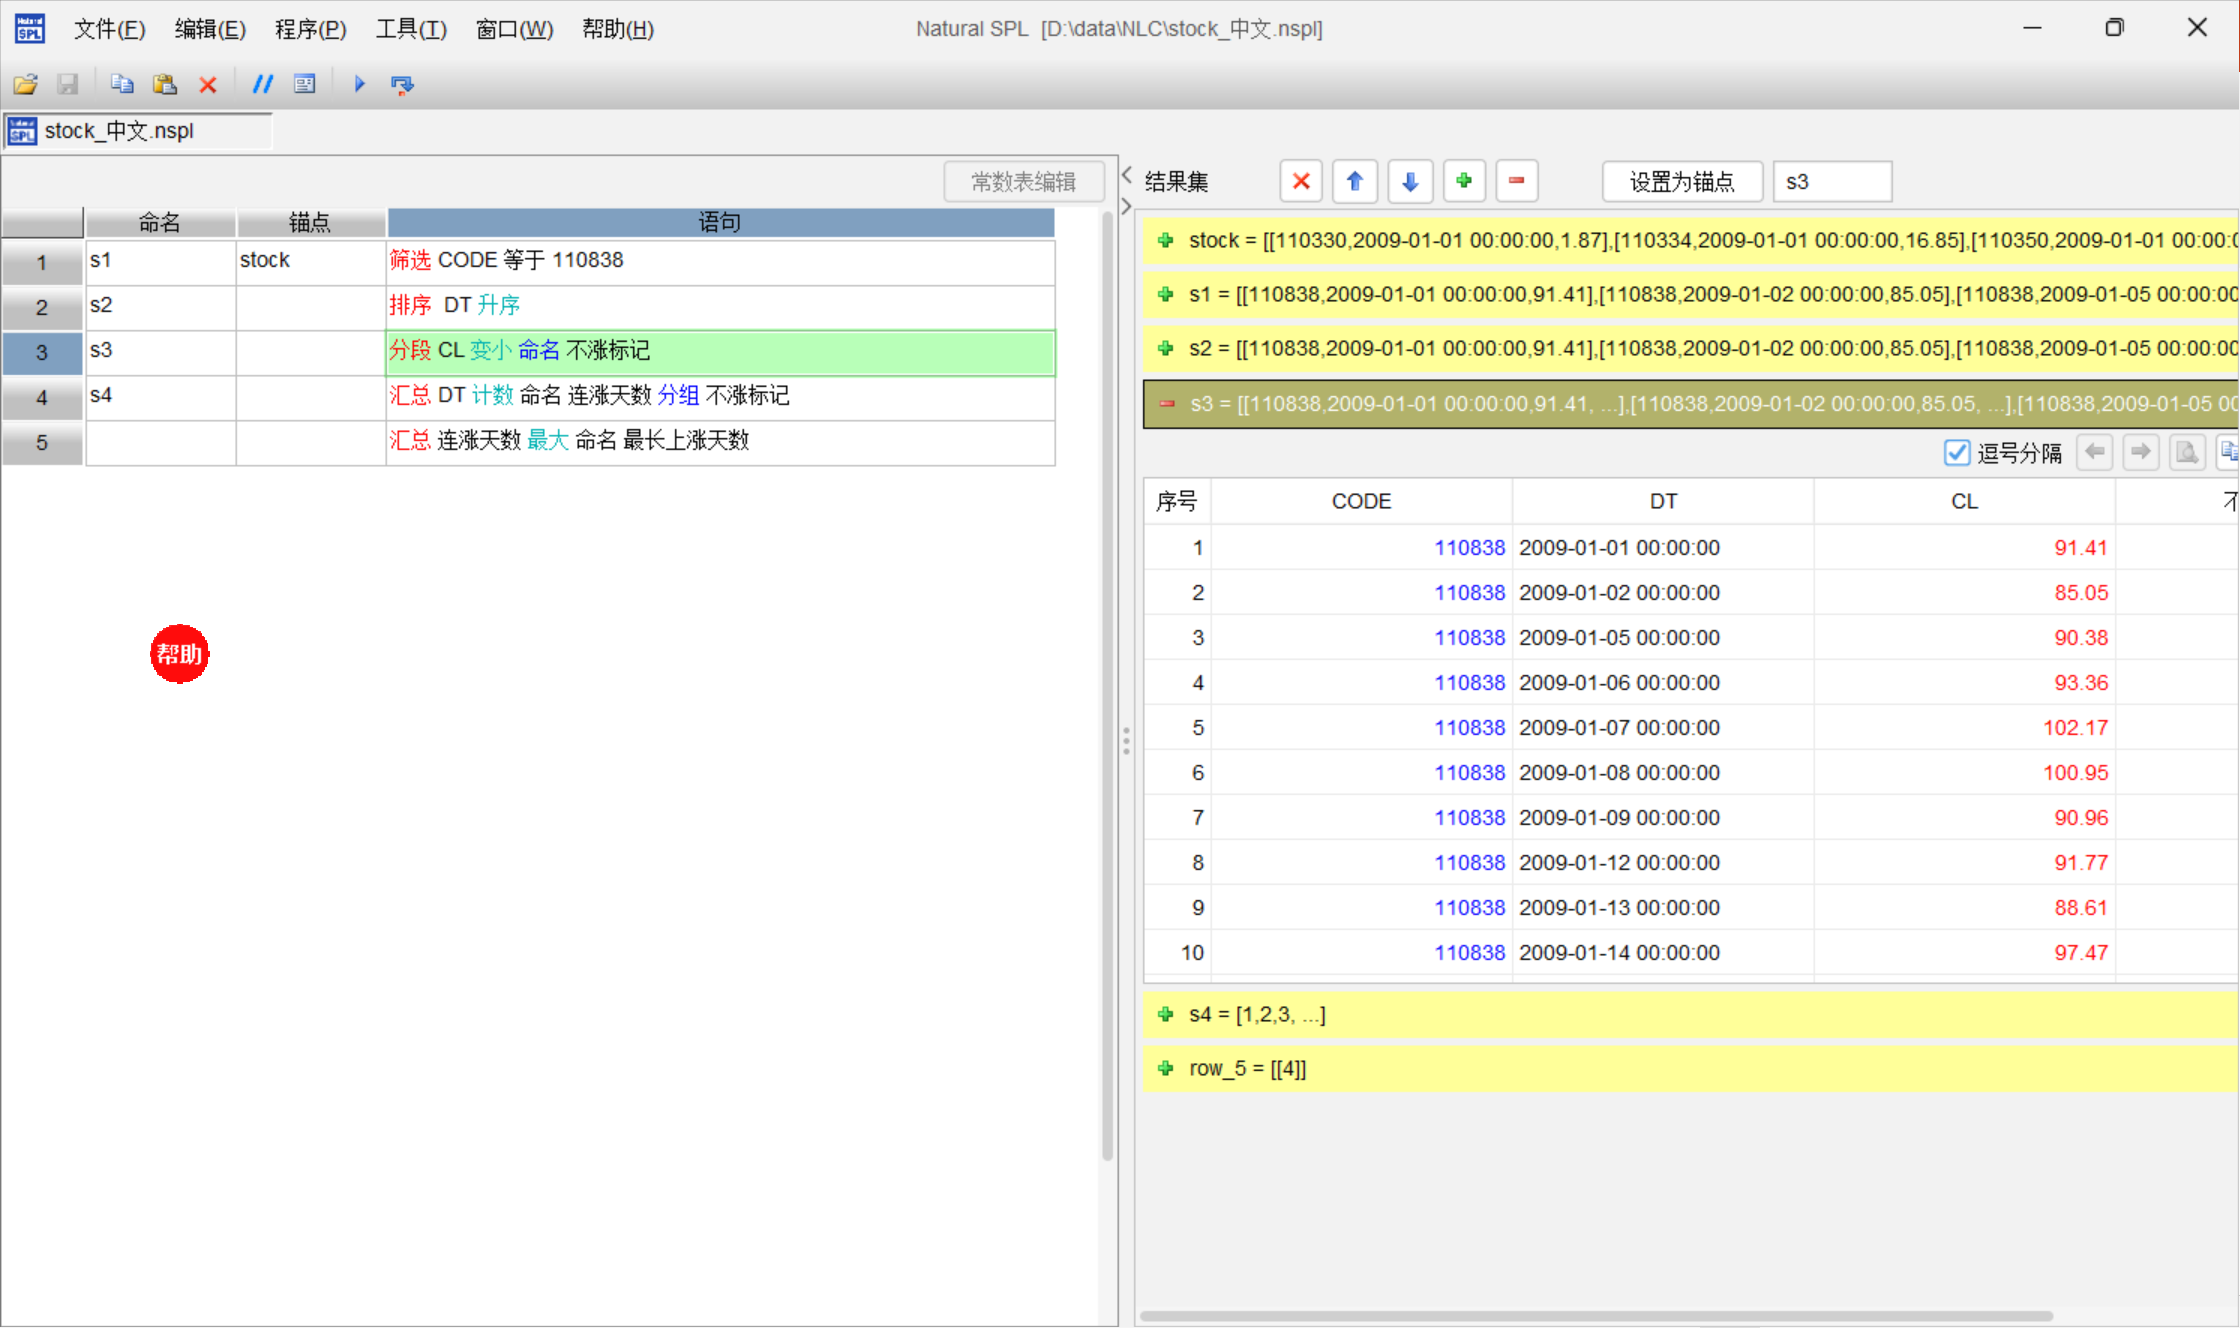
对审计而言,这意味着不再是 “结果对不对全靠跑”,而是可以逐步骤追溯逻辑、逐环节校验数据。问题精准定位到具体某一步,修改也只动对应步骤,不会牵动全局。调试和审计都从 “开盲盒” 变成了 “走流程”,效率量级提升。
三、一套逻辑,多库编译:跨库适配不再重复审计
AI 训练数据对主流数据库覆盖多,对小众数据库、国产数据库支持弱,生成的代码经常要手工改;同一份业务逻辑要适配多个数据库,就得写 N 个版本、做 N 次审计,纯体力重复劳动。
SQLazy 基于规则的确定性编译器,原生支持 MySQL、Oracle、PostgreSQL、Hive、Spark、Snowflake、达梦、人大金仓等十余种主流数据库与数仓平台。函数差异、语法特性、数据类型转换、窗口函数边界全部自动处理。
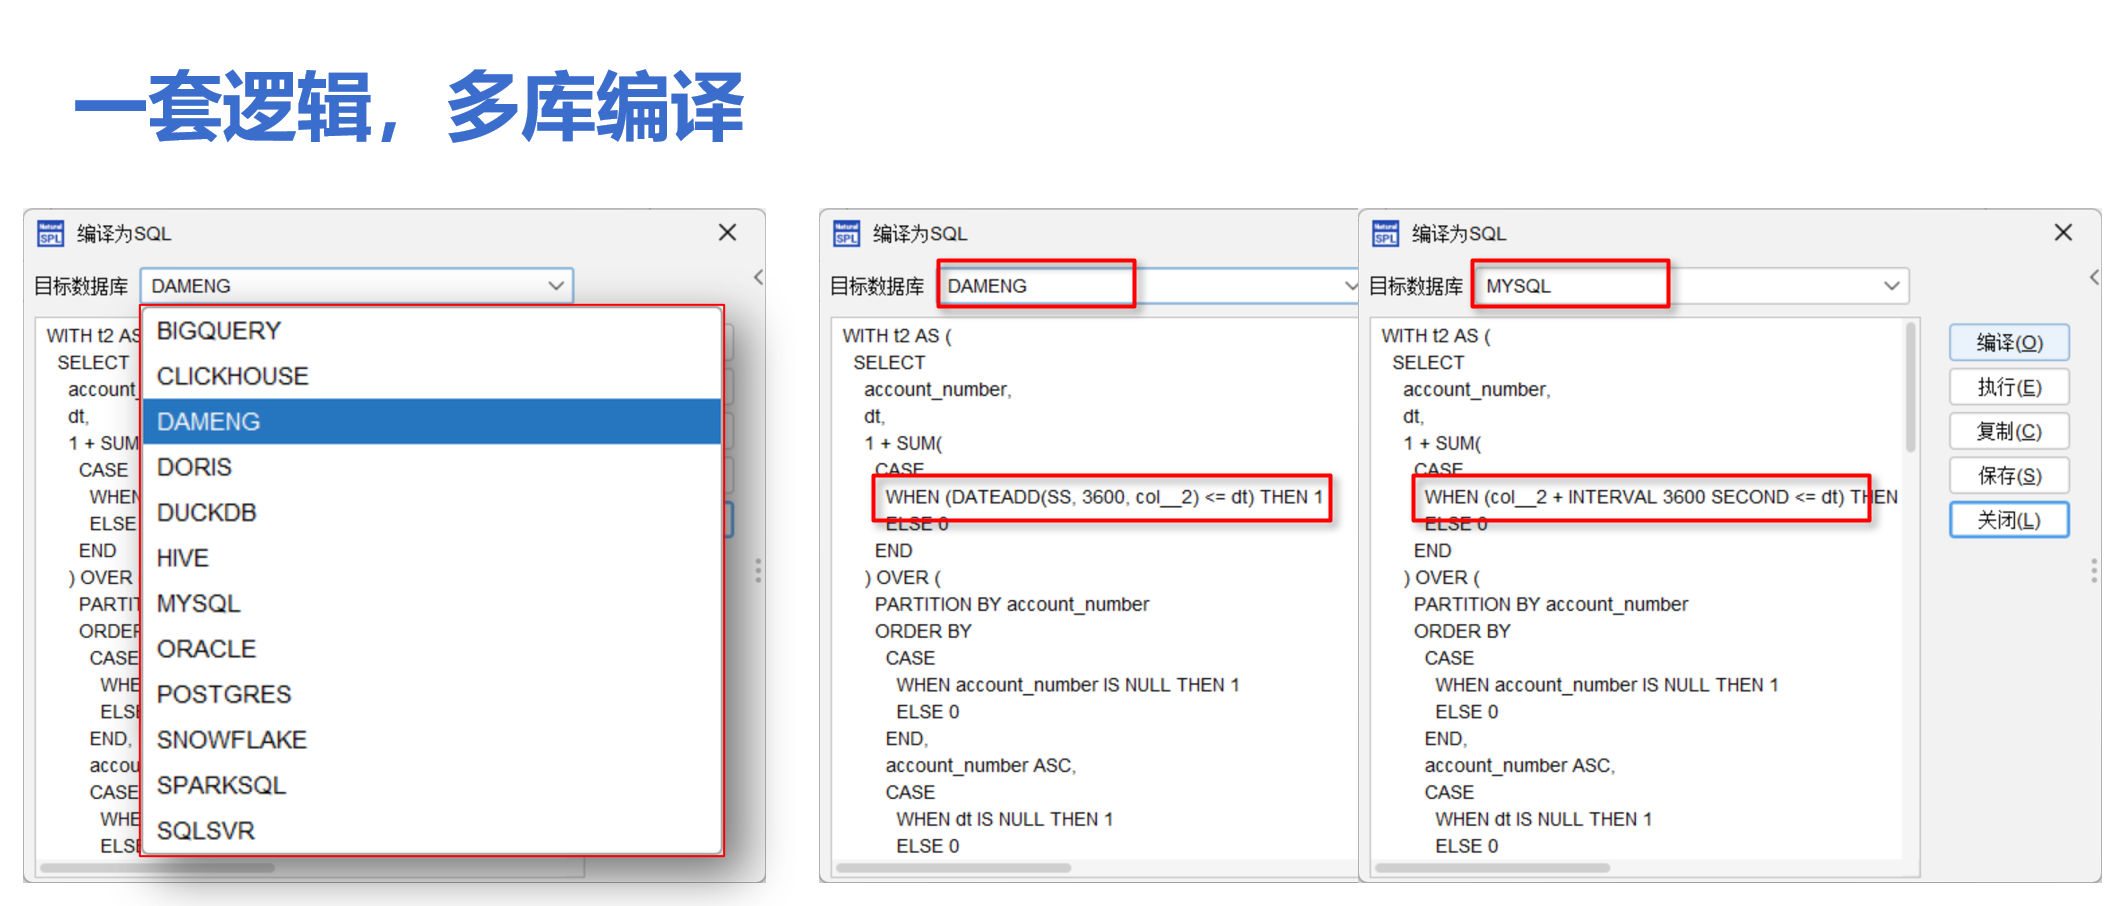
业务逻辑只要编写一套,切换目标数据库只需一键重新编译。输出的是目标数据库的原生 SQL,没有私有运行时,没有厂商绑定。更重要的是:逻辑只需要审计一次,换库编译结果确定性一致,不用每个数据库都重新走一遍审计流程,跨库适配的重复成本被彻底砍掉。
四、AI+MCP 加持:既要效率,也要可信
AI 的效率想要,又怕幻觉和不可审计?SQLazy 通过 MCP 协议开放能力,和 AI 编程工具形成完美互补:AI 负责理解需求、拆解逻辑,SQLazy 负责确定性编译、结果校验,既快又准。
完整链路清晰可控:
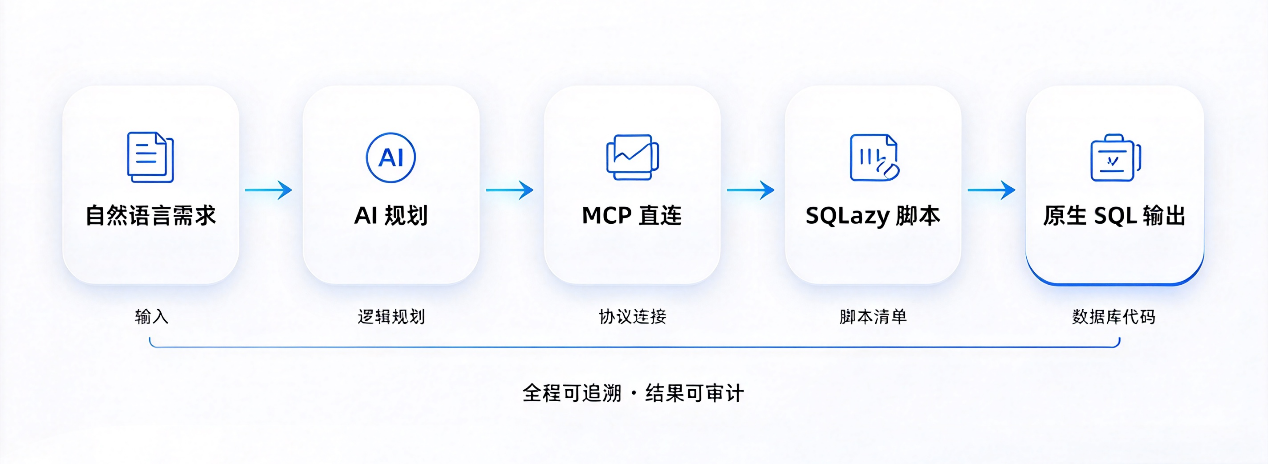
相当于给 AI 配上了 “确定性执行器”。AI 只做语义转译和逻辑拆解,不碰最终代码生成;SQLazy 负责确定性输出和校验。既获得了 AI 的开发效率,又守住了代码的可信度,彻底解决 AI 写 SQL 的审计难题。
比如在安装了 SQLazy SKILL 的 AI 编程工具中输入:
/SQLazy规划 计算月销售额最长连续上涨了几个月?
AI 拆解任务:
第1步:SQLazy 全量能力梳理…
第2步:业务需求拆解…
第3步:函数/功能匹配规划…
第4步:分步 SQLazy 代码实现…
第5步:MCP 校验(前置判定)…
生成脚本:
订单:汇总 合计 订单金额 命名 月销售额 分组 ymonth(订单日期) 命名 年月
分段 月销售额 未变大 命名 段号
汇总 计数 段号 命名 连续上涨月数 分组 段号
汇总 最大 连续上涨月数 命名 最长连续上涨月数
最后编译成 SQL(以 MySQL 为例):
WITH 月度汇总 AS (
  SELECT
    (year(订单日期) * 100 + month(订单日期)) AS 年月,
    SUM(订单金额) AS 月销售额
  FROM
    订单
  GROUP BY
    (year(订单日期) * 100 + month(订单日期))
)
SELECT
  MAX(连续上涨月数) AS 最长连续上涨月数
FROM
  (
    SELECT
      段号,
      COUNT(段号) AS 连续上涨月数
    FROM
      (
        SELECT
          年月,
          月销售额,
          SUM(
            CASE
              WHEN 月销售额 <= col__1 THEN 1
              ELSE 0
            END
          ) OVER (
            ORDER BY
              年月 ROWS UNBOUNDED PRECEDING
          ) + 1 AS 段号
        FROM
          (
            SELECT
              月度汇总.*,
              LAG(月销售额, 1) OVER (
                ORDER BY
                  年月
              ) AS col__1
            FROM
              月度汇总
          ) sub__2
      ) t_3
    GROUP BY
      段号
  ) t_4
五、祖传 SQL 倒译:让历史代码变成可传承资产
企业里大量沉淀的 “祖传 SQL”,嵌套深、无注释、原作者离职,接手不敢改、审计看不懂,是典型的 “维护负债”。直接让 AI 改写?容易偏离原始业务规则,风险更高。
借助 AI+SQLazy,可以将祖传 SQL 逆向倒译为结构化脚本,完成从 “代码黑盒” 到 “可维护资产” 的转变:
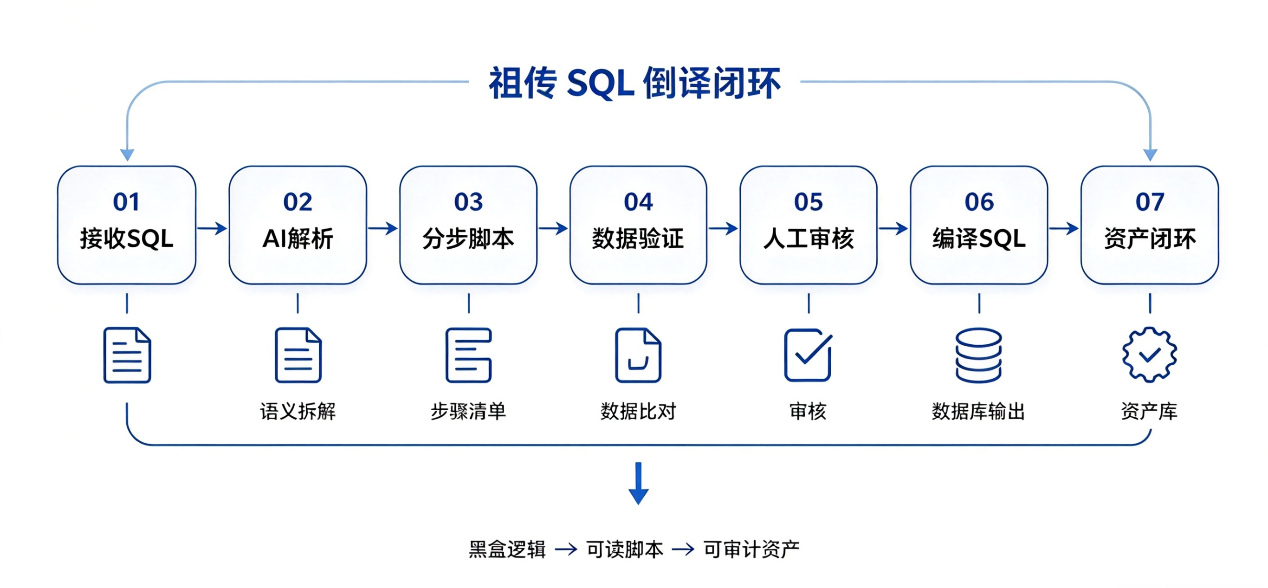
倒译完成后,晦涩的 SQL 变成了线性易读的步骤,脚本即文档,理解、交接和复用都变得很轻松。后续需求变更、数据库迁移,都基于脚本操作,不用再在祖传代码上 “拆弹”。之前难以交接的 SQL 代码从来变成可沉淀可传承的技术资产,人员流动不再造成知识断层。
比如要找出有大量库存、且曾供应过特定零件的供应商
在 AI 中输入原始 SQL:
/SQL倒译
select
	供应商.供应商名称,
	count(*) as 等待次数
from
	订单明细 as 明细1
join 订单 on 明细1.订单ID = 订单.订单ID
join 供应商 on 明细1.供应商ID = 供应商.供应商ID
join 国家 on 供应商.国家ID = 国家.国家ID
where
	订单.订单状态 = 'F'
	and 明细1.实际到货日期 > 明细1.承诺到货日期
	and exists (
		select 1
		from 订单明细 as 明细2
		where
			明细2.订单ID = 明细1.订单ID
			and 明细2.供应商ID <> 明细1.供应商ID
		)
	and not exists (
		select 1
		from 订单明细 as 明细3
		where
			明细3.订单ID = 明细1.订单ID
			and 明细3.供应商ID <> 明细1.供应商ID
			and 明细3.实际到货日期 > 明细3.承诺到货日期
		)
	and 国家.国家名称 = 'SAUDI ARABIA'
group by
	供应商.供应商名称
order by
	等待次数 desc,
	供应商.供应商名称;
(原始 SQL 里 exists 和 not exists 交织在一起,SQL 里要自关联三次,读的人得拿着笔顺藤摸瓜)
AI 拆解分析任务后,最终输出 SQLazy 脚本:
明细=订单明细:导出表 订单ID, 供应商ID, 订单ID.订单状态, 供应商ID.供应商名称, 供应商ID.国家ID.国家名称, 实际到货日期, 承诺到货日期
延迟明细=筛选 (订单状态 = "F" 且 实际到货日期 > 承诺到货日期)
明细:汇总 唯一计数 供应商ID 命名 供应商数 分组 订单ID
多供应商订单=筛选 (供应商数 > 1)
延迟明细:汇总 唯一计数 供应商ID 命名 延迟供应商数 分组 订单ID
唯一延迟供应商订单=筛选 (延迟供应商数 = 1)
候选订单=多供应商订单:匹配 关联表 唯一延迟供应商订单
延迟明细:匹配 关联表 候选订单
筛选 (国家名称 = "SAUDI ARABIA")
汇总 计数 订单ID 命名 等待次数 分组 供应商名称
排序 等待次数 降序, 供应商名称
导出表 供应商名称, 等待次数
(SQLazy 脚本是一条从上到下的流水线:先筛出延迟交货的明细 → 找出多供应商订单 → 从中筛出只有一个供应商延迟的订单 → 匹配回来 → 按沙特供应商汇总等待次数。每一步都是一个中间变量,命名即注释,没有任何嵌套)
本质上,SQLazy 不是在 “另写一种 SQL”,而是把复杂 SQL 从 “黑盒代码” 变成了 “透明的业务逻辑步骤”。
编写时线性清晰,调试时步步可查,跨库时一键编译,交接时自带文档,AI 加持时可控可信。每一个环节都不再依赖个人经验、不再靠运气试错,审计成本自然大幅下降。
对于每天和 SQL 死磕的开发者、分析师,以及需要管控代码质量与交付风险的团队而言,这不是炫技的新工具,而是实实在在降本提效的生产力。