
TRAE + SQLazy MCP 自动化编写 SQL 实践
让 AI 替你写代码,让代码说业务的话
做数据分析写SQL的同学大多有过这样的体验:需求一句话就能说清,落到 SQL 却要写上几十行。一段三十行的 SQL,真正表达业务意图的通常只有几行,剩下的篇幅都在描述一件很机械的事——这两张表要怎么 join、那个比率要乘一百再保留两位小数、那几张维表要一层层连上来。写的人累,读的人更累:得先在脑子里把这些机械描述翻译掉,才能看见业务本身。
有没有办法让代码直接说业务的话?SQLazy 给出的答案是:可以。它是一门面向数据分析的查询语言,每一行几乎都对应一句业务语言——按月汇总销售额、算占比、排个序。写完之后,它既能在 SQLazy IDE 里直接执行,也能一键编译成标准 SQL,交给任意数据库去跑。也就是说,你不需要先学会 SQL 才能做数据查询——学会说业务的话,就够了。
而本文要讲的,是更进一步的实践:在 TRAE 里接入 SQLazy MCP 之后,连这几行业务化的代码都不用自己写了——你用自然语言描述需求,AI 自动生成 SQLazy 脚本、自动生成测试数据、自动验证结果,甚至能把存量 SQL 反向翻译成 SQLazy。下面先通过几组对比看看 SQLazy 有多简单,再手把手走一遍 TRAE + SQLazy MCP 的自动化流程。
一、先看一组对比:同一个需求,两种写法
下面用同一批示例数据(客户、订单、订单明细、零件、零件供应、供应商、国家、地区),把 SQL 写法和 SQLazy 写法放在一起,看看省下来的到底是什么。
1. percent():把占比这个口径,收敛成一个词
占百分之多少,几乎是所有报表里出现频率最高的口径。它的算法毫无争议——乘以 100、保留两位小数——但每次都要手写一遍 round(x * 100, 2),而且每个人写的位数、乘的位置还可能不一样,口径天然容易走样。现在有了 percent(x),语义等价于 round(x * 100, 2),一个函数把整个口径固定下来:看到 percent,就知道是百分比。
例:各运输方式的销售额占比。
SQL 写法
select 运输方式,
       sum(订购金额) as 销售额,
       round(sum(订购金额) / (select sum(订购金额) from 订单明细) * 100, 2) as 销售额占比
from 订单明细
group by 运输方式
order by 销售额 desc
SQLazy 写法
运输统计=订单明细:汇总 合计 订购金额 命名 销售额 分组 运输方式
全站=汇总 合计 销售额 命名 全站销售额
运输统计:计算列 percent(销售额/全站.全站销售额) 命名 销售额占比
排序 销售额 降序
SQL 里那行 round(...),读者要先定位子查询、再确认乘 100 的位置、最后数一数保留几位;而 percent(...) 一眼就是占比。口径被函数固化之后,换个人来写、换张表来算,结果都是同一个口径。
2. 关联不用再写主键:拼接、匹配的省略写法
关联条件里最没有信息量的一类,就是两边都是主键。既然表结构里已经声明了主键是什么,写代码时就没必要再重复一遍。SQLazy 支持三种省略:
· 两侧都省略:两表按各自的主键关联(要求主键能一一对应);
· 只省略一侧:该侧用自己的主键去匹配另一侧写出的关联列;
· 主子表关联:用主表的主键关联子表时,主表和子表侧的关联字段都可以不写——子表只用复合主键的一部分就够了。
例 1:按零件统计库存总价值,并补上零件名称与品牌。
SQL 写法
select p.零件ID, p.零件名称, p.品牌,
       sum(ps.库存量 * ps.成本价) as 库存总价值
from 零件供应 ps
join 零件 p on ps.零件ID = p.零件ID
group by p.零件ID, p.零件名称, p.品牌
SQLazy 写法
零件供应:汇总 合计 库存量*成本价 命名 库存总价值 分组 零件ID
拼接 关联表 零件 拼接列 零件名称,品牌
关键在第二行:库存的分组字段零件ID 自动成为结果集的主键,零件表的主键也是零件ID,两侧主键同名可对应,于是关联列一个都不用写——SQLazy自动按主键关联,代码更清爽。
例 2:找出还没有任何供应商供应的零件。
SQL 写法
select p.零件ID, p.零件名称
from 零件 p
where not exists (select 1 from 零件供应 ps where ps.零件ID = p.零件ID)
SQLazy 写法
零件:匹配 关联表 零件供应 不存在
一行。not exists 子查询被压成了一个匹配……不存在,而且读起来就是它的字面意思。
3. 导出表支持「.」操作符:外键字段随用随取
补外键表列是另一类高频机械劳动:明细表里只有零件ID、供应商ID,要看懂就得把它们对应的名称一层层 join 上来。SQLazy的导出表功能支持 「.」操作符,可以直接顺着外键引用外键表的字段,多级外键还能链式书写。想补哪个字段就写哪个,不必先写一段取数语句把宽表拼出来。
例:延迟交货分析,补上零件、品牌、供应商与供应商所在国家。
SQL 写法
select d.订单ID, d.零件ID, p.零件名称, p.品牌,
       s.供应商名称, n.国家名称 as 供应商国家,
       d.承诺到货日期, d.实际到货日期
from 订单明细 d
join 零件   p on d.零件ID   = p.零件ID
join 供应商 s on d.供应商ID = s.供应商ID
join 国家   n on s.国家ID   = n.国家ID
where d.实际到货日期 > d.承诺到货日期
SQLazy 写法
订单明细:筛选 实际到货日期 > 承诺到货日期
导出表 追加 零件ID.零件名称, 零件ID.品牌, 供应商ID.供应商名称,供应商ID.国家ID.国家名称
四表的 join 被压缩成四个表达式,其中供应商ID.国家ID.国家名称是链式写法(订单明细 → 供应商 → 国家)。读代码时,视线不必在 join 区和 where 区之间来回跳,语序和给这些记录补上零件名、品牌、供应商名、国家名这句话完全一致。更实用的是:这些外键表字段可以等计算结束后再补,中间步骤始终是窄表,既省事也省心。
4. 综合案例:五行完成占比 + 外键 + 排序
把上面的能力放进同一个需求:统计每个客户的销售额及其占全站的百分比,补上客户名称与所属行业,按销售额从高到低排。
SQL 写法
select c.客户ID, c.客户名称, c.行业,
       sum(o.订单金额) as 销售额,
       round(sum(o.订单金额) / (select sum(订单金额) from 订单) * 100, 2) as 销售额占比
from 订单 o
join 客户 c on o.客户ID = c.客户ID
group by c.客户ID, c.客户名称, c.行业
order by 销售额 desc
SQLazy 写法
客户销售=订单:汇总 合计 订单金额 命名 销售额 分组 客户ID
全站=汇总 合计 销售额 命名 全站销售额
客户销售:计算列 percent(销售额/全站.全站销售额) 命名 销售额占比
导出表 追加 客户ID.客户名称,客户ID.行业
排序 销售额 降序
五行代码,每行一句业务语言:按客户汇总销售额 → 算全站总额 → 算占比 → 补客户名称与行业 → 排序。没有 join,没有子查询,也没有 round 里嵌套除法。更实际的收益是改起来轻松:想把口径从占全站改成占本行业,只改一行分组;想多带一个字段,只在导出表里加一项。
二、SQLazy 为什么比 SQL 更好学
当然,真正让 SQLazy 区别于直接写 SQL 的核心优势是以下这些:
分步可验证、可审计:SQLazy 的每一步都是独立的计算动作,每一步都可以单独执行、单独预览中间结果。写完一步就能看到这一步的输出,不需要等整个查询跑完才发现问题。review 时看的是步骤,不是百行嵌套——哪一步对、哪一步错,点开就知道。这是 SQLazy 最根本的优势:把 SQL 开发从一个不可审计的黑盒,变成一个可逐步验证的流程。
零幻觉、确定性编译:AI 生成 SQL 最大的问题是不可信:可能编造字段名、可能写错语法、可能幻觉出不存在的函数。SQLazy 把这个问题从根上解决了——AI 只负责把自然语言翻译成步骤化的逻辑,最终 SQL 由确定性编译器生成。同一份逻辑永远编译出同一份 SQL,不编字段、不幻觉。你不需要赌 AI 的正确率,编译器替你保证了正确性。
跨数据库适配:同一份 SQLazy 脚本,可以编译成 Oracle、MySQL、PostgreSQL、达梦等不同数据库的 SQL 方言。写一遍,到处跑——数据库迁移、跨库对比、国产化替代,都不需要重写查询。编译器负责处理各家 SQL 方言的差异,你只管业务逻辑。
存量 SQL 可倒译:已经有一堆写好的、没人敢动的祖传 SQL?AI 能把它反向翻译成等价的 SQLazy 分步脚本,然后每一步都可读、可改、可验证。翻译完之后,逻辑还是那个逻辑,但代码从晦涩冗长变成了简明易读,维护成本大幅降低,代码真正成为资产。
需求变更只改对应步骤:SQL 的需求变更往往意味着整段重写;而在 SQLazy 里,改一个筛选条件、换一个分组字段、加一个维度列,只需要动对应的那一步,其他步骤不受影响。AI 也不需要重新生成整段代码,只改变化的部分即可。
这些才是 SQLazy 真正的价值所在!前面举例内容只是在这个大框架上实现的代码逻辑的四个小优点。想了解更多,可以到官网论坛查阅 SQLazy 相关文章。
三、TRAE + SQLazy MCP 实战:你说需求,AI 写 SQLazy
SQLazy 已经足够简单,那还能不能再简单一点?能——让 AI 替你写。SQLazy 为 TRAE 提供了 SKILL 和 MCP 服务,接入之后,TRAE 里的 AI 助手可以直接读写 SQLazy 脚本、连接内存表和数据库验证结果。整个过程分三步准备、三段实战。
3.1 环境准备(三步)
第一步:安装 SQLazy IDE。从官网 https://www.raqsoft.com.cn/download-SQLazy 下载安装。启动后点击【工具/内存表】→【导入】,选择例子数据.ndb——这是本文示例用到的测试数据,实际使用时请替换成自己的数据。系统运行时会自动读取内存表的表结构、数据类型、主外键关系,并用内存表里的数据测试结果代码,所以把测试数据放进内存表,AI 验证代码时就有据可依。
第二步:启动 MCP 服务。点击【工具/启动MCP服务】。注意:如果替换了例子数据,需要重启 MCP 服务。
第三步:在 TRAE 中启用 SQLazy-MCP。打开 SQLazy 安装目录下的 MCP/TraeCode 文件夹(不同版本目录名可能略有差异,以实际安装目录为准),在 TRAE 的 MCP 设置中激活 SQLazy-MCP。到这里,TRAE 就具备了读写 SQLazy 脚本、操作内存表和数据库的全部能力。
3.2 实战一:一句话自动生成查询代码
在 TRAE 对话框输入指令,先写 SQLazy规划,再写查询目标:
SQLazy规划 计算月销售额最长连续上涨了几个月?
按回车,等待输出。
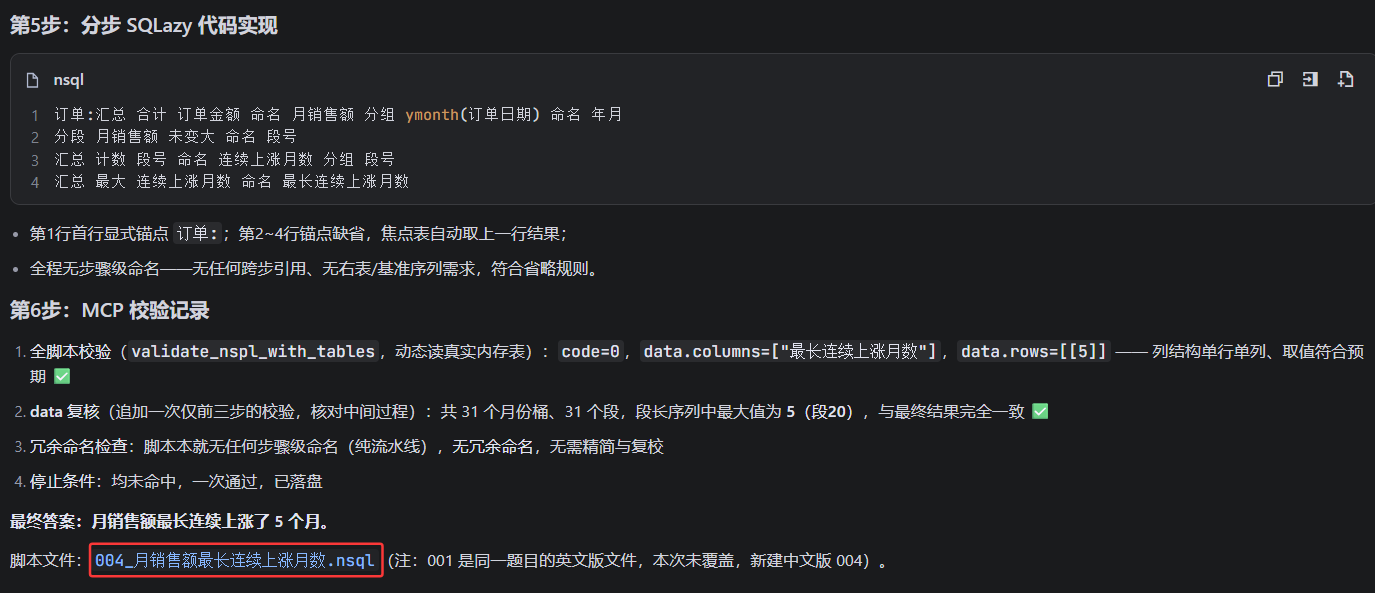
输出里除了思考过程,最终会出现交付字样和生成的脚本文件名——AI 已经把结果代码写进了这个文件。用 SQLazy IDE 打开它:
订单:汇总 合计 订单金额 命名 月销售额 分组 ymonth(订单日期) 命名 年月
分段 月销售额 未变大 命名 段号
汇总 计数 段号 命名 连续上涨月数 分组 段号
汇总 最大 连续上涨月数 命名 最长连续上涨月数
四行。逐行读,就是四句业务语言:按月汇总销售额 → 标记销售额环比未变大的分段 → 按段数一数连续上涨了几个月 → 取最大的那段。这个最长连续上涨问题如果用 SQL 写,窗口函数嵌套自关联起步,没有三层子查询根本下不来;而 SQLazy 的分段一个动词就把它说完了。更重要的是——这四行你还不用自己写,TRAE 已经替你写好;而且相信你已经发现,你居然能直接看懂它。
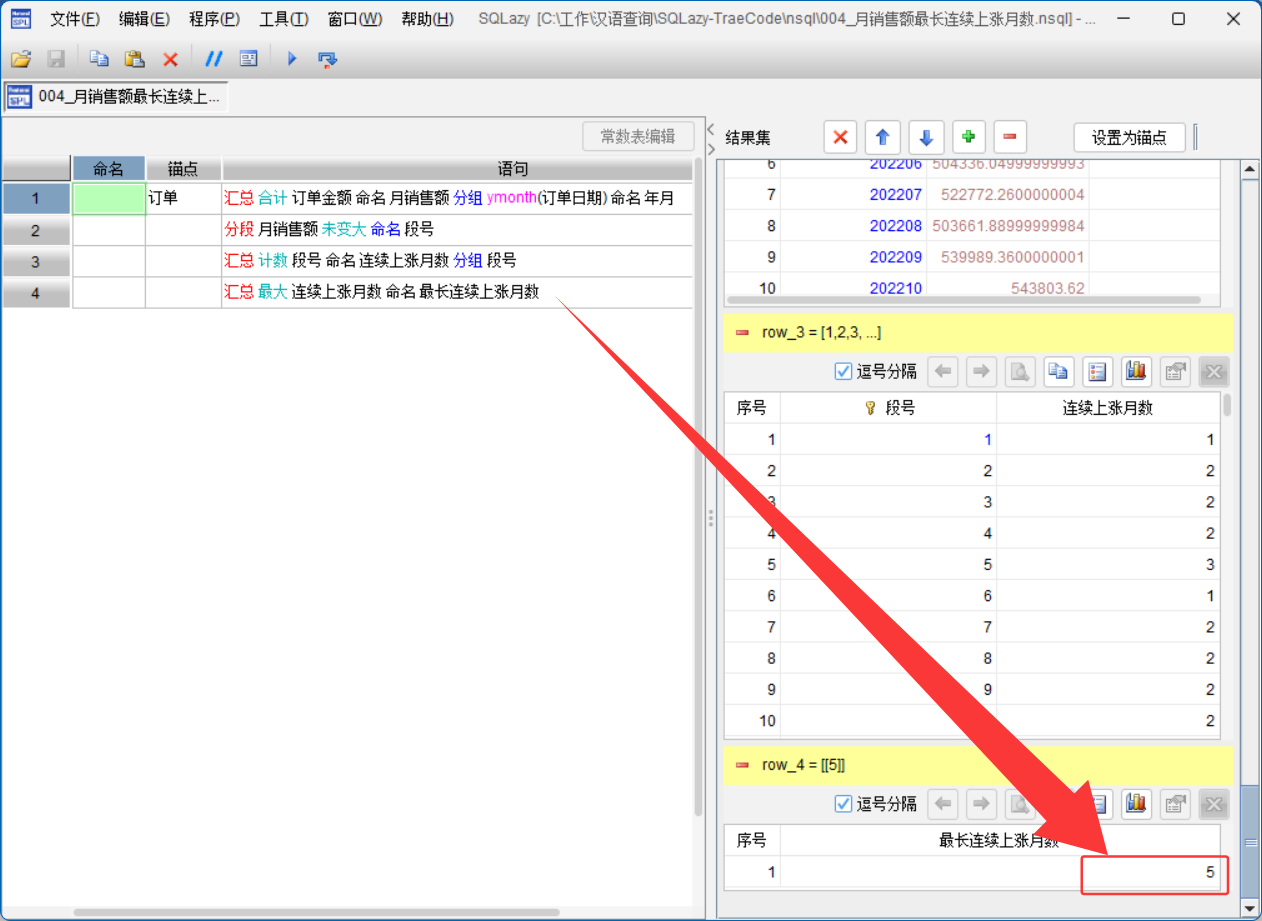
点击【执行】,结果直接出来。要落到数据库里跑?点击【工具/数据连接】连上数据库,再点击【程序/编译SQL】:
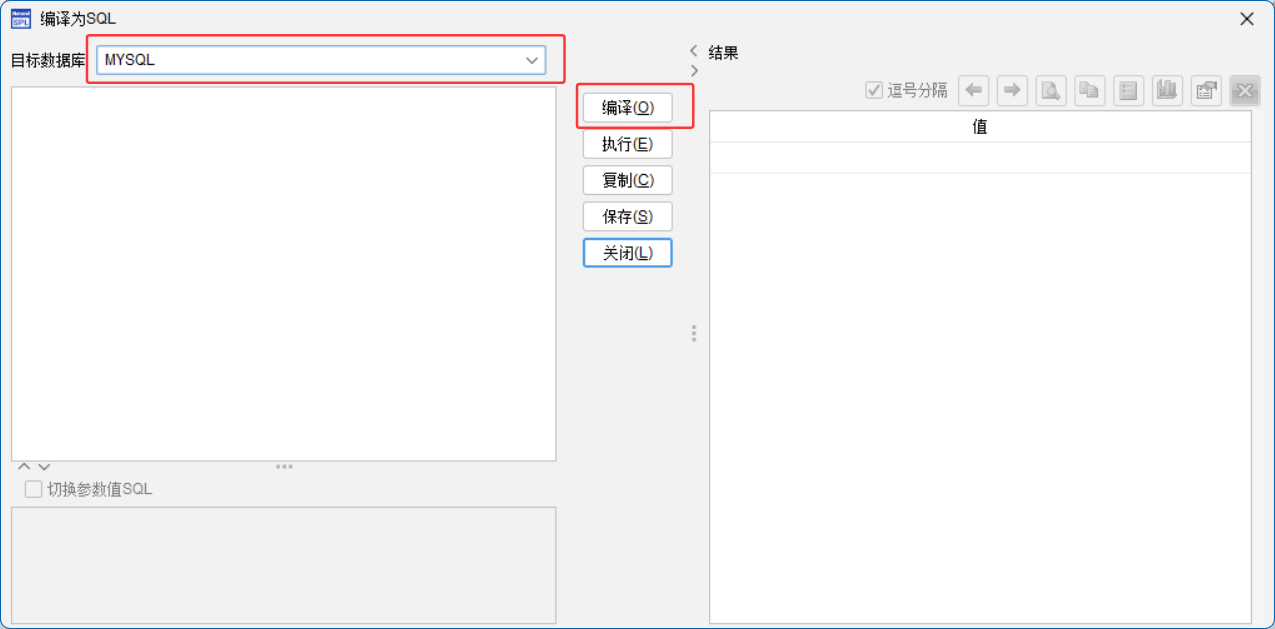
先选择目标数据库类型,然后点击编译按钮:
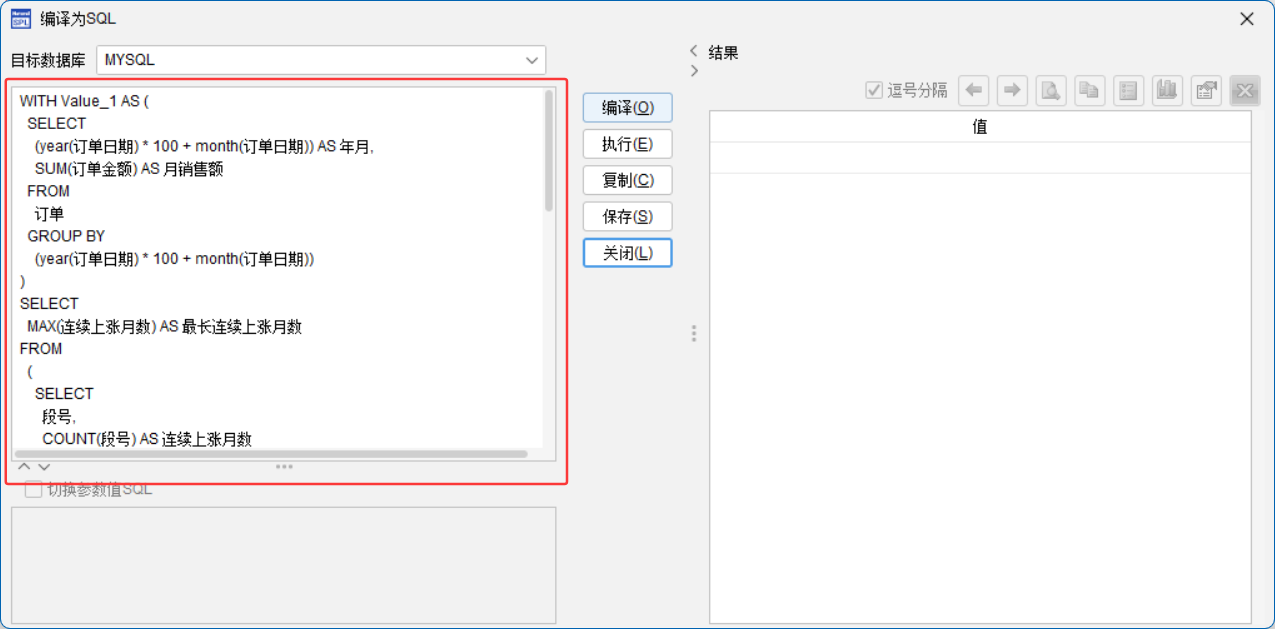
也可以选其它类型的数据库,点编译,一键出结果,比如选ORACLE:
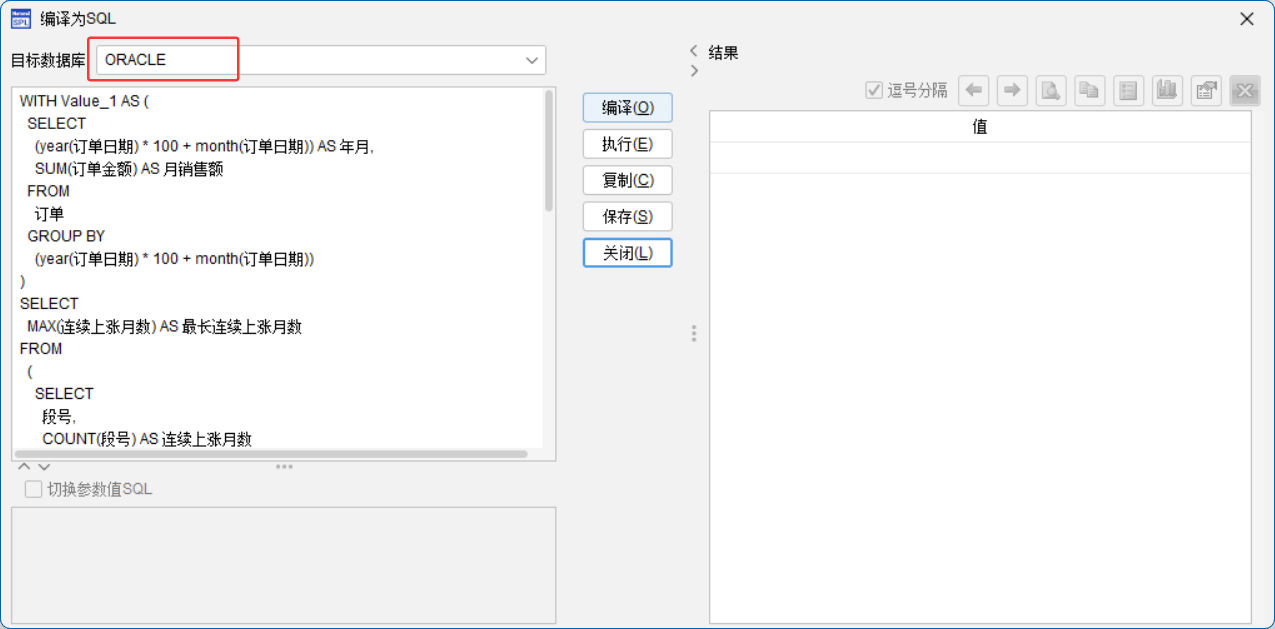
从这一步可以体会到前述的跨数据库适配的好处。
SQL 已经生成好了,点击执行按钮:
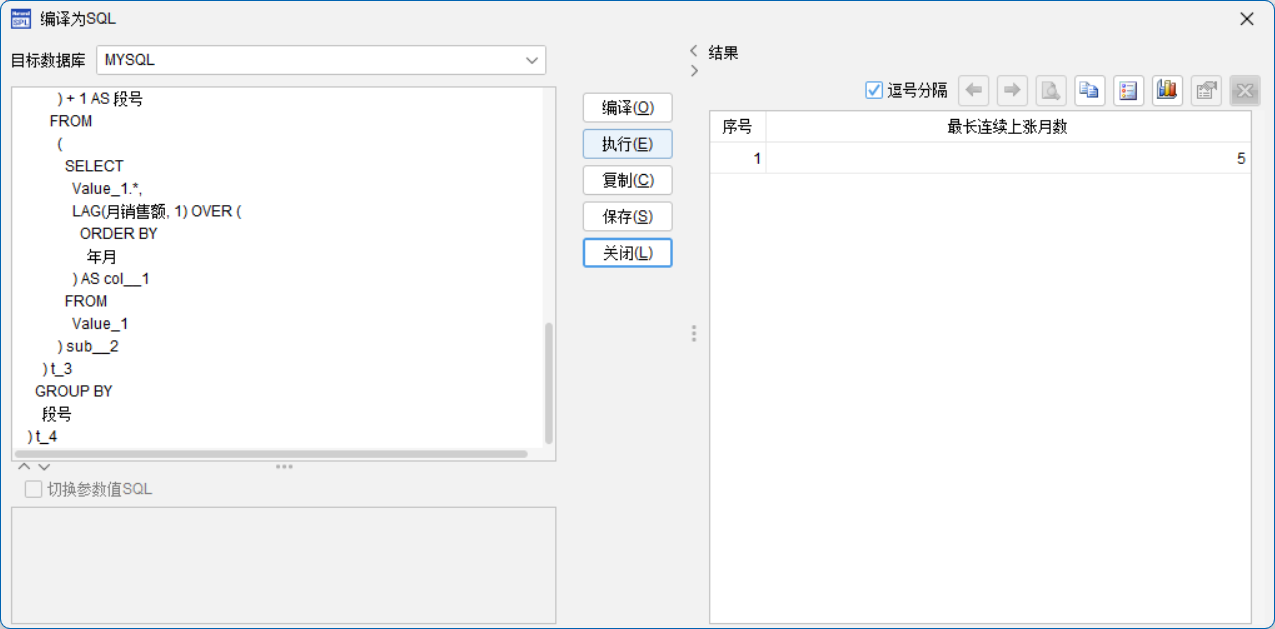
编译出的 SQL 在数据库里执行,结果和 SQLazy 脚本完全一致(前提是内存表数据和数据库一致)。写的是 SQLazy,跑的是 SQL——学习 SQL 的那道坎,就这么迈过去了。
3.3 实战二:测试数据自动造
写查询之前得先有数据。SQLazy 的生成测试用例能力,可以按你的业务描述自动造数,而且会同时写入 .ndb 文件和 SQLazy IDE 当前连接的数据库——天然保证两边一致。
造数之前,先确保已打开 SQLazy IDE 且 MCP 服务在运行中,并在【工具/数据连接】里连上目标数据库(界面显示已连接)。然后在 TRAE 对话框输入 生成测试用例,后面跟上对表结构和数据逻辑的描述。例如描述 8 张表(地区、国家、零件、供应商、零件供应、客户、订单、订单明细)及各自字段,再说明数据逻辑:订单大概每年 3000~5000 条、覆盖 2022—2026 年;订单明细是订单的子表,一条订单对应 1~5 条明细;日期字段要符合业务相关性——发货日期晚于订单日期、承诺到货日期晚于发货日期、实际到货日期大多接近承诺日期;各 ID 字段按外键关系取自对应维表……
按回车,等待输出:
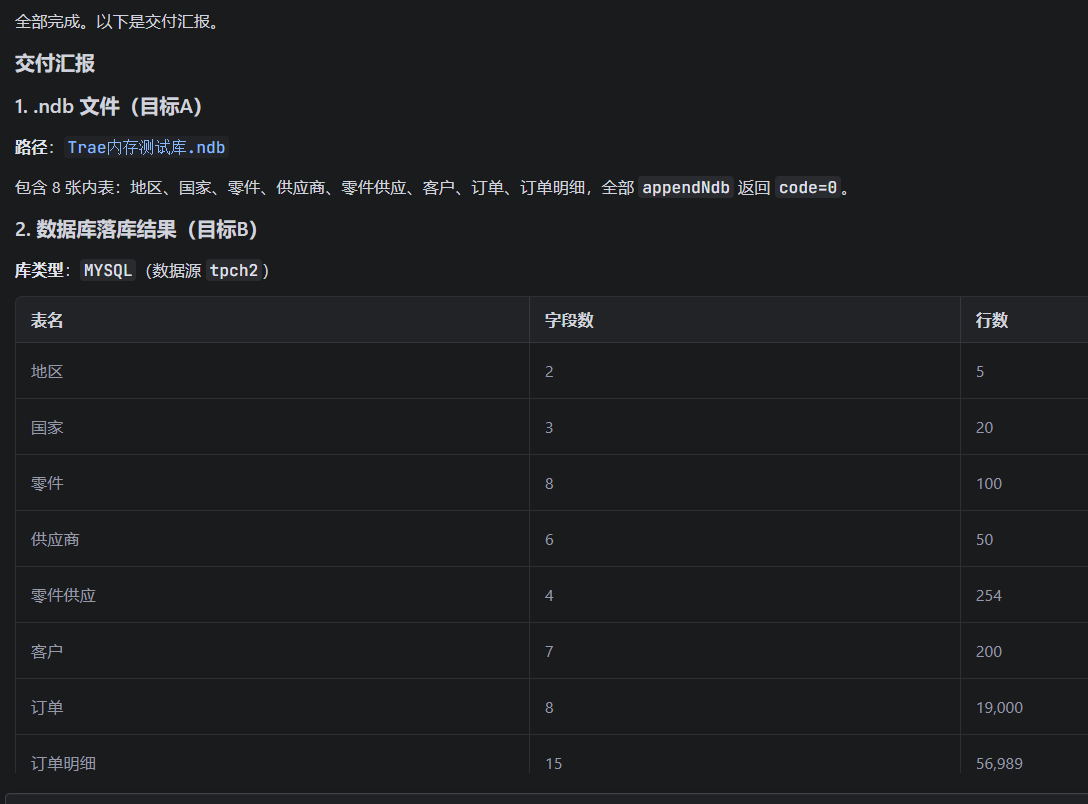
从输出提示中可以看到,结果数据已经同时写入 ndb 目录下的 .ndb 文件和 SQLazy IDE 当前连接的数据库。在 SQLazy IDE 中点击【工具/内存表】→【导入】,选择生成的 .ndb 文件:
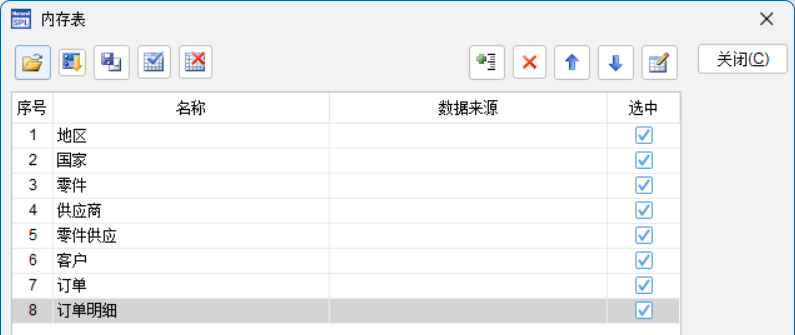
通过这种方式造的测试数据,天然满足内存表 = 数据库,后面无论验证 SQLazy 代码还是比对 SQL 翻译结果,都不会因为两边数据不一致而误判。
小提示:如果数据库里或 ndb 目录下已有同名对象,系统会停下来询问(A 删除并替换 / B 保留原表 / C 自定义回答),按需选择即可;不选择会一直等待。
3.4 实战三:存量 SQL 一键倒译成 SQLazy
已经有一堆写好的 SQL?不用重写。先在【工具/数据连接】里连上存放这些表的数据库(它用于执行待翻译的 SQL,与 SQLazy 的运行结果做对比),然后在对话框输入 SQL倒译,后面跟上 SQL 语句:
SQL倒译 select
    供应商国家.国家名称 as 供应商国家,
    客户国家.国家名称 as 客户国家,
    year(订单明细.发货日期) as 年份,
    sum(订单明细.订购金额 * (1 - 订单明细.折扣率)) as 收入
from
    订单明细
    join 订单 on 订单明细.订单ID = 订单.订单ID
    join 客户 on 订单.客户ID = 客户.客户ID
    join 供应商 on 订单明细.供应商ID = 供应商.供应商ID
    join 国家 as 供应商国家 on 供应商.国家ID = 供应商国家.国家ID
    join 国家 as 客户国家 on 客户.国家ID = 客户国家.国家ID
where
    (
        (供应商国家.国家名称 = '法国' and 客户国家.国家名称 = '德国')
        or (供应商国家.国家名称 = '德国' and 客户国家.国家名称 = '法国')
    )
    and 订单明细.发货日期 between '2022-01-01' and '2026-12-31'
group by
    供应商国家.国家名称,
    客户国家.国家名称,
    year(订单明细.发货日期)
order by
    供应商国家.国家名称,
    客户国家.国家名称,
    year(订单明细.发货日期);
按回车,等待结果:
从输出结果里可以直接看到 SQL 执行结果与 .nsql 执行结果的逐项比对情况:
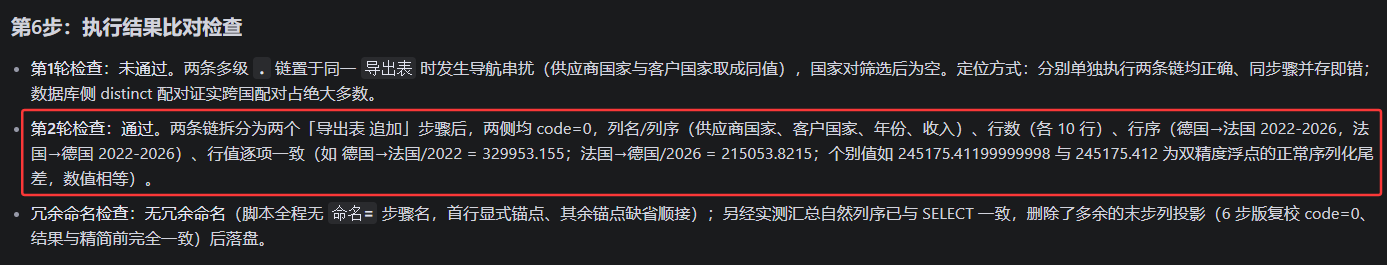
确认结果一致后,用 SQLazy IDE 打开生成的 .nsql 文件即可直接使用。存量 SQL 资产可以平滑迁移,新老两种写法在同一个工作流里各得其所。
四、复杂查询也不在话下
有人会问:简单查询当然好写,复杂查询呢?下面从实测案例里挑三个典型的 SQL 重灾区——多表 join、多层嵌套子查询、窗口函数——看看同样的需求,两种写法各是什么样子。这些案例的 SQLazy 代码,同样都是由 TRAE 通过一句 SQLazy规划 或 SQL倒译 指令自动生成的。
4.1 TPC-H Q7:五张表 join,按国家和年份统计收入
SQL 写法
select
  供应商国家.国家名称 as 供应商国家,
  客户国家.国家名称 as 客户国家,
  year(订单明细.发货日期) as 年份,
  sum(订单明细.订购金额 * (1 - 订单明细.折扣率)) as 收入
from
  订单明细
  join 订单 on 订单明细.订单ID = 订单.订单ID
  join 客户 on 订单.客户ID = 客户.客户ID
  join 供应商 on 订单明细.供应商ID = 供应商.供应商ID
  join 国家 as 供应商国家 on 供应商.国家ID = 供应商国家.国家ID
  join 国家 as 客户国家 on 客户.国家ID = 客户国家.国家ID
where
  (
  (供应商国家.国家名称 = '法国' and 客户国家.国家名称 = '德国')
  or (供应商国家.国家名称 = '德国' and 客户国家.国家名称 = '法国')
  )
  and 订单明细.发货日期 between '2022-01-01' and '2026-12-31'
group by
  供应商国家.国家名称,
  客户国家.国家名称,
  year(订单明细.发货日期)
order by
  供应商国家.国家名称,
  客户国家.国家名称,
  year(订单明细.发货日期);
SQLazy 写法
导出表 订单ID, 供应商ID, 发货日期, 订购金额, 折扣率, 供应商ID.国家ID.国家名称 命名 供应商国家, 订单ID.客户ID.国家ID.国家名称 命名 客户国家
筛选 (发货日期 >= 2022年01月01日) 且 (发货日期 <= 2026年12月31日) 且 (((供应商国家 = "FRANCE") 且 (客户国家 = "GERMANY")) 或 ((供应商国家 = "GERMANY") 且 (客户国家 = "FRANCE")))
汇总 合计 订购金额 * (1 - 折扣率) 命名 收入 分组 供应商国家, 客户国家, year(发货日期) 命名 年份
导出表 供应商国家, 客户国家, 年份, 收入
五张表的 join,被「.」链式引用取代——供应商ID.国家ID.国家名称、订单ID.客户ID.国家ID.国家名称,顺着外键走就是了。人工检查也只是读四句话:取数、筛选、汇总、导出。
4.2 TPC-H Q20:三层嵌套子查询,找出有大量库存的供应商
SQL 写法
select
  供应商.供应商名称,
  供应商.供应商地址
from
  供应商
  join 国家 on 供应商.国家ID = 国家.国家ID
where
  供应商.供应商ID in (
    select 零件供应.供应商ID
    from 零件供应
    where
      零件供应.零件ID in (
        select 零件.零件ID from 零件 where 零件.零件名称 like '%轴%'
      )
      and 零件供应.库存量 > (
        select 0.5 * sum(订单明细.订购数量)
        from 订单明细
        where
          订单明细.零件ID = 零件供应.零件ID
          and 订单明细.供应商ID = 零件供应.供应商ID
          and 订单明细.发货日期 >= '2022-01-01'
          and 订单明细.发货日期 < '2026-01-01'
      )
  )
  and 国家.国家名称 = 'CANADA'
order by
  供应商.供应商名称;
SQLazy 写法
轴类零件=零件:筛选 (零件名称 串匹配 "%轴%")
订单明细:筛选 (发货日期 >= 2022年01月01日 且 发货日期 < 2026年01月01日)
汇总 合计 订购数量 命名 历史数量 分组 零件ID, 供应商ID
拼接 零件ID 供应商ID 关联表 零件供应 零件ID 供应商ID 拼接列 库存量 内连接
匹配 零件ID 关联表 轴类零件
候选供应=筛选 (库存量 > 0.5 * 历史数量)
供应商:导出表 供应商ID, 供应商名称, 供应商地址, 国家ID.国家名称
筛选 (国家名称 = "CANADA")
匹配 关联表 候选供应 供应商ID
排序 供应商名称
导出表 供应商名称, 供应商地址
SQL 版本里三层 in 子查询层层相扣,相关子查询还引用了外层字段,读的时候得拿着笔顺藤摸瓜。SQLazy 版本是一条从上到下的流水线:筛出轴类零件 → 汇总历史订购量 → 拼接库存 → 匹配 → 筛出候选 → 从加拿大供应商里再匹配。每一步都是一个中间变量,命名即注释。
4.3 窗口函数:每个客户订单金额的环比与累计
SQL 写法
select 客户名称, 订单ID, 订单日期, 订单金额, 上一笔订单金额, 与上一笔差额,
       客户历史平均订单金额, 是否高于历史平均, 客户累计订单金额
from (
  select 客户.客户名称, 订单.订单ID, 订单.订单日期, 订单.订单金额,
    lag(订单.订单金额, 1) over (
      partition by 订单.客户ID order by 订单.订单日期, 订单.订单ID) as 上一笔订单金额,
    订单.订单金额 - lag(订单.订单金额, 1) over (
      partition by 订单.客户ID order by 订单.订单日期, 订单.订单ID) as 与上一笔差额,
    avg(订单.订单金额) over (partition by 订单.客户ID) as 客户历史平均订单金额,
    case when 订单.订单金额 > avg(订单.订单金额) over (partition by 订单.客户ID)
         then '高于平均' else '不高于平均' end as 是否高于历史平均,
    sum(订单.订单金额) over (
      partition by 订单.客户ID order by 订单.订单日期, 订单.订单ID
      rows between unbounded preceding and current row) as 客户累计订单金额
  from 订单
  join 客户 on 订单.客户ID = 客户.客户ID
) as t
order by 客户名称, 订单日期, 订单ID;
SQLazy 写法
订单:导出表 订单ID,客户ID,客户ID.客户名称,订单日期,订单金额
排序 客户ID,订单日期,订单ID
计算列 平均 订单金额 命名 客户历史平均订单金额,
       订单金额[-1] 命名 上一笔订单金额,
       订单金额-上一笔订单金额 命名 与上一笔差额,
       条件((订单金额 > 客户历史平均订单金额) 则 "高于平均";否则 "不高于平均") 命名 是否高于历史平均,
       订单金额 累计 命名 客户累计订单金额 分区 客户ID
排序 客户名称,订单日期,订单ID
导出表 客户名称,订单ID,订单日期,订单金额,上一笔订单金额,与上一笔差额,客户历史平均订单金额,是否高于历史平均,客户累计订单金额
lag(...) over (partition by ... order by ...) 要写两遍,avg over 也要写两遍,再加一句 rows between unbounded preceding and current row——这些恰恰是 SQL 学习曲线最陡的部分。SQLazy 用订单金额[-1]表示上一行,用分区 客户ID表示按客户分区,用订单金额 累计表示累计求和。窗口函数的三个概念——分区、排序、帧——全部变成了字面词汇。
4.4 TPC-H Q8:七张表 join,按年份统计巴西市场份额
SQL 写法
select
年份,
sum(case when 供应商国家.国家名称 = 'BRAZIL' then 金额 else 0 end) / sum(金额) as 市场份额
from
(
select
year(订单.订单日期) as 年份,
订单明细.订购金额 * (1 - 订单明细.折扣率) as 金额,
供应商国家.国家名称 as 供应商国家名称
from
订单明细
join 订单 on 订单明细.订单ID = 订单.订单ID
join 客户 on 订单.客户ID = 客户.客户ID
join 国家 as 客户国家 on 客户.国家ID = 客户国家.国家ID
join 地区 on 客户国家.地区ID = 地区.地区ID
join 供应商 on 订单明细.供应商ID = 供应商.供应商ID
join 国家 as 供应商国家 on 供应商.国家ID = 供应商国家.国家ID
join 零件 on 订单明细.零件ID = 零件.零件ID
where
地区.地区名称 = 'AMERICA'
and 订单.订单日期 between '2022-01-01' and '2026-12-31'
and 零件.零件类型 = 'PROMO PLATED STEEL'
) as 全部国家
group by
年份
order by
年份;
SQLazy 写法
订单明细:导出表 订购金额, 折扣率, 订单ID.订单日期, 订单ID.客户ID.国家ID.地区ID.地区名称, 供应商ID.国家ID.国家名称 as 供应商国家名称, 零件ID.零件类型
筛选 (地区名称 = "AMERICA") 且 (零件类型 = "PROMO PLATED STEEL") 且 (订单日期 >= 2022年01月01日) 且 (订单日期 <= 2026年12月31日)
计算列 year(订单日期) 命名 年份, 订购金额 * (1 - 折扣率) 命名 金额, 条件(供应商国家名称 = "BRAZIL" 则 订购金额 * (1 - 折扣率) 否则 0) 命名 巴西金额
汇总 合计 巴西金额 命名 巴西金额合计, 合计 金额 命名 总金额 分组 年份
计算列 巴西金额合计 / 总金额 命名 市场份额
排序 年份
导出表 年份, 市场份额
七张表的 join 加一个子查询套 case when,在 SQLazy 里变成一句宽表取数 → 筛选 → 计算列 → 汇总 → 计算占比 → 排序 → 导出,共 7 步。子查询被压成计算列,case when 被条件函数取代,读代码就是读业务流程。
4.5 TPC-H Q9:六表 join 加双字段关联,按国家和年份统计零件利润
SQL 写法
select
国家名称,
年份,
sum(利润) as 总利润
from
(
select
国家.国家名称 as 国家名称,
year(订单.订单日期) as 年份,
订单明细.订购金额 * (1 - 订单明细.折扣率)
- 零件供应.成本价 * 订单明细.订购数量 as 利润
from
订单明细
join 订单 on 订单明细.订单ID = 订单.订单ID
join 零件 on 订单明细.零件ID = 零件.零件ID
join 供应商 on 订单明细.供应商ID = 供应商.供应商ID
join 国家 on 供应商.国家ID = 国家.国家ID
join 零件供应
on 零件供应.零件ID = 订单明细.零件ID
and 零件供应.供应商ID = 订单明细.供应商ID
where
零件.零件名称 like '%轴%'
) as 利润表
group by
国家名称,
年份
order by
国家名称,
年份 desc;
SQLazy 写法
订单明细:导出表 零件ID, 供应商ID, 订购金额, 折扣率, 订购数量, 订单ID.订单日期, 零件ID.零件名称, 供应商ID.国家ID.国家名称
拼接 零件ID 供应商ID 关联表 零件供应 零件ID 供应商ID 拼接列 成本价 内连接
筛选 (零件名称 串匹配 "%轴%")
计算列 year(订单日期) 命名 年份, 订购金额 * (1 - 折扣率) - 成本价 * 订购数量 命名 利润
汇总 合计 利润 命名 总利润 分组 国家名称, 年份
排序 国家名称, 年份 降序
导出表 国家名称, 年份, 总利润
六张表的 join,其中零件供应需要按零件ID和供应商ID双字段关联——SQL 里要写 on ... and ...,SQLazy 里一行「拼接 零件ID 供应商ID 关联表 零件供应 零件ID 供应商ID」就搞定。子查询被压成计算列,利润公式直接写成业务表达式,读起来就是一句话:取数 → 补成本价 → 筛轴类零件 → 算利润 → 按国家和年份汇总。
4.6 TPC-H Q21:exists 与 not exists 交织,找出发货延迟的供应商
SQL 写法
select
供应商.供应商名称,
count(*) as 等待次数
from
订单明细 as 明细1
join 订单 on 明细1.订单ID = 订单.订单ID
join 供应商 on 明细1.供应商ID = 供应商.供应商ID
join 国家 on 供应商.国家ID = 国家.国家ID
where
订单.订单状态 = 'F'
and 明细1.实际到货日期 > 明细1.承诺到货日期
and exists (
select 1
from 订单明细 as 明细2
where
明细2.订单ID = 明细1.订单ID
and 明细2.供应商ID <> 明细1.供应商ID
)
and not exists (
select 1
from 订单明细 as 明细3
where
明细3.订单ID = 明细1.订单ID
and 明细3.供应商ID <> 明细1.供应商ID
and 明细3.实际到货日期 > 明细3.承诺到货日期
)
and 国家.国家名称 = 'SAUDI ARABIA'
group by
供应商.供应商名称
order by
等待次数 desc,
供应商.供应商名称;
SQLazy 写法
明细=订单明细:导出表 订单ID, 供应商ID, 订单ID.订单状态, 供应商ID.供应商名称, 供应商ID.国家ID.国家名称, 实际到货日期, 承诺到货日期
延迟明细=筛选 (订单状态 = "F" 且 实际到货日期 > 承诺到货日期)
明细:汇总 唯一计数 供应商ID 命名 供应商数 分组 订单ID
多供应商订单=筛选 (供应商数 > 1)
延迟明细:汇总 唯一计数 供应商ID 命名 延迟供应商数 分组 订单ID
唯一延迟供应商订单=筛选 (延迟供应商数 = 1)
候选订单=多供应商订单:匹配 关联表 唯一延迟供应商订单
延迟明细:匹配 关联表 候选订单
筛选 (国家名称 = "SAUDI ARABIA")
汇总 计数 订单ID 命名 等待次数 分组 供应商名称
排序 等待次数 降序, 供应商名称
导出表 供应商名称, 等待次数
exists 和 not exists 交织在一起,SQL 里要自关联三次(明细1、明细2、明细3),读的人得拿着笔顺藤摸瓜。SQLazy 版本是一条从上到下的流水线:先筛出延迟交货的明细 → 找出多供应商订单 → 从中筛出只有一个供应商延迟的订单 → 匹配回来 → 按沙特供应商汇总等待次数。每一步都是一个中间变量,命名即注释,没有任何嵌套。
4.7 30 天滑动窗口汇总:区间引用取代窗口帧
需求:对订单数据按订单日期排序,以天为单位汇总。以滑动窗口方式统计:从第一条记录开始,每天作为一个窗口的结束时间,每个窗口包含当天及其前 29 天(共 30 天)内的订单数据,统计每个窗口的订单总数和订单总金额,窗口之间滑动步长为 1 天,只输出时间跨度大于 29 天的窗口。
SQL 里的难点:需要用 rows between 窗口帧来定义滑动范围,窗口函数的帧定义语法复杂,且不同数据库的窗口函数方言差异大。
SQLazy 写法
订单:汇总 计数 订单ID 命名 每日订单数,合计 订单金额 命名 每日订单金额 分组 订单日期
计算列 合计 每日订单数[-29:0] 命名 订单总数; 合计 每日订单金额[-29:0] 命名 订单总金额; 计数 每日订单数[-29:0] 命名 窗口天数
筛选 窗口天数 >= 30
导出表 订单日期 命名 窗口结束日期,订单总数,订单总金额
rows between 29 preceding and current row 这样的窗口帧定义,在 SQLazy 里变成了每日订单数[-29:0]——区间引用,字面可读。[-29:0] 表示从当前行往前取 29 行到当前行,共 30 天的数据。不需要理解窗口帧的语法,下标就是它的字面意思。
4.8 各国账户余额前三名:排名之后外键依然可用
SQL 写法
select 国家名称, 客户名称, 客户账户余额
from (
select c.客户ID, c.客户名称, c.客户账户余额, n.国家名称,
row_number() over (partition by c.国家ID order by c.客户账户余额 desc) as rn
from 客户 c
join 国家 n on c.国家ID = n.国家ID
) t
where rn <= 3
SQLazy 写法
客户:排名 客户账户余额 降序 前 3 分区 国家ID
导出表 追加 国家ID.国家名称 命名 国家名称
row_number()over (partition by ... order by ...) 套一层子查询,在 SQLazy 里变成一行「排名 客户账户余额 降序 前 3 分区 国家ID」。更关键的是第二步:排名结果上的国家ID仍然「认得」国家表,直接用「.」把国家名称补上即可——不需要为了拿一个国家名称,把国家表提前 join 进排名的输入里。主键和外键关系在排名之后依然保持,这就是链路继承带来的省事。
4.9 年同比 + 季环比:下标引用取代自关联
需求:统计每个零件在各年份的销售情况,计算每个零件的年度同比销售额(与上一年度对比)和季度环比销售额(与上一季度对比),并计算对应的增长率百分比。
SQL 里的难点:同一张订单明细表既要按年汇总又要按季汇总,两次汇总结果之间要自关联拼接,才能把上年销售额和上季销售额带回同一行。自关联的 join 条件还要处理年份差和季度差的逻辑,代码冗长且易错。
SQLazy 写法
订单明细:导出表 订单ID, 零件ID, 订购金额, 订单ID.订单日期, 零件ID.零件名称
销售=计算列 year(订单日期) 命名 年, quarter(订单日期) 命名 季
汇总 合计 订购金额 命名 年销售额, 零件名称 命名 零件名称 分组 零件ID, 年
排序 零件ID, 年
年同比=计算列 条件((年[-1] 非空) 且 ((年 - 年[-1]) = 1) 则 年销售额[-1] 否则 空) 命名 上年销售额, 条件((年[-1] 非空) 且 ((年 - 年[-1]) = 1) 则 round((年销售额/年销售额[-1] - 1) * 100, 2) 否则 空) 命名 同比增长率百分比 分区 零件ID
销售:汇总 合计 订购金额 命名 季销售额, 零件名称 命名 零件名称 分组 零件ID, 年, 季
排序 零件ID, 年, 季
计算列 条件((年[-1] 非空) 且 (((年 - 年[-1]) * 4 + (季 - 季[-1])) = 1) 则 季销售额[-1] 否则 空) 命名 上季销售额, 条件((年[-1] 非空) 且 (((年 - 年[-1]) * 4 + (季 - 季[-1])) = 1) 则 round((季销售额/季销售额[-1] - 1) * 100, 2) 否则 空) 命名 季度环比增长率百分比 分区 零件ID
拼接 零件ID 年 关联表 年同比 零件ID 年 拼接列 年销售额, 上年销售额, 同比增长率百分比
排序 零件ID, 年, 季
导出表 零件ID, 零件名称, 年, 季, 季销售额, 上季销售额, 季度环比增长率百分比, 年销售额, 上年销售额, 同比增长率百分比
SQL 里要反复自关联同一张表来把上期值带到当前行,年与年之间、季与季之间的衔接还要判断年份差和季度差。SQLazy 用年销售额[-1]取上一行(即上一年的销售额),用分区 零件ID保证只在同一个零件内部取上期值,再用拼接把年同比结果带回季度明细——语序即逻辑,不需要在脑子里先画一遍 join 关系图。
五、写在最后
回到开头的问题:学 SQL 到底难在哪?难在它要求你先把业务想法翻译成机器的叙述方式——join 的顺序、子查询的嵌套、窗口帧的定义,都是翻译过程里的损耗和出错点。
SQLazy 把这层翻译工作接了过来:你用业务语言描述计算过程,它负责编译成标准 SQL 在数据库执行。而 TRAE + SQLazy MCP 又把写这一步也接了过去:你说需求,AI 生成 SQLazy 脚本、自动造测试数据、自动验证结果,连存量 SQL 都能一键倒译回来。
三层简化叠加之后,做一次数据查询的路径变成了:打开 TRAE → 说一句话 → 打开生成的脚本看结果。整个过程里,SQL 只出现在两个地方:编译按钮按下去之后,和翻译比对通过之后——它仍在为数据库服务,只是不再需要你先学会它。
哪怕你昨天才第一次打开 SQLazy,今天也可以让 AI 替你写下第一段查询。这就是这套工具链想带来的东西:更短、更清楚、更容易上手——让代码说业务的话,让 AI 替你写代码。
说明:文中示例基于 SQLazy 内存库示例数据(客户、订单、订单明细、零件、零件供应、供应商、国家、地区),表结构与主外键均取自实际内存表定义;SQL 侧示例用于对照语义,部分为节选。