
豆包调用润乾 NLQ MCP 实现智能数据查询分析实践
1 NLQ MCP DEMO for TPCH 及 SKILL 说明
1.1 MCP 说明
NLQ MCP DEMO for TPCH(本文以下简称 NLQ MCP 或 MCP)是基于 TPCH 数据源的数据查询 MCP 演示,它可以接收来自 AI 智能体生成的规范 NLQ 代码,执行并返回查询结果。
NLQ MCP 有两种执行模式:全流程模式会执行数据查询代码和以“报表呈现:”为标志的报表呈现代码,此时 MCP 服务将返回 URL 来呈现报表;数据查询模式不包括报表呈现代码,仅返回查询结果集,由智能体负责呈现。在返回 URL 呈现报表时,要注意页面有可能过期而无法访问,此时需要重新生成。
NLQ 执行代码用汉语书写,普通业务人员也能看懂,从而可以确认 AI 生成的查询动作是否正确,避免 AI 幻觉曲解用户目标导致的错误。
NLQ MCP 服务地址:http://d.raqsoft.com.cn:6888/mcp,DEMO 以 TPCH 数据集为基础,读者可以了解 NLQ 的实施过程后改造其中的 SKILL 以适应其它数据主题并部署到其它地址上。
MCP 提供三个工具:
工具名 |
说明 |
getLoginUrl |
获取OAuth 登录地址 |
login |
用 access_token 绑定会话身份 |
execute |
提交 NLQ命令并执行查询 |
nlq SKILL 用于辅助智能体生成查询分析数据的命令,用户输入的自然语言需求,将被拆分为「查询 / 计算」与「呈现」两部分;前者转换为规范的 NLQ 代码,发送给 MCP 执行查询;结果集返回后由智能体渲染。
SKILL 的名称可以根据需要设定,最好足够简明,便于在实际使用中明确选择。
1.2 SKILL 的安装
1.2.1 技能压缩包下载
从润乾NLQ 查询演示页面(http://query.raqsoft.com.cn:6999/nlq4tpch.html)下载 SKILL 文件 nlqrdemoskill.zip 解压,内容如下:
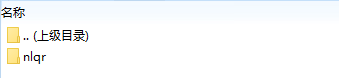
在nlqr 路径中则为技能相关文件:
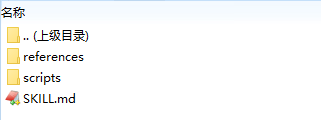
即可用这个压缩包在豆包中安装技能。
1.2.2 在豆包中使用压缩包安装技能
在豆包的侧边栏中选择「连接器·技能·伙伴」:
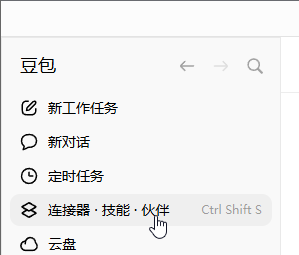
在右上角点击「添加」→「上传技能」:
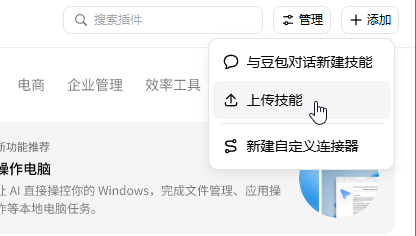
把压缩包文件拖拽到下面技能框中:
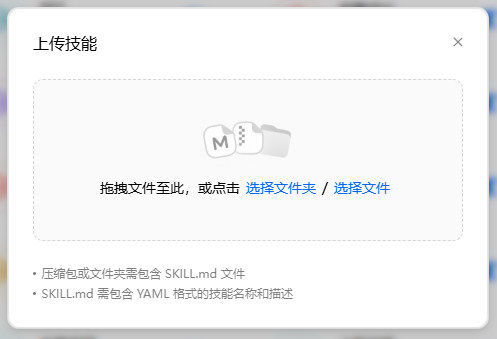
如果一切正常可在技能管理中看到上传的技能:
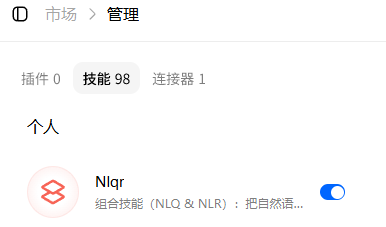
1.3 SKILL 文件体系
技能目录建议按以下结构组织:
nlqr
├── SKILL.md # 主技能文件(触发词、流程、规则)
├── references/
│ ├── nlq-field-dictionary.md # NLQ 语法规则、查询范式、不支持类型
│ ├── nlq-grammar-spec.md # 表结构、字段名、维词、常数词、聚合指标词典
│ └── nlr-grammar.md # NLR 语法规则、报表处理规划描述
└── scripts/
├── nlq_execute.py # 由 MCP 执行 NLQ 命令的处理(自动生成)
├── nlq_export_data.py # NLQ 返回结果集时的规则(自动生成)
├── nlq_login.py # nlq OAuth 登录脚本(自动生成)
└── nlq_mcp_config.py # MCP 连接规则描述(自动生成)
1.4 NLQ MCP 连接配置
1.4.1 配置步骤
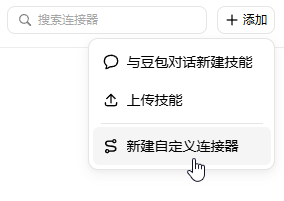
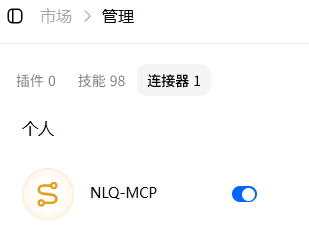
在豆包的侧边栏中选择「连接器·技能·伙伴」,在右上角点击「添加」→「新建自定义连接器」:
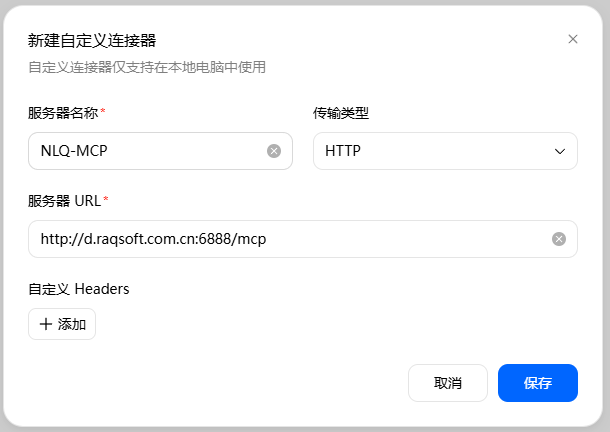
服务器名称用NLQ-MCP(与技能中统一,如果用其它名称,需要相应修改SKILL.md),NLQ MCP DEMO 地址是http://d.raqsoft.com.cn:6888/mcp:
连接器添加成功后可在列表中看到:
1.4.2 技能中通过内置脚本自动登录 MCP
首次调用 execute 前,或者登录过期时,需完成 OAuth 登录并获取 session_id。
在技能的SKILL.md 中定义的登录脚本路径默认为:< 技能目录 >/scripts/nlq_login.py
①当 execute 返回未登录 / 鉴权失败错误时,Agent 会自动运行:
python < 技能目录 >/scripts/nlq_login.py < 结果文件路径 >
②脚本行为:
自动打开系统浏览器,跳转到 OAuth 授权页面;
等待用户授权(最多 5 分钟);
授权成功后,交换 token(使用 x-www-form-urlencoded 表单,非 JSON);
将 session_id 写入指定的结果文件;
后续请求通过 Mcp-Session-Id 头携带会话身份。
③同一会话内可复用已保存的 session_id;会话失效时重新运行脚本。
在首次调用技能时,如果MCP 未连接,或者登录已过期,将弹出浏览器窗口:
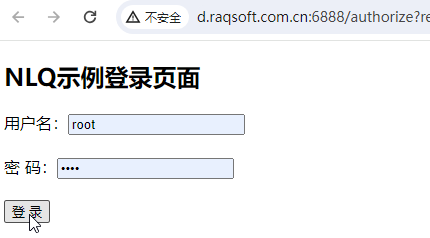
这里只是演示登录功能,并未做实际的用户口令检查,随便填写任何用户名和密码即可过关。
登录后,返回豆包可以继续执行技能:
2 SKILL 调用
2.1 豆包中使用技能查询
在技能和MCP 都配置好后,即可在豆包中,新建工作任务:
技能安装成功后,在豆包中输入查询信息,它会自动选择使用技能,如果存在多个类似的技能,可以在查询语句前指定技能名称,先输入:/nlqr 用技能名称指定技能。在输入 / 符号后,即可在技能列表中选择所需使用的技能。
如果发现查询时未能正常连接MCP 服务,可以在对话窗口中要求连接到需要的连接器。
此时就可以用安装的技能来查询数据了,如输入:/nlqr 按行业统计订购金额,做个占比图。
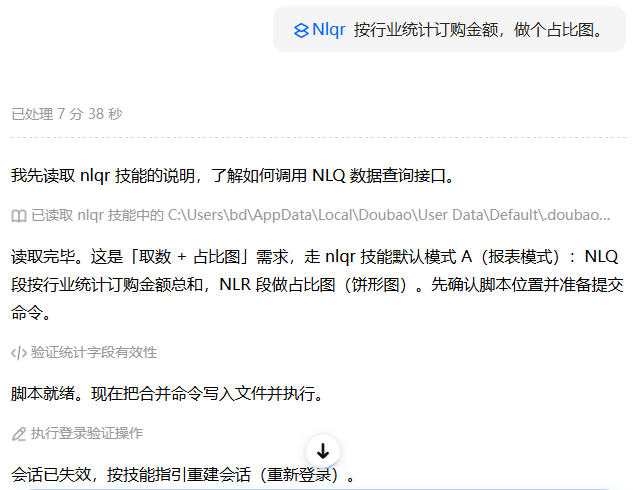
豆包加载技能后会使用技能处理查询命令,在首次使用MCP 或者会话过期时,需要执行 1.4.2 中介绍的自动登录流程。在浏览器弹窗中完成登录后,技能继续执行:
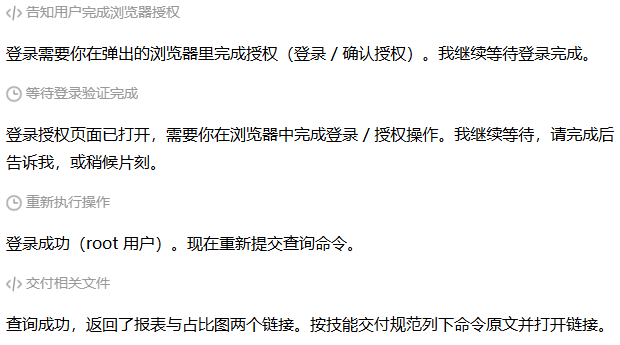
最终获得结果如下:
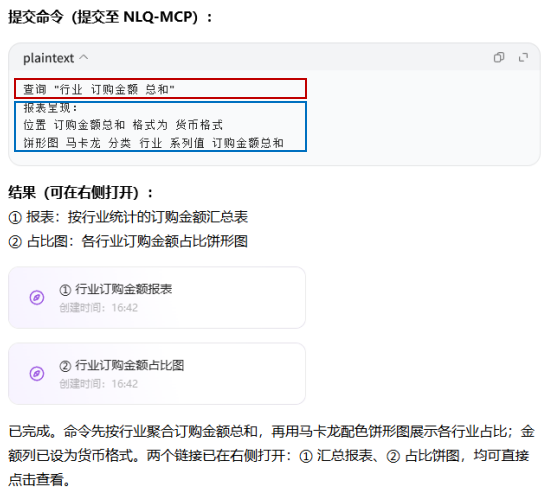
结果中,首先会列出提交到MCP 执行的命令代码,代码分为两部分,红色方框内为数据查询代码,蓝色方框内为报表呈现代码。在 MCP 的全流程查询使用模式下,数据查询代码是一定会存在的,报表呈现如果不需要特别处理,也会保留“报表呈现:”这一行。
由于查询命令中有统计图需求,因此结果包括报表和图形两个网页,可以分别点击查看:
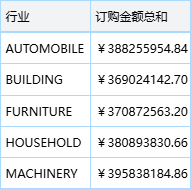
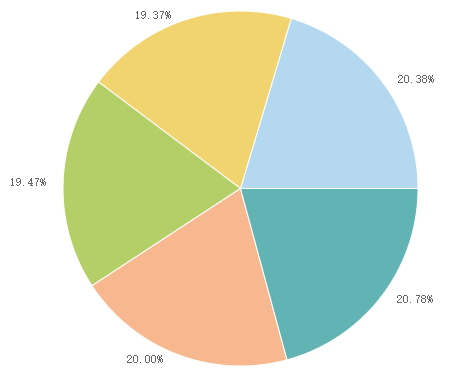
在首次查询加载技能后,后续的查询即使不用“/nlqr”指定技能,也会继续用这个技能处理。
2.2 用豆包辅助报表呈现的方法
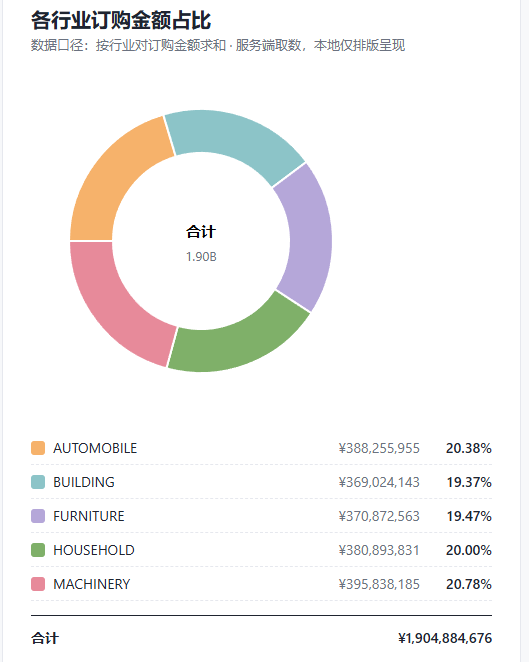
在nlqr 技能中,提供了由 MCP 返回结果集,而由豆包处理报表呈现及统计图生成等步骤的模式,只需要在数据查询语句中,添加“【本地】”,表示报表呈现由本地处理即可,注意括号【】是必须的,主要是为了和正常的查询需求区分。如输入:【本地】按行业统计订购金额,做个环形占比图。
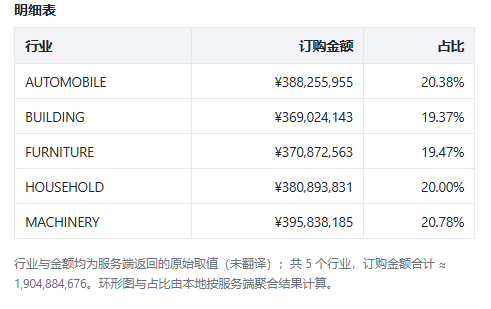
结果的命令列表中完全不包含报表呈现部分,这种情况下MCP 仅会执行数据查询命令,返回的也不是 url 而是 json 格式的结果集。此时的 html 由豆包根据结果集和需求辅助呈现,结果如下:
2.3 两种模式的对比
用MCP 直接处理,与用豆包辅助报表呈现两者相比,各有长处,可以根据具体情况选择。
用MCP 直接处理报表呈现,整个流程由服务器处理,保密性好,获得的结果稳定,在结果数据量比较大时能够大幅度减少 token 的消耗,同时也不会有对结果规模的限制。
用豆包辅助报表呈现,效果更自由,特别是统计图的选择会更丰富,但效果可能会有变动,如果需要进一步分析这种模式会比较方便,有利于对结果数据多轮加工。
3 查询示例
3.1 单表查询
3.1.1 明细查询
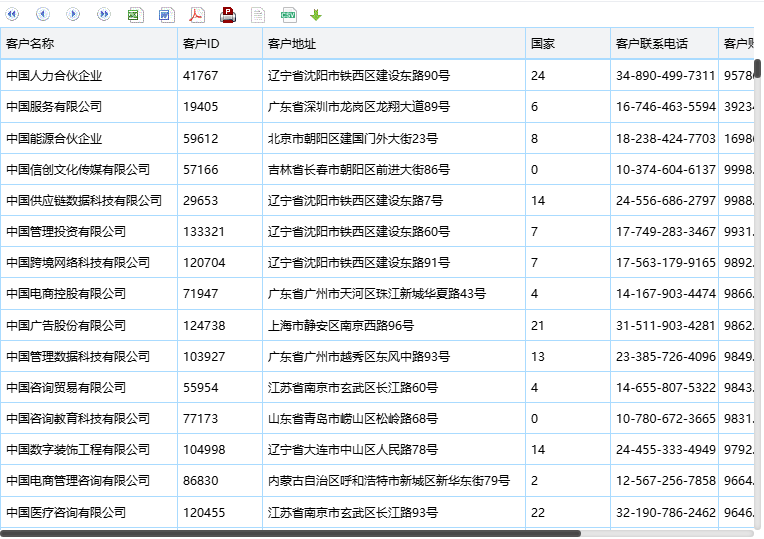
A.名称包含“中国”的客户信息,按账户余额降序排序
说明:单表的明细数据,模糊匹配字段过滤,结果需要排序。
查询结果:
查询 "客户名称 包含' 中国 '客户"
排序 客户账户余额 降序
报表呈现:
位置 客户账户余额 格式为 货币格式
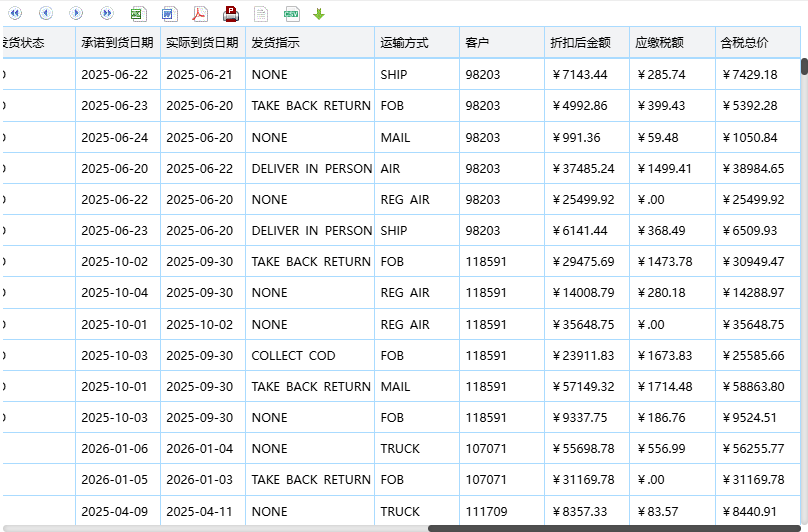
B.计算2025 年订单明细的折扣后金额、税额和含税总价
说明:单表的明细数据,按字段值区间过滤,需要增加计算列。结果中存在金额、百分比、数值等各种类型数据,呈现时会按默认格式处理。
查询结果:
查询 "发货日期 2025 年 订单明细"
计算列 订购金额*(1- 折扣率) 命名 折扣后金额, 折扣后金额 * 税率 命名 应缴税额, 折扣后金额 + 应缴税额 命名 含税总价
报表呈现:
位置 折扣后金额 格式为 货币格式
位置 应缴税额 格式为 货币格式
位置 含税总价 格式为 货币格式
 3.1.2 汇总查询
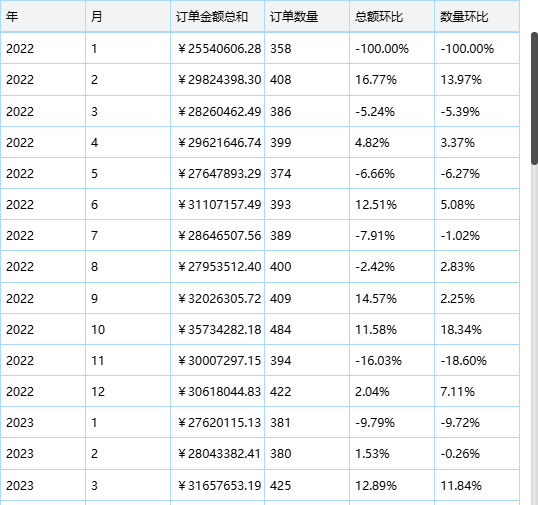
A.计算月度订单总额、订单数量的环比增长率
说明:分组汇总,并环比计算增长率。
查询结果:
查询 "年 月 订单金额 总和,订单 数量"
排序 年, 月
计算列 订单金额总和 增长率 命名 总额环比, 订单数量 增长率 命名 数量环比
报表呈现:
位置 订单金额总和 格式为 货币格式
位置 总额环比 格式为 百分数格式
位置 数量环比 格式为 百分数格式
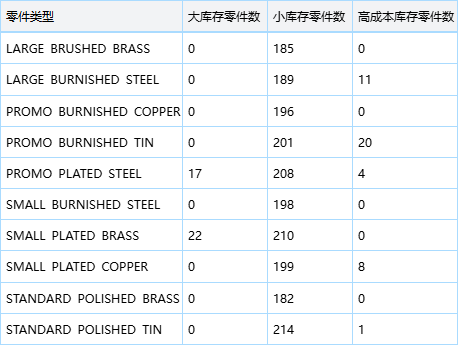
B.各零件类型的大/ 小库存与高成本库存零件数
说明:查询复杂聚合指标。
查询结果:
查询 "零件类型 大库存零件数, 小库存零件数, 高成本库存零件数"
报表呈现:
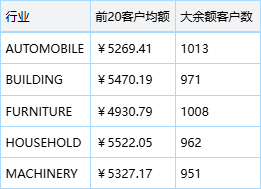
C.各行业 前20% 客户均额与大余额客户数
说明:查询复杂聚合指标,包括带参数的指标。
查询结果:
查询 "行业,前20客户均额,大余额客户数"
报表呈现:
位置 前20客户均额 格式为 货币格式
3.1.3 复杂查询
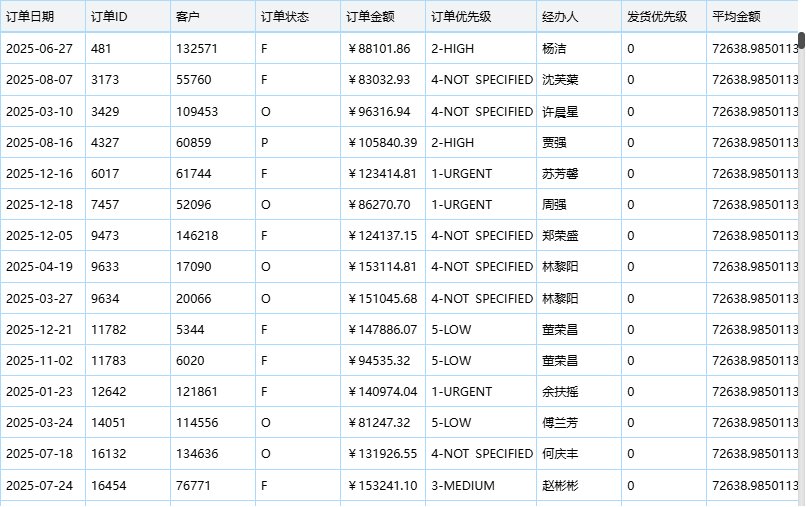
A.查询2025 年订单金额高于平均订单金额的订单
说明:根据单表的汇总结果来执行过滤。
查询结果:
查询 "2025 年 订单"
计算列 订单金额 平均 命名 平均金额
筛选 订单金额> 平均金额
报表呈现:
位置 订单金额 格式为 货币格式
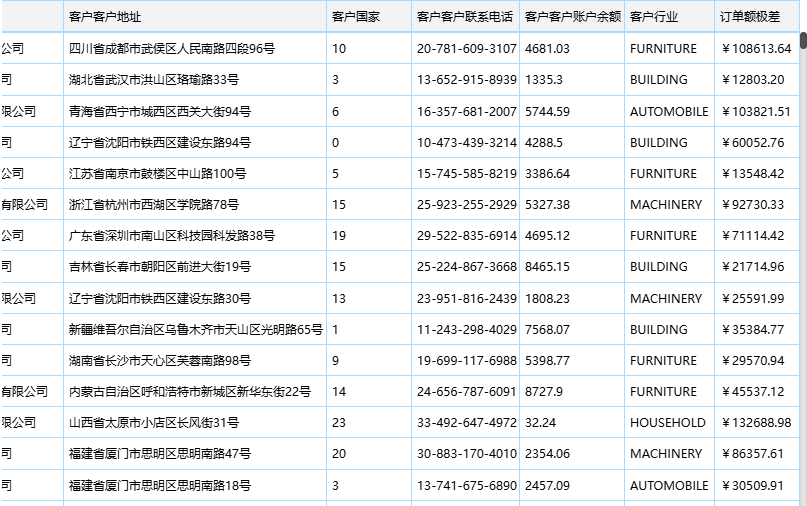
B.订单额极差大于1 万元的客户信息
说明:订单额极差是复杂聚合指标,需要计算同一客户的最大订单额和最小订单额的差。计算后再根据结果执行过滤。
查询结果:
查询 "订单额极差大于 10000,客户"
报表呈现:
位置 订单额极差 格式为 货币格式
3.2 多表关联查询
3.2.1 多表汇总查询
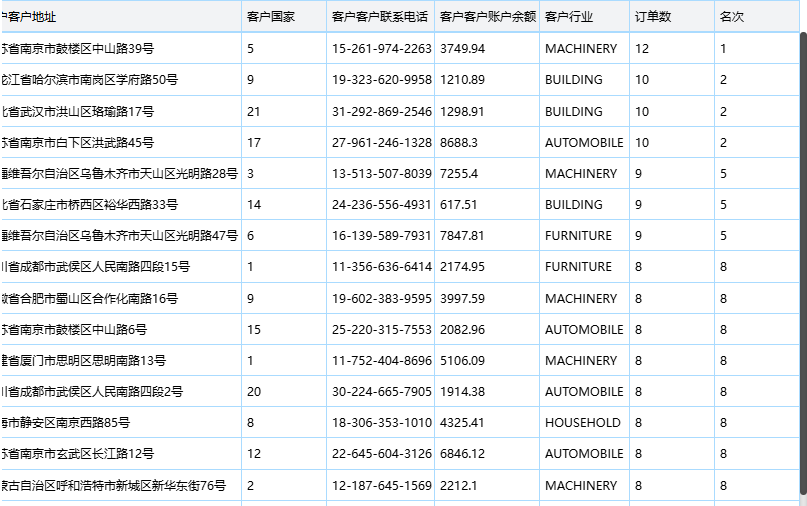
A.查询客户信息以及它们的订单数,按照订单数降序排序,列出前10 名,保留同名次的
说明:主子表汇总查询,并根据汇总结果排序以及过滤。
查询结果:
查询 "客户,订单 数"
排序 订单数 降序
排名 订单数 降序 命名 名次
筛选 名次<=10
报表呈现:
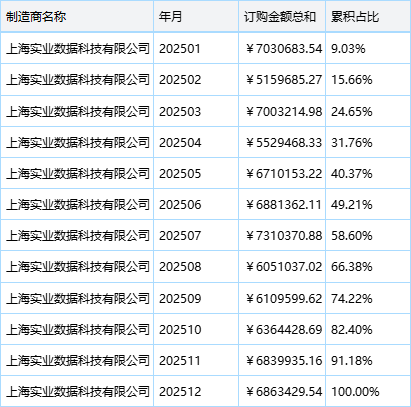
B. 上海实业数据科技有限公司生产的商品 2025 年每个月的订单总额和累积占比
说明:通过多表关联关系分步查询数据,再汇总计算。
查询结果:
查询 "制造商名称 上海实业数据科技有限公司 发货日期 2025 年 年月 订购金额 总和"
排序 年月
计算列 订购金额总和 累计比例 命名 累积占比
报表呈现:
位置 订购金额总和 格式为 货币格式
位置 累积占比 格式为 百分数格式
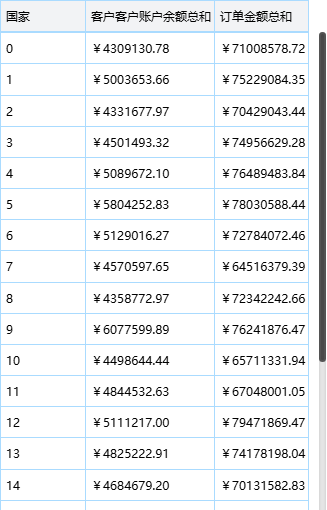
C.各国客户的资金存量和消费规模,包括国家名称
说明:多表的按维汇总。
查询结果:
查询 "国家 客户 客户账户余额 总和, 订单 订单金额 总和"
报表呈现:
位置 客户客户账户余额总和 格式为 货币格式
位置 订单金额总和 格式为 货币格式
3.2.2 多表关联的复杂查询
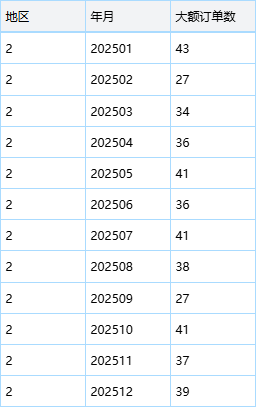
A.亚洲客户2025 年每个月的大额订单数
说明:通过关联表过滤数据,并计算复杂聚合指标。
查询结果:
查询 "地区 亚洲 2025 年 年月 大额订单数"
报表呈现:
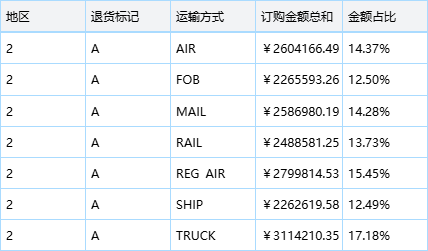
B.2025 年亚洲全部退货的明细中各运输方式金额占比
说明:通过关联表过滤数据,并计算复杂聚合指标。
查询结果:
查询 "地区 亚洲 退货标记 全部退回 发货日期 2025 年 运输方式 订购金额 总和"
计算列 订购金额总和 占比 命名 金额占比
报表呈现:
位置 订购金额总和 格式为 货币格式
位置 金额占比 格式为 百分数格式
3.3 MCP 处理报表呈现
3.3.1 统计图
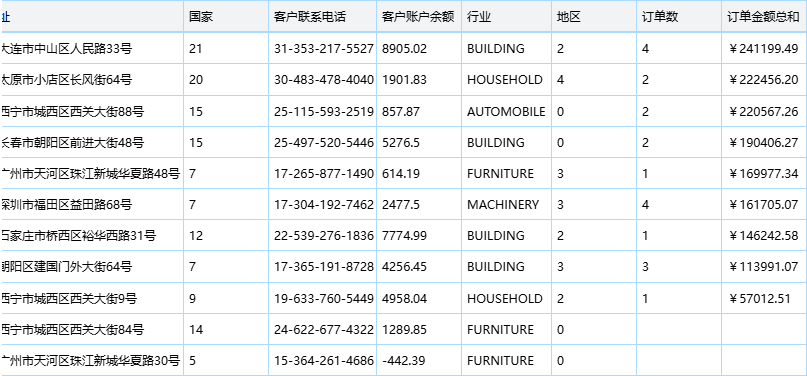
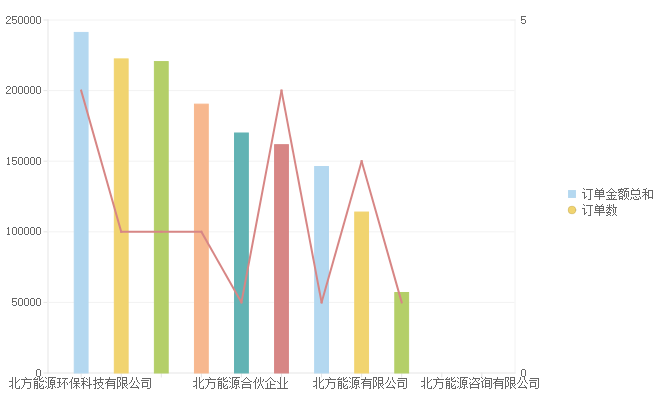
A. 柱线图:“北方能源”相关客户的订单数和总金额,画个柱线图
说明:模糊过滤,主子表汇总查询,双系列数据,需要绘制柱线图
查询结果:
查询 "客户名称 包含 '北方能源' 客户,订单 数,订单金额 总和"
排序 订单金额总和 降序
报表呈现:
位置 订单金额总和 格式为 货币格式
双轴柱线图 分类 客户名称 左轴系列值 订单金额总和 右轴系列值 订单数
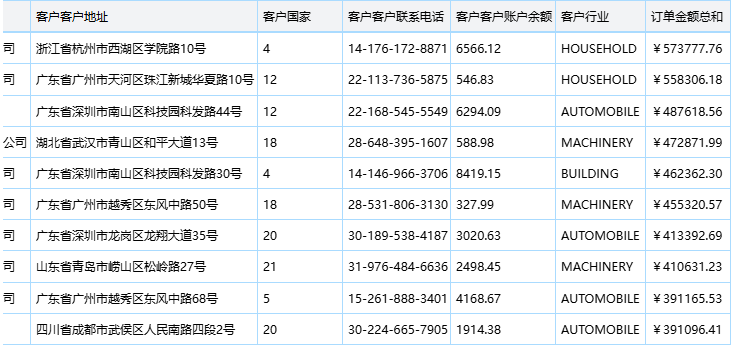
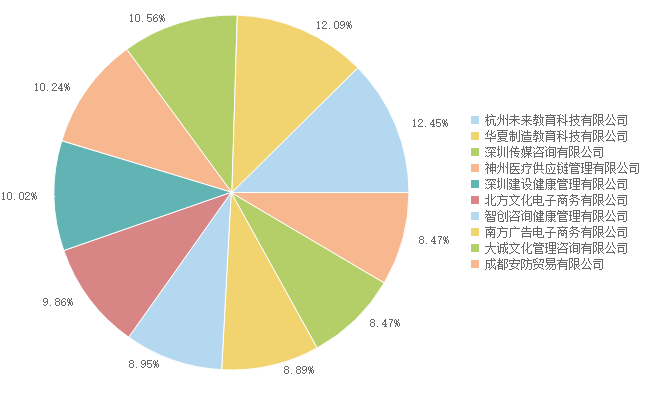
B. 饼图:2025 年总金额前 10 名客户,绘制马卡龙饼图
说明:汇总查询,排名过滤,需要指定风格的饼图
查询结果:
查询 "2025 年 客户,订单金额 总和"
排序 订单金额总和 降序
筛选 # <= 10
报表呈现:
位置 订单金额总和 格式为 货币格式
饼形图 马卡龙 分类 客户客户名称 系列值 订单金额总和
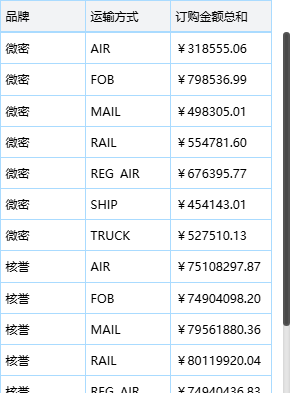
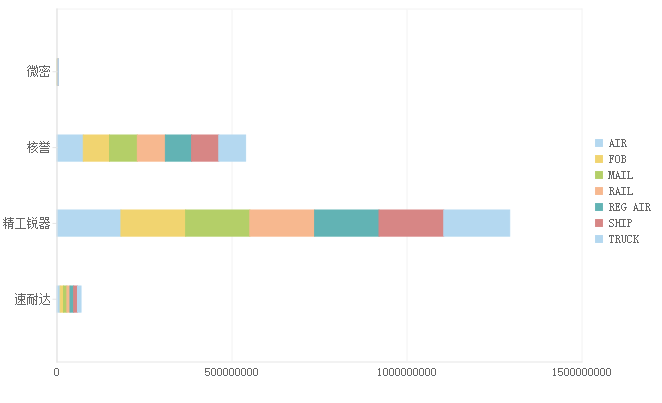
C. 条形图:各品牌的订购金额按运输方式构成,用堆叠式条形图展示
说明:分组汇总,绘制堆积式图形
查询结果:
查询 "品牌 运输方式 订购金额 总和"
报表呈现:
位置 订购金额总和 格式为 货币格式
堆积条形图 分类 品牌 系列 运输方式 系列值 订购金额总和
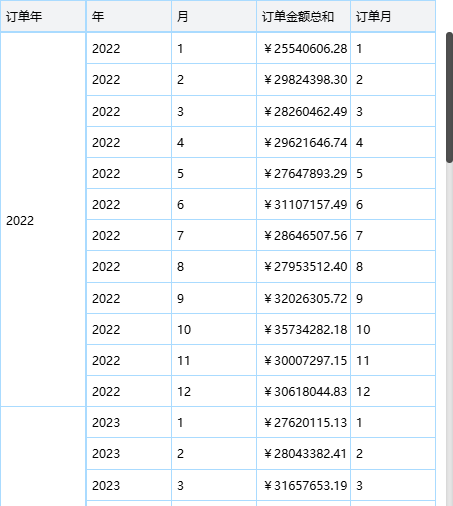
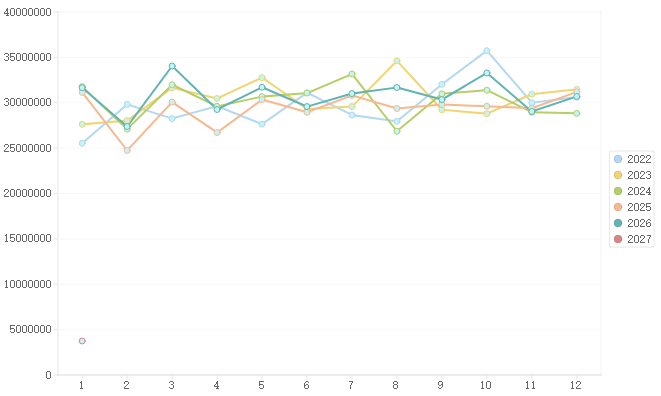
D. 多系列折线图:每年每月总订单金额,画一个折线图
说明:汇总查询,报表需要分组展示,绘制多系列折线图
查询结果:
查询 "年 月 订单金额 总和"
排序 年, 月
计算列 年 命名 订单年, 月 命名 订单月
报表呈现:
删除 年 月
左表头 订单年
订单年 隐藏合计行
位置 订单金额总和 格式为 货币格式
折线图 分类 订单月 系列 订单年 系列值 订单金额总和
3.3.2 外观设置
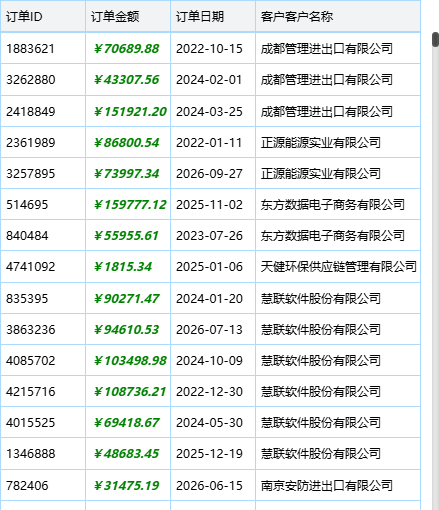
A. 整列外观:订单信息,只要其中的编码、签单日期、客户名称、金额这些内容,金额用斜体显示,绿色加粗
说明:字段删除,整列外观设置
查询结果:
查询 "订单,客户 客户名称"
报表呈现:
删除 客户 订单状态 订单优先级 经办人 发货优先级
位置 订单金额 格式为 货币格式
位置 订单金额 斜体 绿色 加粗
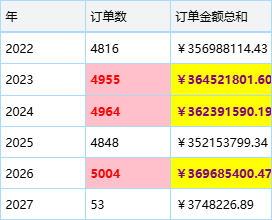
B. 条件外观:每年的订单总数和总金额,订单总数超过4900 的用粉色背景红色加粗,总金额超过3.6亿的用黄色背景紫色加粗
说明:显示时需要根据条件变化格式
查询结果:
查询 "年 订单 数量,订单金额 总和"
报表呈现:
位置 订单金额总和 格式为 货币格式
位置 订单数量 订单数量大于4900 红色 背景色 粉色 加粗
位置 订单金额总和 订单金额总和大于360000000 紫色 背景色 黄色 加粗
3.4 豆包处理报表呈现
3.4.1 取得数据后绘图
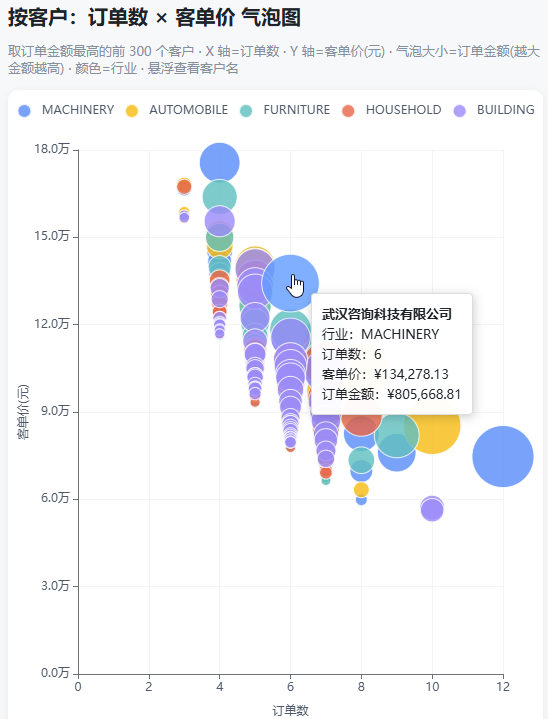
A.【本地】按客户看订单数、客单价和订单金额,画气泡图:X 轴订单数、Y 轴客单价、点越大金额越高、颜色按行业区分,鼠标悬浮显示客户名。
说明:需要绘制特殊的统计图,气泡图NLR 并未支持,同时还需要鼠标悬浮显示等处理,此时可以由豆包在取得数据后做后续的绘图处理。
查询结果:
查询 "客户,订单 数,订单金额 总和"
计算列 订单金额总和 / 订单数 命名 客单价
排序 订单金额总和 降序
筛选 # <= 300
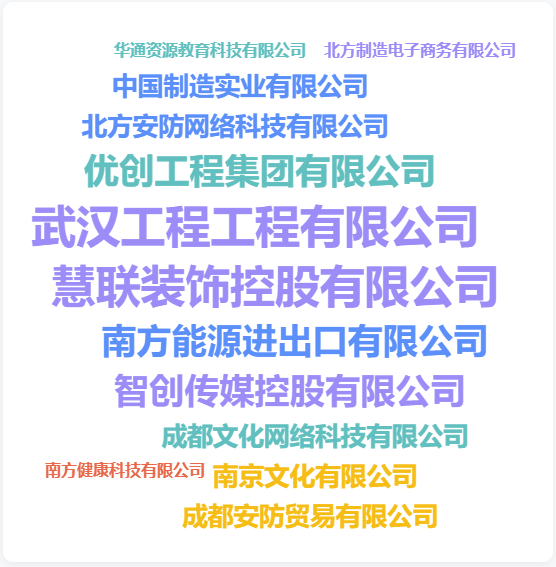
B.【本地】把下单最频繁的 20 个客户名做成词云,字号大小按订单数,颜色按所属行业区分。
说明:。
查询结果:
查询 "客户,客户名称,行业,订单 数"
排序 订单数 降序
筛选 # <= 20
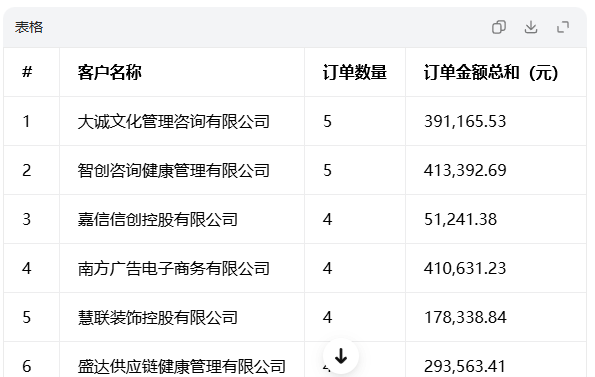
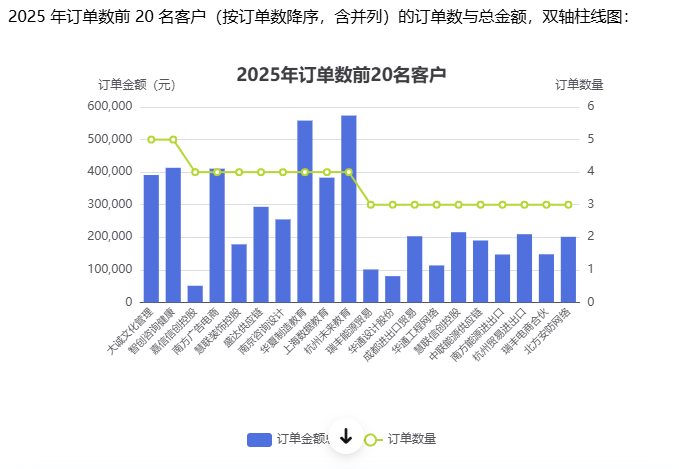
C.【本地】列出2025 年,订单数精确前 20 名客户的订单数和总订单金额,并绘制柱线图
说明:主表和多个子表的汇总查询,并按汇总结果排序及过滤。这里添加了关键字“【本地】”,表示结果呈现以及绘制统计图由豆包根据返回结果集来生成。
查询结果:
查询 "2025 年 客户 订单 数量,订单金额 总和"
排序 订单数量 降序
3.4.2 用查询结果呈现有特别要求
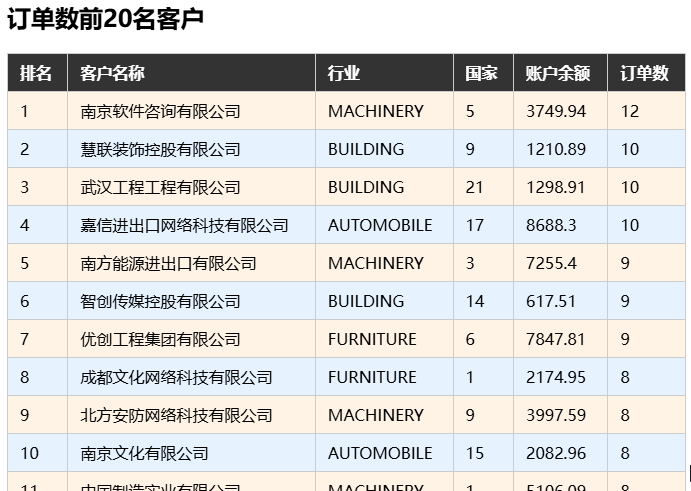
A.【本地】查询订单数前20 名的客户信息以及它们的订单数,隔行用浅蓝色和浅橙色背景
说明:最后需要的报表比较特殊,不符合通用格式
查询结果:
查询 "客户 订单 数量"
排序 订单数量 降序
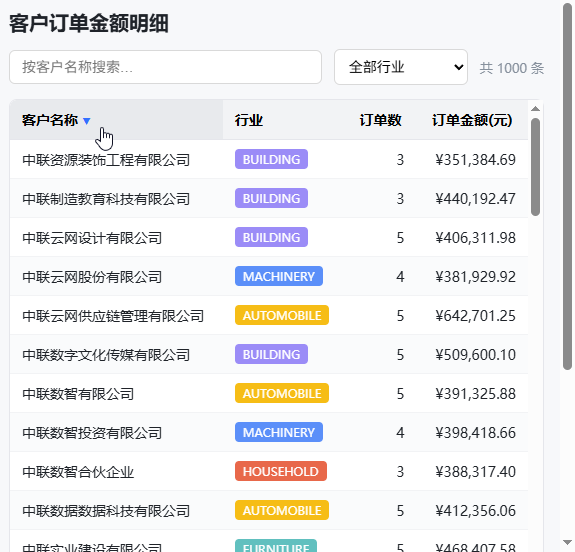
B.【本地】按客户出一张订单金额明细表,要能点列头排序、能按客户名搜索、能按行业下拉筛选,表头滚动时固定,超过 100 行分页
说明:需要的报表呈现功能比较复杂,由豆包处理报表生成。总数据量比较大,对话中要求取前1000 条数据。
查询结果:
查询 "客户,客户名称,行业,订单 数,订单金额 总和"
排序 订单金额总和 降序
筛选 # <= 1000
3.5 技能执行后的后续分析
A. 针对 URL 报表的后续分析
各个供应商的大额明细数与大量明细数
说明:分组汇总,计算复杂聚合指标。这里需要对结果进一步分析,在默认模式下,结果将以页面模式返回,此时需要后续分析的话,需要AI 从结果页面中获取数据再执行,这样会使得效率较低。因此,这种需要后续分析的情况更适合于添加“【本地】”标记,由 MCP 返回结果集再由豆包处理,这样后续查询就比较方便了。
查询结果:
查询 "供应商 大额明细数,大量明细数"
报表呈现:
删除 供应商 供应商国家 供应商供应商账户余额 供应商供应商联系电话 供应商供应商地址
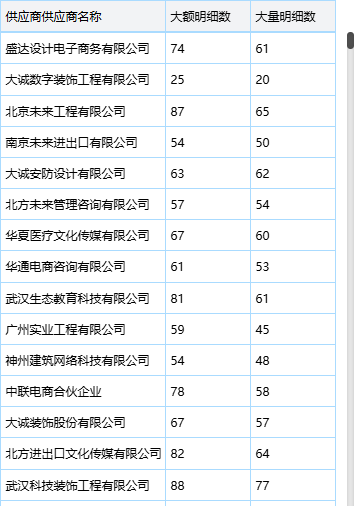
继续输入:这个数据能得到什么结论吗?
说明:查询与nlq 技能无关,由豆包自行回答。
查询结果:
让我把数据完整取出来,做个统计分析。
整理共享文件夹信息
基于 1000 家供应商数据,可得到以下结论:
**1. 整体水平 **
- 大额明细数均值 **58**(最小 11,最大 100),大量明细数均值 **49.6**(最小 7,最大 81)
- 两者分布都比较均匀,中位数接近均值,说明没有极端异常值拉偏
**2. 大额 vs 大量:数量比金额更 "分散"**
- **903 家供应商 ** 的大额明细数 > 大量明细数(占 90.3%)
- 仅 70 家大量明细数 > 大额明细数,27 家两者相等
- 平均差值 **+8.5**(大额比大量多约 8.5 条)
这意味着:** 订购金额偏高的明细,普遍比订购数量偏高的明细更多 **。换句话说,大多数供应商的订单结构是 "少而精"—— 单笔金额大的明细多于数量多的明细。
**3. Top 供应商 **
- 大额明细数最高:中华环保集团(100 条大额 / 81 条大量)
- 大量明细数最高:中华环保集团(81 条)、正源智能控股(79 条)、深圳装饰数据科技(79 条)
- 中华环保集团是唯一两个指标都进入 Top3 的供应商,属于 "双高" 供应商
**4. 业务含义 **
- 大多数供应商的客户倾向于 ** 单笔下大单(金额高)而非多次下小单(数量高)**
- 少数 70 家供应商反过来 —— 客户更倾向于多次采购、每次量不大
- 如果要做供应商分级,中华环保集团、德润教育、大诚服务等属于优质供应商(两类异常明细都多)
继续输入:基于已有的结果,分析一下各种订单适合哪种供应商吧,分类时用数据
说明:查询与nlq 技能无关,由豆包根据前面的分析和查询结果总结。
查询结果:
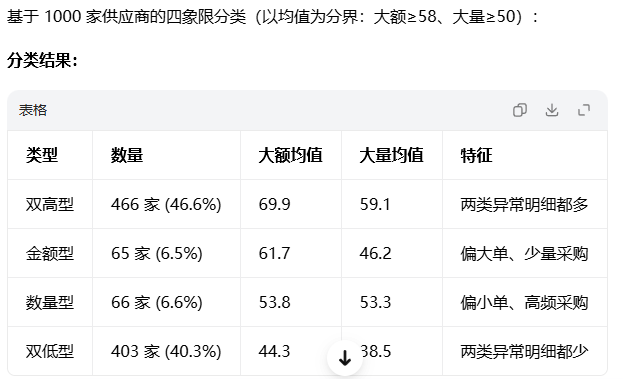
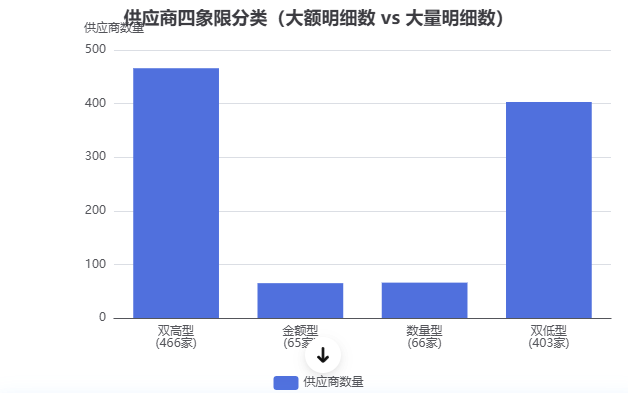
** 各类型供应商适合的订单:**
** 双高型(466 家,核心供应商)**
- 适合:大额批量订单、长期战略合作、新品首发
- 代表:中华环保集团(大额 100 / 大量 81)、德润教育(96/70)、大诚服务(94/77)
- 依据:这 466 家既能承接高金额订单(大额明细均值 70),也能支撑高频小批量补货(大量明细均值 59),是最全面的供应商池
** 金额型(65 家,大单供应商)**
- 适合:单笔大额订单、项目制采购、设备级采购
- 代表:中华管理教育(大额 71 / 大量 45)、广州科技控股(71/49)
- 依据:大额明细均值 61.7 但大量明细仅 46.2,说明客户在这 65 家下的特点是 "下大单但不频繁",适合一次性大额采购
** 数量型(66 家,高频供应商)**
- 适合:高频小批量补货、日常耗材采购、JIT 供应
- 代表:深圳装饰实业(大额 57 / 大量 62)、宏图数据咨询(55/62)
- 依据:大量明细均值 53.3 但大额明细仅 53.8,说明客户在这 66 家下的特点是 "频繁下单但单笔金额不高",适合日常高频补货
** 双低型(403 家,备选供应商)**
- 适合:应急备选、小批量试单、非核心物料
- 依据:两类异常明细都低于均值,说明客户在这些供应商处的订单比较 "平庸"—— 既没有大额也没有高频,属于中规中矩的常规合作
B. 针对豆包生成报表的后续分析
【本地】交叉统计各订单优先级与订单状态下的订单数和金额
说明:分组汇总后,结果显示为交叉表,并进一步分析。这里用“【本地】”模式,由豆包根据查询结果集处理呈现需求,并完成后续分析。
查询结果:
查询 "订单优先级 订单状态 订单 数量,订单金额 总和"
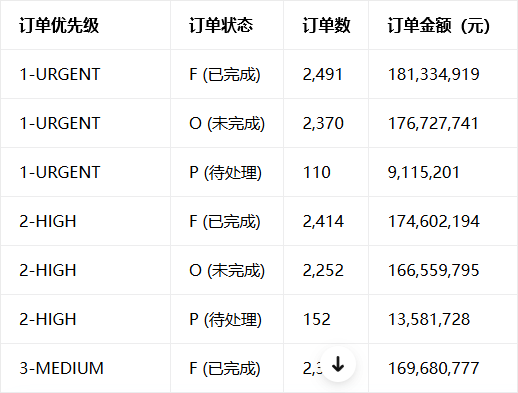
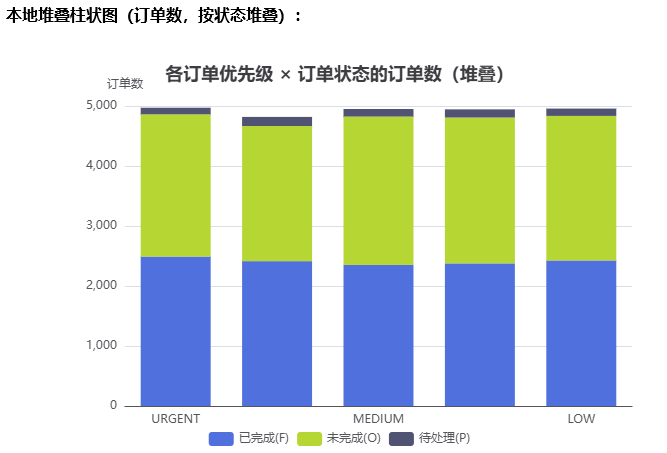
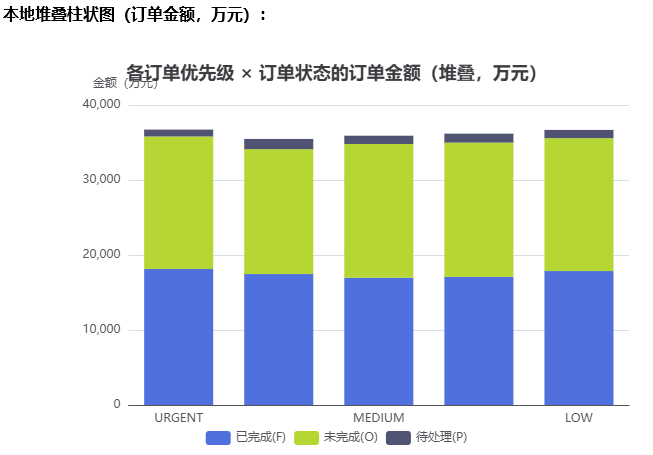
** 观察要点:**
- 各优先级的订单总数基本均匀(每类约 4800~5000 单),优先级对订单量影响不大
- ** 待处理 (P) 订单占比极低 **:每类仅约 110~152 单(约 2.5%),说明订单流转效率高
- **URGENT 类待处理占比最低 **(110/4971 ≈ 2.2%),紧急订单的流转速度最快
- **HIGH 类待处理占比最高 **(152/4818 ≈ 3.2%),中高优先级反而有一定积压
- 金额分布与订单数基本成正比,说明各优先级的单笔订单金额差异不大
继续输入:分析一下结果
说明:查询与nlq 技能无关,由豆包自行回答。
查询结果:
** 一、总量基本均匀,优先级对业务量影响不大 **
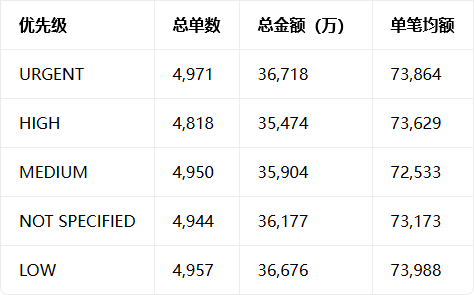
五个优先级的订单量(4800~5000 单)和单笔均额(7.2~7.4 万)几乎一致,说明 ** 订单优先级标签对实际业务量没有区分度 **—— 客户并不会因为标了 "URGENT" 就下更大的单,也不会因为标了 "LOW" 就减少下单。
** 二、完成率:URGENT 和 HIGH 略高,MEDIUM 偏低 **
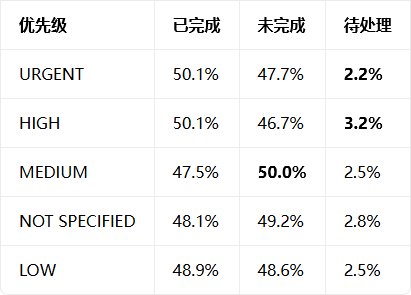
- **URGENT 流转最快 **:待处理仅 2.2%,是所有优先级中最低的,说明紧急订单确实优先处理了
- **HIGH 积压最多 **:待处理 3.2%,且未完成率 46.7%—— 高优先级但未被同等加急,存在 "标了高但处理不快" 的问题
- **MEDIUM 完成率最低 **(47.5%),未完成率最高(50.0%),中等优先级反而积压最严重
** 三、待处理订单的单笔金额明显偏高 —— 积压的都是大单 **
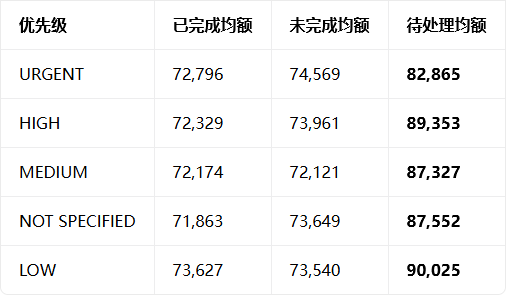
所有优先级的待处理订单均额(8.3~9.0 万)都比已完成订单均额(7.2~7.4 万)** 高出约 15%~20%**。这意味着:** 积压在待处理状态的订单,恰恰是金额更大的单子 **。
** 四、核心结论与建议 **
1. ** 优先级标签形同虚设 **:URGENT 和 LOW 的单笔金额、订单量几乎一样,优先级没有影响客户的下单行为
2. **HIGH 优先级存在管理落差 **:待处理占比最高(3.2%),但紧急度不如 URGENT,建议要么降为 MEDIUM,要么加快处理
3. ** 待处理订单是大单 **:待处理订单均额比已完成高 15%~20%,虽然数量少(仅 2.5%~3.2%),但金额占比更高,清理这些积压能快速释放营收
4. **MEDIUM 是最大的积压池 **:未完成率 50%,总单数最多,建议作为重点清理对象