
雪藏十二年,被大模型唤醒的智能问数之魂
01 仓库深处,躺着 2013 年的答案
润乾是做报表的,自然也会涉及 BI 业务。
大概在 2013 年,我们就动手做过一版自然语言查询的东西,命名为 NLQ。那会儿,我们已经能把挺复杂的 SQL 生成出来,尤其是多表关联能做得很好。我们发明了一套名为 DQL 的技术:外键穿越、维度对齐、子查询间的 FULL ——这些现在很多大模型都容易翻车的地方,那时候就能稳稳做出来。我们还引入了“动词”“字段簇”这些概念,巧妙处理了一个动作同时挂多个维度的情况,都能准确识别出来。
换句话说,“把语义变成准确查询”这件事,我们十几年前就做得很扎实了。
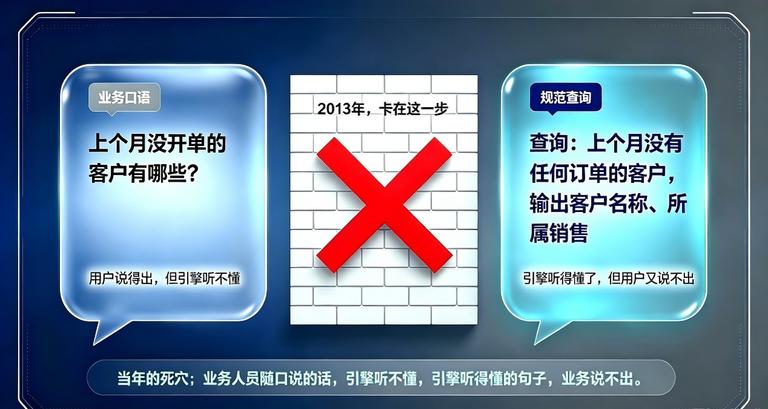
但短板也在同时暴露出来:对汉语口语的理解太弱。
业务人员随口说:“上个月没开单的客户有哪些?”系统听不懂。必须逼他们写成相对规范的汉语。可业务人员不一定总是按约定的语言规范提问,用户体验一言难尽。
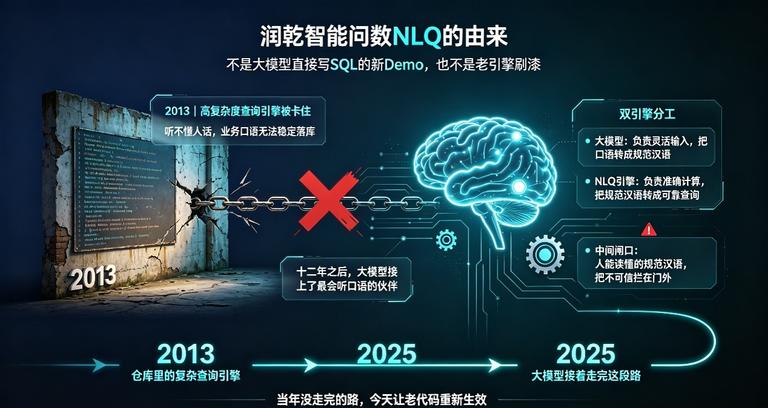
这个项目就这么被放进了仓库,一放,十二年。
其实,这不只是我们一家的问题,在大模型出来之前,这对于全世界都是个难题。微软 SQL Server 早年间有个 English Query,想干同一件事,后来新版本里砍了,估计也是栽在口语理解上。
02 ChatGPT 来了,我们以为老技术废了
2022 年底,ChatGPT 出来。我们试了试让它写 SQL,居然挺像样,挺复杂的 SQL 都能写出来。
那一瞬间,心里咯噔一下:AI 做得这么好,当年的老技术看样子彻底废了!
但是,当时间来到 2025 年春天,我们竟然发现满世界又在喊 Text2SQL、智能问数,一大堆解决方案,还互相比来比去谁能做得更准。原来,过了两三年,这事并没有被大模型解决。
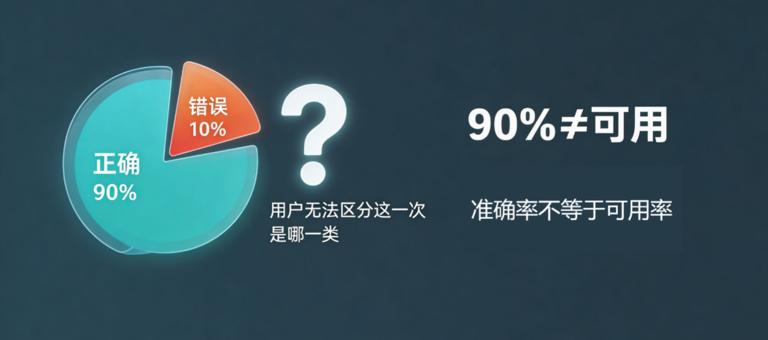
表一多、关联一复杂、语义一绕,大模型生成的 SQL 还是错,再用个中间层 DSL 是能提高点准确率,但离 100% 还差得远,而且还经常严重限制复杂度。行业全在卷准确率,50%→60%→70% 往上爬,没一个爬到“业务人员敢直接点执行”的线。
这些 AI 方案哪怕真有 90% 准确率也没法用。因为,AI 生成的中间 DSL——大多是一团 JSON——业务用户看不懂,也没法确认自己是不是踩中那 10% 的雷。黑盒面前,准确率高低并没什么意义。
03 把仓库里的老引擎重新拎出来,发现短板刚好错开
我们又把仓库里那套 NLQ 引擎重新拎出来看。
一看,愣住了。原来两边的短板,刚好错开——
NLQ:复杂性、准确性、多表外键穿越、带 JOIN 子查询、动词字段多维识别,全都能做。就是听不懂灵活口语。
大模型:口语转写溜。但复杂语义下一落 SQL 就容易晕。
我们当年搞不定的事,大模型现在搞定了;而大模型现在搞不定的事,我们当年搞定了。
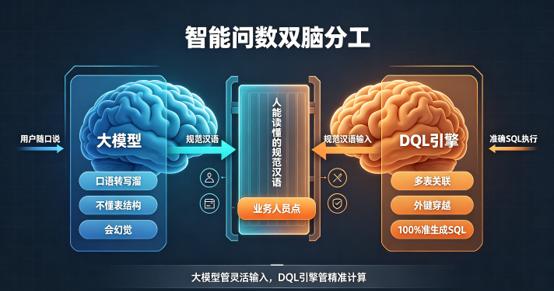
那么,就不要让大模型直接写 SQL,也不要让它吐黑盒 DSL,只让它干一件轻活:
把用户随口说的话,翻成“规范汉语”。
不用懂表结构,对着主题词典和提示词就行。负担小、不容易晕。就算偶尔幻觉,转出来的也是人话,业务人员一眼能看出“它这次转没转晕”。
转对了,人点确认,NLQ 接手,100% 准生成 SQL 跑数。
转晕了,拒掉重说,或让模型再转一次。
那 10% 的不准,被挡在人机交界处,进不到数据层。
04 双脑方案:大模型管灵活,NLQ 管准确
就是这套“大模型管灵活 + NLQ 管准确”的双脑方案,润乾在 2025 年下半年开始把十多年前的代码翻出来重整——对接现代应用框架、理词典、调提示词、磨大模型接口。
最头疼的是并不是 NLQ 引擎的升级整理,而是大模型输出不稳:今天调通 10 句,明天加 5 句,前面又歪了。
转机在 2026 年 7 月后。国产大模型稳定性明显上了一个台阶,这事才算能真正落地。
春节后推出版本,到夏天,变成了一个业务人员敢点“执行”的东西。
一个业务端敢用、准头兜底、灵活在前的小闭环,成了。
05 十二年前没走完的路,被大模型接着走完了
这就是润乾智能问数 NLQ 的由来。
不是大模型写 SQL 的新 demo,也不是老引擎再刷漆。
是当年被“听不懂人话”卡死的高复杂度查询引擎,等来了最会听口语的伙伴。
大模型管灵活输入,NLQ 引擎管准确计算,中间用“人能读懂的规范汉语”做闸,把不可信拦在门外。
仓库里那套 2013 年的代码,终于不用再吃灰了。十二年前没走完的那段路,被 2025 年的大模型接着走完了。