
令准确率失去意义的智能问数 Text2SQL 技术
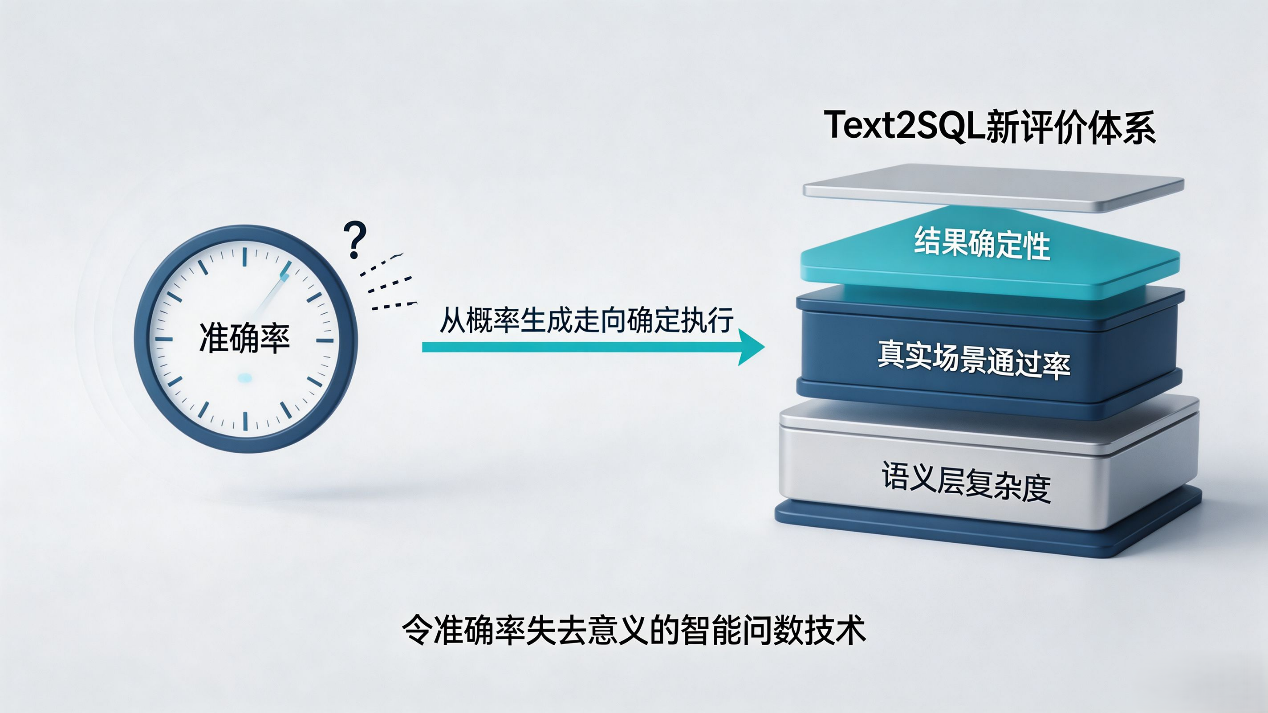
智能问数赛道,“准确率”一直是各家厂商的必争之地。从 70% 到 90%,再到 95%,数字一路走高,用户的困惑却从未减少:为什么演示时百发百中,一到真实业务场景就频频出错?为什么明明标注 90% 准确率,自己用起来却远不是那么回事?
问题的根源,从来不是准确率数值够不够高,而是这个指标本身,在新一代技术路线面前正在失去意义。当一套 Text2SQL 系统能做到“执行前可确认、执行中可确定”,所谓准确率就不再是一个需要比拼的数字;而真正决定系统价值的,是它能覆盖多复杂的业务场景、能通过多少真实的口语化查询——也就是通过率与复杂度边界。
准确率,一个自带“水分”的指标
行业里张口就来的 90%+ 准确率,其实藏着两层最基础的水分。
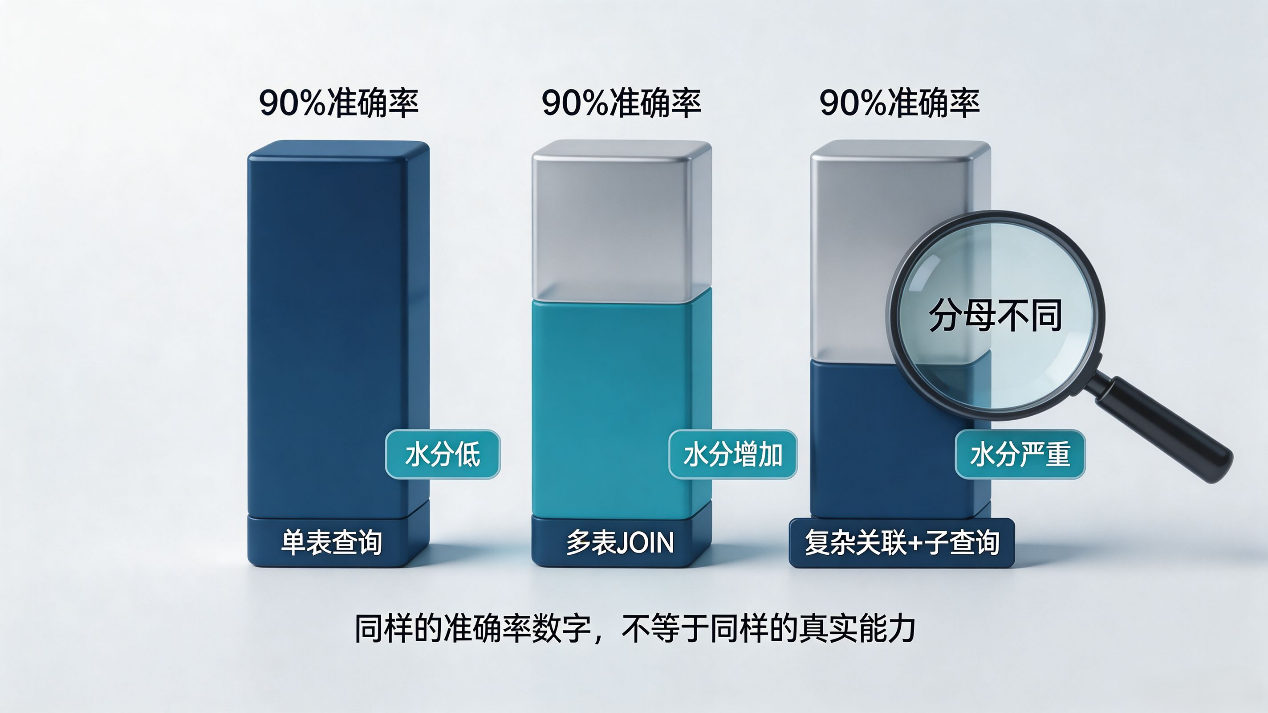
第一层是分母陷阱。同样是 90% 准确率,测试的范围天差地别。如果分母是一张单一大宽表,没有 JOIN、没有子查询、没有复杂口径,大模型跑出高分并不难;可一旦涉及两三张表的关联查询,准确率就会断崖式下跌到 50%-60%;如果再叠加多层子查询、跨表维度对齐、复合指标计算,结果更是惨不忍睹。厂商口中的高准确率,往往是在最宽松的测试条件下得到的,换到真实企业的多表业务环境,数字直接打对折都不止。
第二层是应试困境。Spider、WikiSQL 这类公开测试集,表结构固定、提问方式规范,厂商可以针对性地优化模型、调试 Prompt,甚至提前把所有表结构、常见问法都“喂”给系统。跑出来的分数光鲜亮丽,可换到企业独有的数据模型、五花八门的业务口语,立刻水土不服。通用测试集的分数,只能证明“在这套题上练得好”,证明不了“在真实场景能用”。
但最核心的问题还不在于数值掺水,而在于准确率这个指标本身的天然缺陷。就算一套系统真的能在真实场景达到 90% 准确率,但用户不是工程师,无法判断出这一次查询是不是那出错的 10%。企业经营决策不是概率游戏,一次错误的结果就可能导致判断偏差,用户对系统的信任崩塌,往往只需要一次失误。
从这个角度说,90% 准确率和 80% 准确率没有本质区别,都是黑箱输出,都要靠用户赌运气。
为什么说润乾 NLQ 技术,让准确率失去了意义?
润乾 NLQ 走了一条完全不同于“大模型直接生成 SQL”的技术路线:它不再试图让 AI 一步到位猜中所有逻辑,而是把整个流程拆成“语义转译—人工确认—规则编译”三段,用确定性的技术架构,彻底消解了“准确率”这个命题。
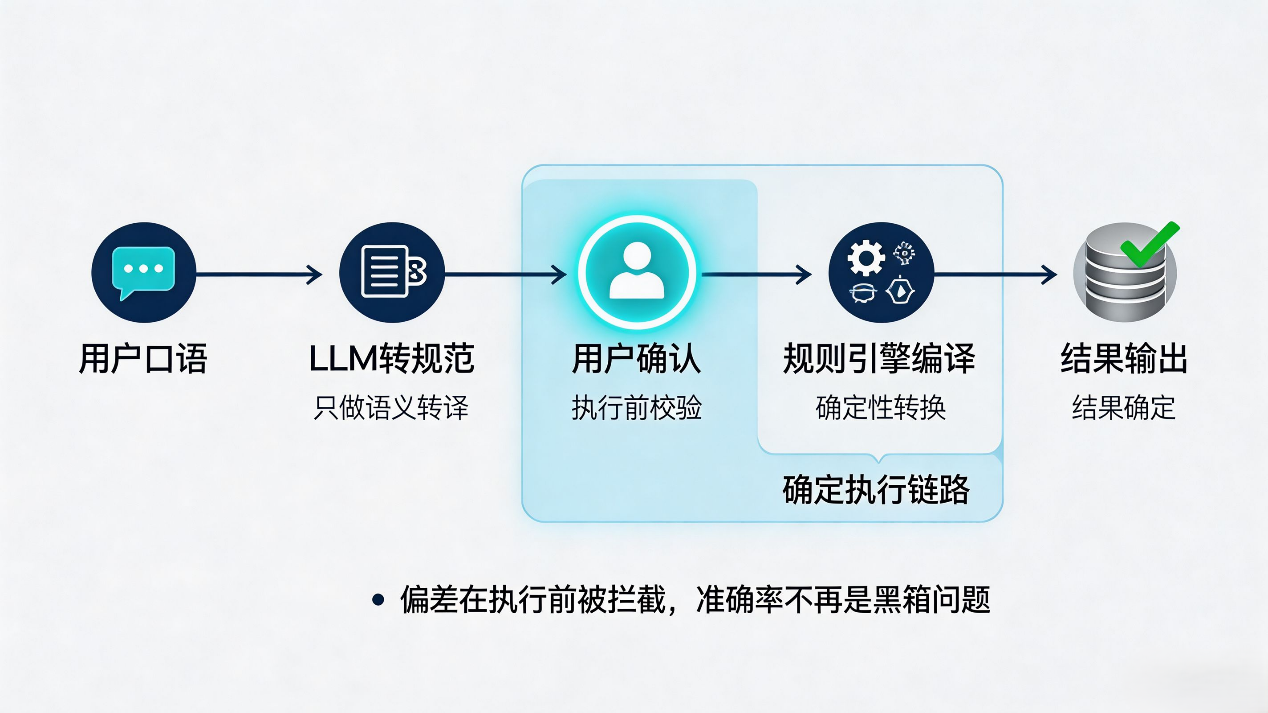
第一步,LLM 只做口语转译,不做逻辑决策。大模型最擅长的是自然语言理解,而非严谨的数据库逻辑推理。那就让它回归本位,只负责把五花八门的业务口语、模糊表达、行业黑话,统一整理成标准化的规范文本。它不需要懂表结构、不需要写 SQL,只做语义层面的转换,出错概率被大幅收窄。
第二步,人类可读的规范文本,把确认权交还给用户。这是整套技术最关键的一步:规范文本用自然语言呈现查询意图,比如“去年 华北区 订单总金额 按月份汇总”,业务人员不需要任何技术背景,扫一眼就能判断“对,这就是我要查的”,或是“不对,我要的是发货地不是客户所在地”。
所有理解偏差都在执行前就被拦截,而不是等返回结果后才发现答非所问。
第三步,规则引擎确定性编译,执行路径 100% 准确。用户确认后的规范文本,通过规则引擎编译成 SQL。每一次表关联、每一次维度聚合、每一个指标口径,都基于预先定义的语义规则,没有概率、没有猜测、没有模型自由发挥的空间。只要规范文本确认无误,最终的 SQL 和查询结果就一定正确。
在这套架构里,“准确率”这个概念从执行环节彻底消失了。从规范文本到 SQL,是 100% 的确定性转换,不需要讨论准确率;而 LLM 转译可能出现的偏差,会被用户确认环节过滤掉。最终交付给用户的有效结果,天然就是准确的。不是概率上的“大概率正确”,是逻辑上的“必然正确”。
比准确率更重要的,是通过率与复杂度边界
如果准确率不再是核心评价标准,那判断一套 Text2SQL 技术的强弱,该看什么? 答案是两个维度:复杂度覆盖和真实通过率。
复杂度,衡量系统能力的“含金量”
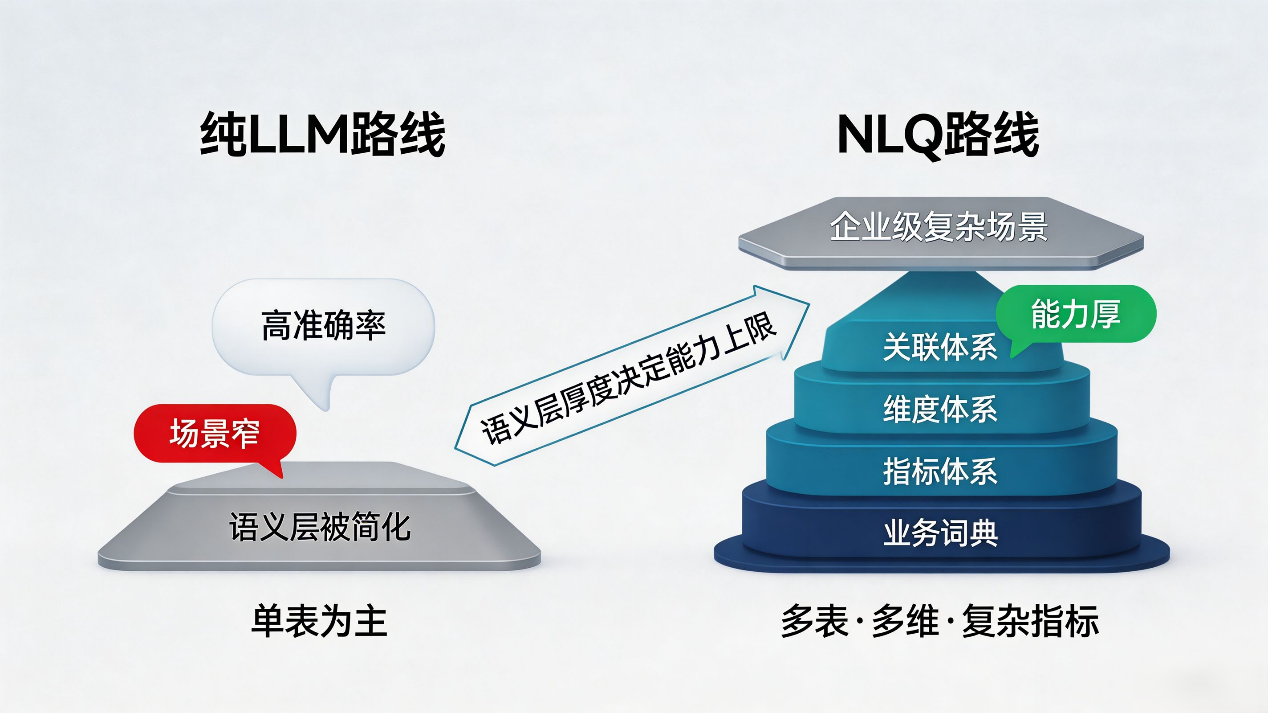
很多纯大模型方案也能交出好看的通过率数据,但代价是把语义层极度简化:只支持单表查询,砍掉多表关联、嵌套子查询、复杂指标计算。分母做小了,准确率自然漂亮,但企业级场景根本用不起来。
这是一个典型的死循环:为了保准确率,被迫简化语义层→语义层越简单,能处理的场景越少→场景越少,企业越用不上→越不敢投入丰富语义层。最终的结果就是演示场景无比惊艳,一到真实业务直接“残废”。
而 NLQ 技术的核心优势,恰恰是在高复杂度下依然保持稳定的能力。基于完整深厚的语义层,原生覆盖四大查询范式:单表明细、单表聚合、主子实体查询、多维对齐汇总。多表 JOIN、嵌套子查询、跨事实表按维度自动对齐,这些让大模型频频翻车的场景,都在语义层的规则覆盖范围内;排名、占比、环比这类业务常用的跨行运算都能完整支持。
语义层越复杂、覆盖的场景越完整,能处理的查询就越接近真实业务需求。这个“分母”足够大,在此基础上的通过率才有实际的企业级价值。
通过率,衡量真实场景的“接得住”
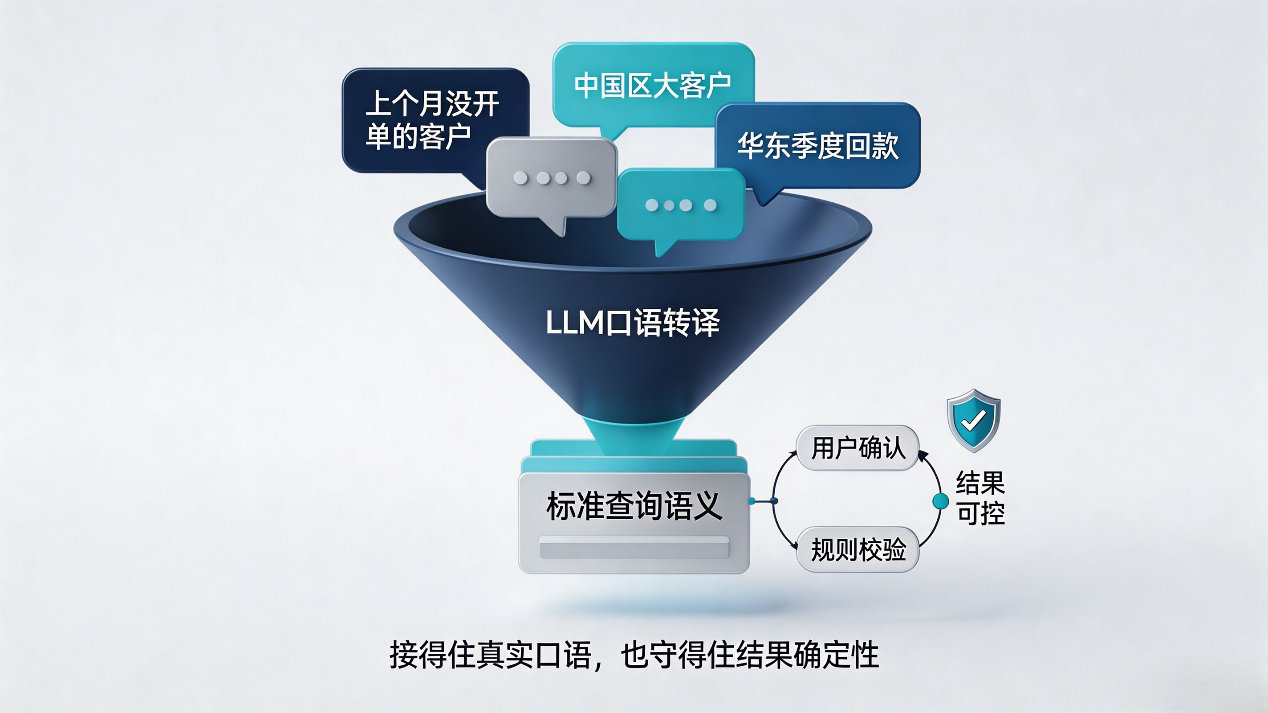
所谓通过率,看的不是在规范测试集里答对多少,而是面对真实用户的真实提问,系统到底能不能接得住。
业务人员不会按字段名和逻辑规范提问,他们会说“上个月没开单的客户有哪些”“中国区的大客户都有谁”,而不是说出标准的查询表达式。纯规则系统直接面对口语,通过率会非常难看;而 NLQ 通过 LLM 前置做口语转规范,把五花八门的日常问法都转换成系统可识别的结构,大幅提升了口语场景的通过率。
更重要的是,LLM 的加入并没有牺牲结果的确定性。它只负责“翻译”,不负责“决策”,所有翻译结果都经过用户确认,幻觉不会传递到后续的执行环节。在保证结果 100% 准确的前提下,尽可能提升真实场景的查询通过率,这才是面向落地的技术思路。
过去行业卷准确率,本质上是技术停留在 “黑箱生成” 阶段的产物。而润乾 NLQ 走 “透明可确认、规则可追溯” 的技术路线,将 Text2SQL 从 “AI 概率游戏” 拉回了 “企业级工具” 的定位,不追求在测试集上刷出好看的准确率数字,而是以足够宽的场景复杂度、足够高的口语提问通过率和 100% 确定的执行结果,让准确率这个指标本身失去了意义。智能问数的下半场,比拼的早已不是准确率数字的高低,而是技术路线的可控性、场景覆盖的全面性和结果的可信度;从 “卷准确率” 到 “重通过率、重复杂度、重可验证性”,这不止是评价标准的转变,更是技术路线的代差。