
WorkBuddy 调用润乾 NLQ MCP 实现数据查询分析实践
NLQ MCP DEMO for TPCH及SKILL说明
MCP说明
NLQ MCP DEMO for TPCH(下简称NLQ MCP或MCP)是基于TPCH数据源的数据查询MCP,它可以接收来自AI智能体生成的规范NLQ代码,执行并返回查询结果。
NLQ执行代码用汉语书写,普通业务人员也能看懂,从而可以确认AI生成的查询动作是否正确,避免AI幻觉曲解用户目标导致的错误。
这个DEMO以TPCH数据集为基础,读者可以了解NLQ的实施过程后改造其中的SKILL以适应其它数据主题并部署到其它地址上。
NLQ MCP 服务地址:http://d.raqsoft.com.cn:6888/mcp
该 MCP 提供三个工具:
工具名 |
说明 |
getLoginUrl |
获取OAuth 登录地址 |
login |
用 access_token 绑定会话身份 |
execute |
提交 NLQ命令并执行查询 |
nlq SKILL用于辅助WorkBuddy生成查询分析数据的命令,用户输入的自然语言需求,将被拆分为「查询/计算」与「呈现」两部分;前者转换为规范的NLQ代码,发送给MCP 执行查询;结果集返回后由 WorkBuddy 渲染。
SKILL的名称可以根据需要设定,最好足够简明,便于在实际使用中明确选择。
SKILL的安装
使用压缩包安装技能
从润乾NLQ查询演示页面(http://query.raqsoft.com.cn:6999/nlq4tpch.html)下载SKILL文件nlqdemoskill.zip解压,内容如下:
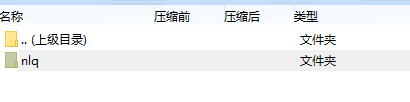
在nlq路径中则为技能相关文件:
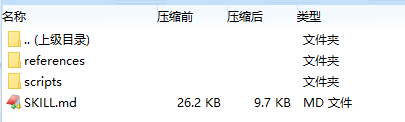
即可用这个压缩包在WorkBuddy中安装技能。
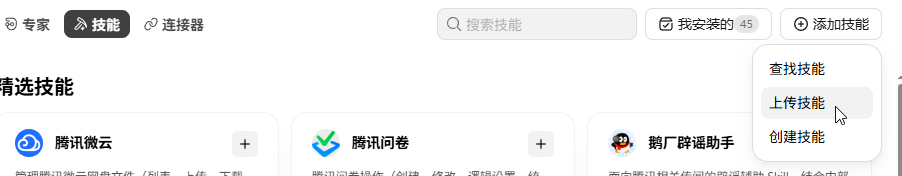
在 WorkBuddy 侧边栏中选择「专家·技能·连接器」→「技能」,在右上角选择「添加技能」→「上传技能」:
在导入技能窗口的左下角,点击「选择ZIP文件」:
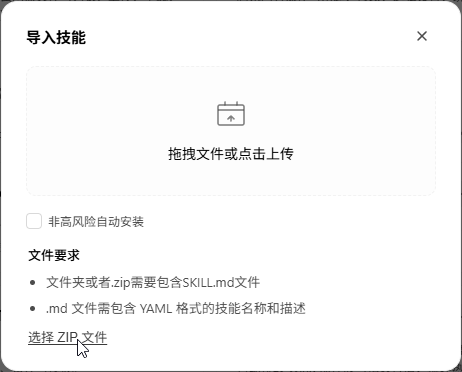
如果zip文件中的nlq技能当前不存在,WorkBuddy将从技能文件中识别出技能介绍,可以继续安装:
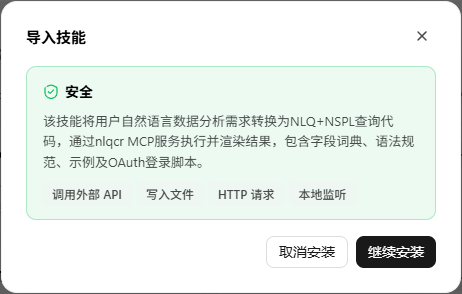
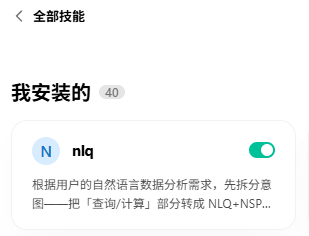
安装成功后,在列表中,即可看到导入的技能:
复制文件安装SKILL
也可以选择不使用压缩文件,而是直接把SKILL文件夹复制到WorkBuddy的路径中,再由WorkBuddy识别安装。
A.项目级安装(推荐团队共用)
①将nlq目录完整复制到项目根目录下的 .workbuddy/skills/ 中:
项目根/
└── .workbuddy/
└── skills/
└── nlq/
├── SKILL.md
├── references/
└── scripts/
②在 WorkBuddy 左侧「项目」→ 选择当前项目 → 「技能」或「配置」中确认 nlq 已出现在技能列表。
③若未自动发现,尝试重新加载项目或重启 WorkBuddy。
B.用户全局安装(个人多项目复用)
①全局技能在所有项目中可用,但项目级同名技能会覆盖全局版本。
①将目录复制到 ~/.workbuddy/skills/nlq/(Windows:`%USERPROFILE%.workbuddy\skills\nlq`)。
②全局技能在所有项目中可用,但项目级同名技能会覆盖全局版本。
SKILL文件体系
技能目录建议按以下结构组织(与 WorkBuddy Skill 规范一致):
nlq
├── SKILL.md # 主技能文件(触发词、流程、规则)
├── references/
│ ├── grammar-spec.md # 语法规则、查询范式、NLQ 语法、不支持类型
│ └── field-dictionary.md # 表结构、字段名、维词、常数词、聚合指标词典
└── scripts/
└── nlq_login.py # nlq OAuth 登录脚本(自动生成)
文件 |
作用 |
SKILL.md |
定义技能的完整处理流程、输出格式、失败重试策略、MCP 调用方式 |
references/grammar-spec.md |
查询范式、NLQ功能词列表、语法约束、不支持的查询类型及示例 |
references/field-dictionary.md |
当前数据源的表名、字段名、维词、常数词、聚合指标;注意:实测数据源 schema 可能与通用词典不同,需以 execute 返回的列名为准 |
scripts/nlq_login.py |
OAuth 登录辅助脚本;自动打开浏览器等待授权,成功后保存 |
NLQ MCP连接配置
配置步骤
①在 WorkBuddy 侧边栏点击「专家·技能·连接器」→「连接器」:
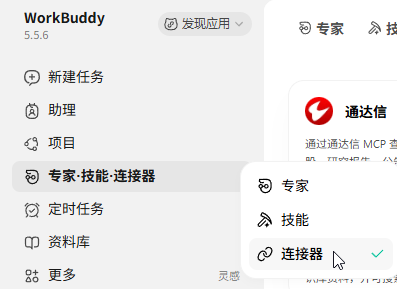
②在右上角点击「自定义连接器」→「配置MCP」:
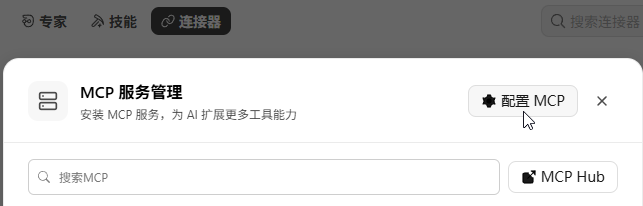
③编辑 mcp.json(项目级或用户级),添加MCP服务配置,名称用NLQ-MCP。示例:
{
"mcpServers": {
"NLQ-MCP": {
"url": "http://d.raqsoft.com.cn:6888/mcp",
"disabled": false
"description": "NLQ 查询执行服务"
}
}
}
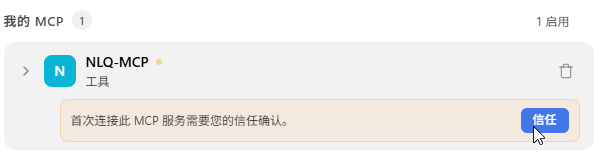
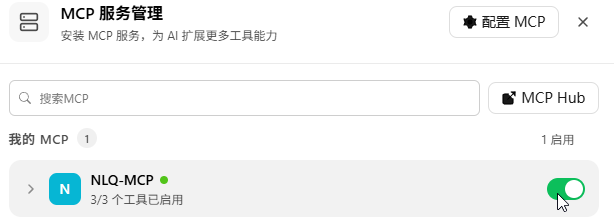
③保存后,在我的MCP中找到NLQ-MCP,点击「信任/启用」,状态变为绿色即连接成功。
技能中通过内置脚本自动登录MCP
首次调用 execute 前,或者登录过期时,需完成 OAuth 登录并获取 session_id。
在技能的SKILL.md中定义的登录脚本路径默认为:<技能目录>/scripts/nlq_login.py
①当 execute 返回未登录/鉴权失败错误时,Agent 会自动运行:
python <技能目录>/scripts/nlq_login.py <结果文件路径>
②脚本行为:
自动打开系统浏览器,跳转到 OAuth 授权页面;
等待用户授权(最多 5 分钟);
授权成功后,交换 token(使用 x-www-form-urlencoded 表单,非 JSON);
将 session_id 写入指定的结果文件;
后续请求通过 Mcp-Session-Id 头携带会话身份。
③同一会话内可复用已保存的 session_id;会话失效时重新运行脚本。
在首次调用技能时,如果MCP未连接,或者登录已过期,将弹出浏览器窗口:
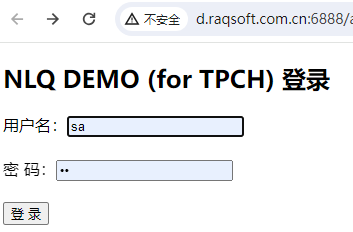
这里只是演示登录功能,并未做实际的用户口令检查,随便填上用户名和密码即可过关。
登录后,返回WorkBuddy可以继续执行技能:
手动登录(备用)
若自动脚本不可用,可手动调用 MCP 工具:
①调用 nlq_getLoginUrl 获取授权 URL;
②在浏览器中打开该 URL,完成授权,获取 access_token;
③调用 nlq_login 绑定会话;
④之后即可正常调用 execute。
如果在查询中出现问题,可以根据遇到的具体情况修改相关文件:
问题描述 |
修改建议 |
数据库变更 |
更新 references/field-dictionary.md,修改相关内容 |
NLQ语法变更 |
更新 references/grammar-spec.md,补充新功能词和示例 |
MCP名称变更 |
修改SKILL.md中有关MCP连接的内容,默认MCP名称是NLQ-MCP |
MCP登录异常 |
检查 scripts/nlq_login.py 中的处理 |
技能行为异常 |
检查 SKILL.md 中的重试逻辑和判定规则 |
SKILL调用
WorkBuddy中使用技能查询
技能安装成功后,在WorkBuddy中输入查询信息,它会自动选择使用技能,如果只有一个自然语言的查询技能,可以直接输入:查询客户信息以及它们的订单数,按照订单数降序排序,列出前10 名,保留同名次的。
如果存在多个类似的技能,可以在查询语句前指定技能名称,输入:/nlq 查询客户信息以及它们的订单数,按照订单数降序排序,列出前10 名,保留同名次的
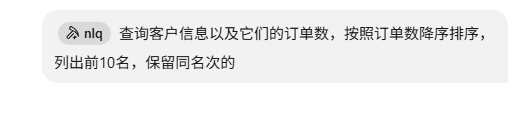
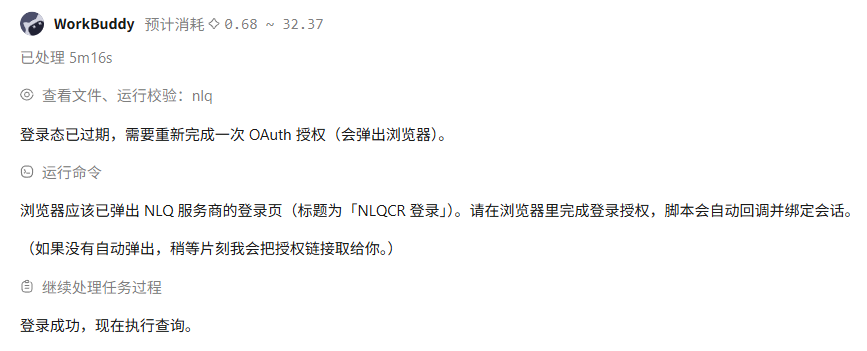

在返回结果中会列出执行命令列表(上图红框中),这些NLQ语句是AI生成并传送给MCP查询数据的,可以用于了解实际执行的计算过程。如果AI的理解和用户的目标有差异,就能及时发现,并在WorkBuddy中输入修改意见来纠正。
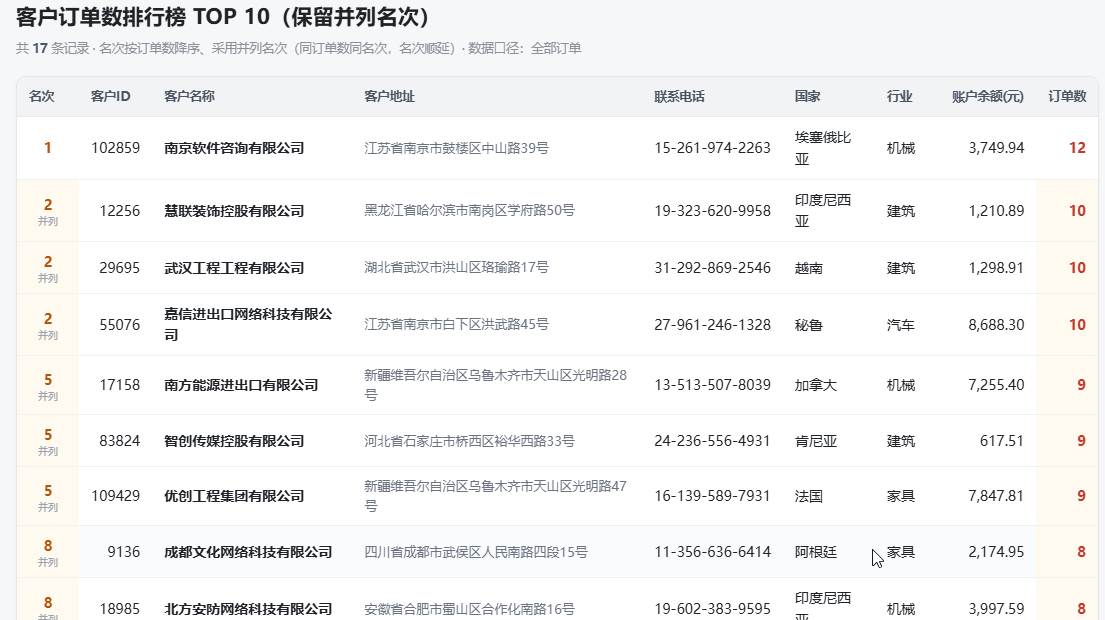
查询结果被整理为HTML,可在右侧结果窗口中查看:
正常流程
①用户输入自然语言查询
②智能体处理流程:
┌───────────────────┐
│ 意图拆分(第 0 步) │
│ · 查询/计算 → 后续步骤 │
│ · 呈现需求 → 暂存 │
└───────────────────┘
│
▼
┌───────────────────┐
│ 转换 NLQ码 │ ← 参考 grammar-spec.md + field-dictionary.md
│ 输出§A格式 │
└───────────────────┘
│
▼
┌───────────────────┐
│ 调用 NLQMCP execute │ ← 传入 §A 代码(去掉「实现代码:」前缀)
│ 检查登录状态 │ ← 未登录则运行 nlq_login.py
└───────────────────┘
│
▼
┌───────────────────┐
│ 判断返回形态 │
│ 形态1: JSON 结果集 │ → 进入呈现叠加(§D.3)
│ 形态2: 错误信息 │ → 进入重试/失败处理(§C)
└───────────────────┘
│
▼
┌───────────────────┐
│ 呈现叠加 │
│ · 仅表格 → Markdown │
│ · 表格+图表 → HTML │
│ · 仅图表 → show_widget │
└───────────────────┘
│
▼
输出给用户
失败重试路径
失败类型 |
处理方式 |
上限 |
转换自查失败(触发 A) |
重新转换 → 调用 execute |
3次 |
NLQMCP返回错误信息(触发 B) |
附加错误信息 → 重新转换 → 调用 execute |
3次 |
NLQMCP临时不可用(触发 C) |
短暂等待 → 重新调用 execute |
3次 |
输入歧义/不合理 |
不重试,输出§B要求改写 |
|
语法/词典不支持 |
不重试,输出§B要求改写 |
|
3 次都失败 |
输出§E错误汇总 + 分析 终止 |
查询示例
单表查询
明细查询
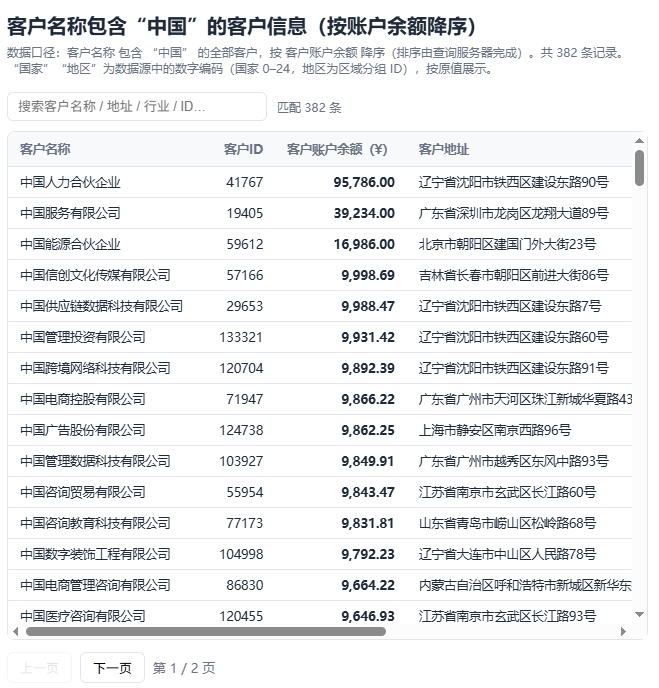
名称包含“中国”的客户信息,按账户余额降序排序
说明:单表的明细数据,模糊匹配字段过滤,结果需要排序。
实际查询结果:
执行命令(提交至 NLQ-MCP):
① 查询 “客户名称 包含 ‘中国’ 客户”
排序 客户账户余额 降序
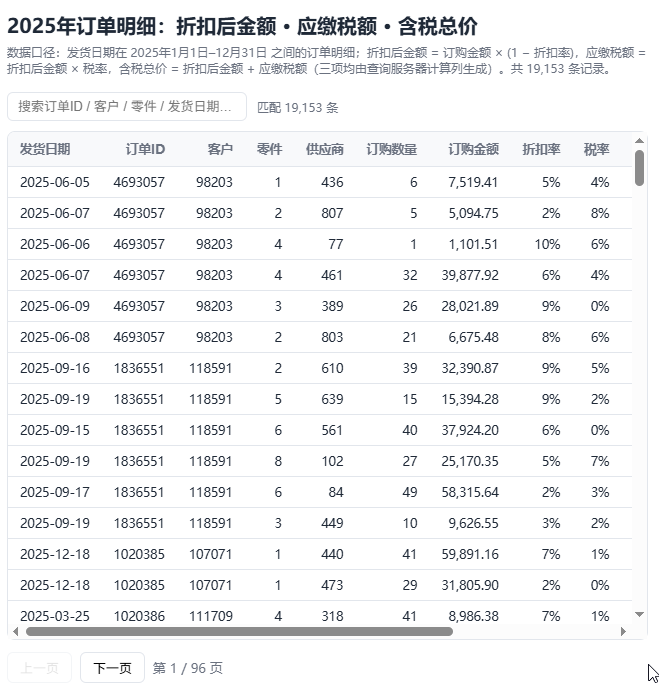
计算2025年订单明细的折扣后金额、税额和含税总价
说明:单表的明细数据,按字段值区间过滤,需要增加计算列。
实际查询结果:
执行命令(提交至 NLQ-MCP):
① 查询 “发货日期 2025年1月1日 至 2025年12月31日 订单明细”
计算列 订购金额*(1-折扣率) 命名 折扣后金额, 折扣后金额*税率 命名 应缴税额, 折扣后金额+应缴税额 命名 含税总价
汇总查询
计算月度订单总额、订单数量的环比增长率
说明:分组汇总,并环比计算增长率。
实际查询结果:
执行命令(提交至 NLQ-MCP):
① 查询 “年 月 订单金额 总和,订单 数”
排序 年 升序, 月 升序
计算列 订单金额总和 增长率 命名 总额环比, 订单数 增长率 命名 数量环比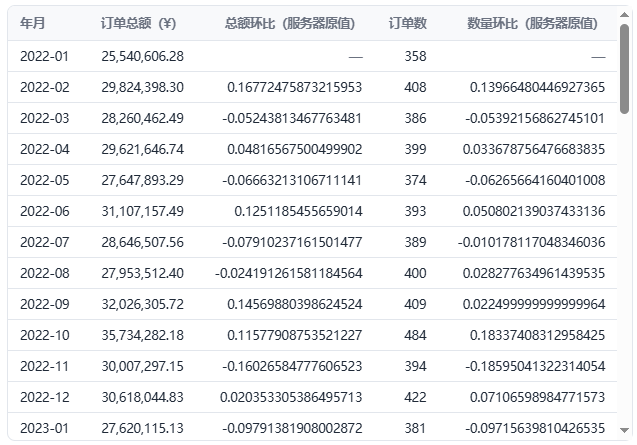
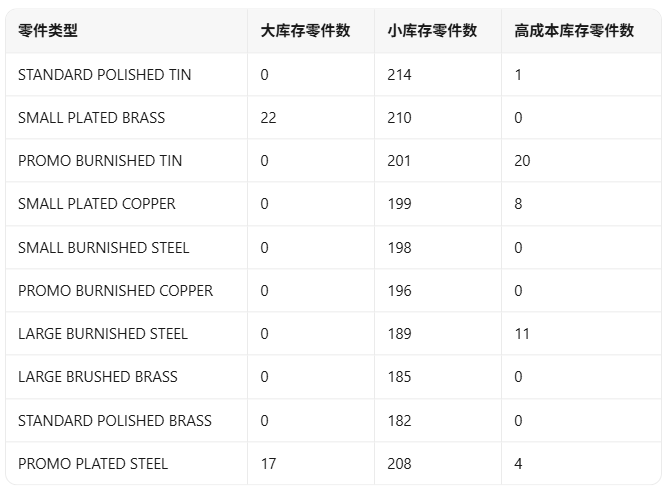
各零件类型的大/小库存与高成本库存零件数
说明:查询复杂聚合指标。
实际查询结果:
执行命令(提交至 NLQ-MCP):
① 查询 “零件类型 大库存零件数,小库存零件数,高成本库存零件数”
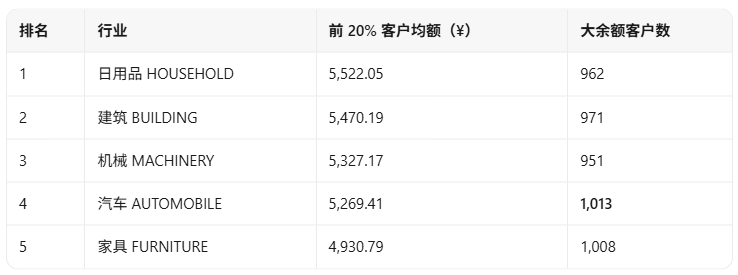
各行业 前20% 客户均额与大余额客户数
说明:查询复杂聚合指标,包括带参数的指标。
实际查询结果:
执行命令(提交至 NLQ-MCP):
① 查询 “行业 前20客户均额,大余额客户数”
排序 前20客户均额 降序
复杂查询
查询2025年订单金额高于平均订单金额的订单
说明:根据单表的汇总结果来执行过滤。
实际查询结果:
执行命令(提交至 NLQ-MCP):
① 查询 “2025年 订单”
计算列 订单金额 平均 命名 平均金额
筛选 订单金额>平均金额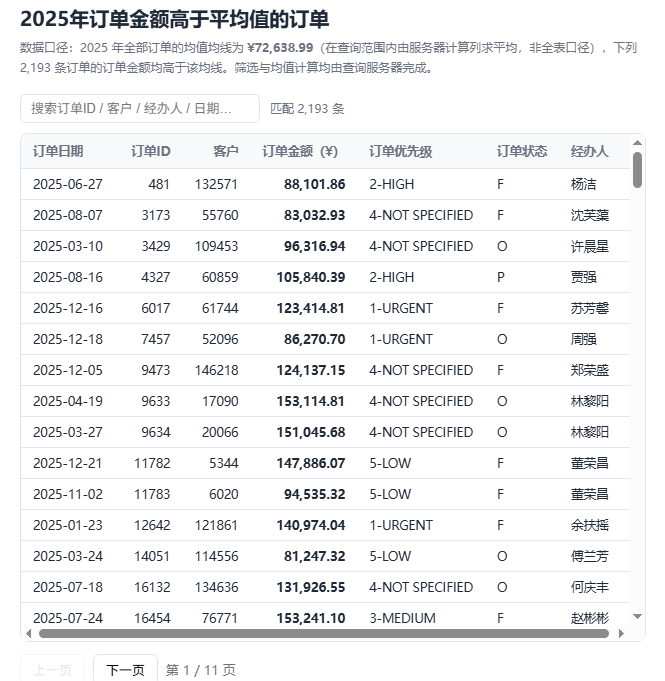
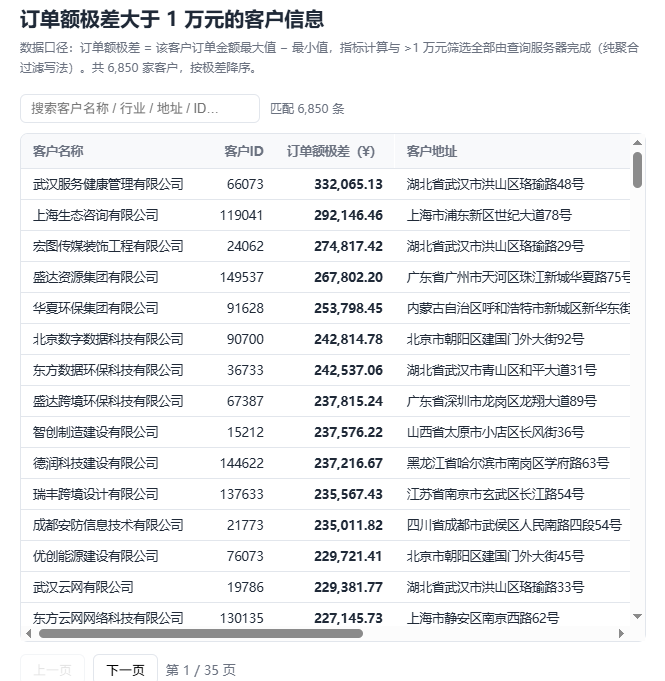
订单额极差大于1万元的客户信息
说明:订单额极差是复杂聚合指标,需要计算同一客户的最大订单额和最小订单额的差。计算后再根据结果执行过滤。
实际查询结果:
执行命令(提交至 NLQ-MCP):
① 查询 “订单额极差大于10000,客户”
排序 订单额极差 降序(NLQ-MCP 排序)
多表关联查询
多表汇总查询
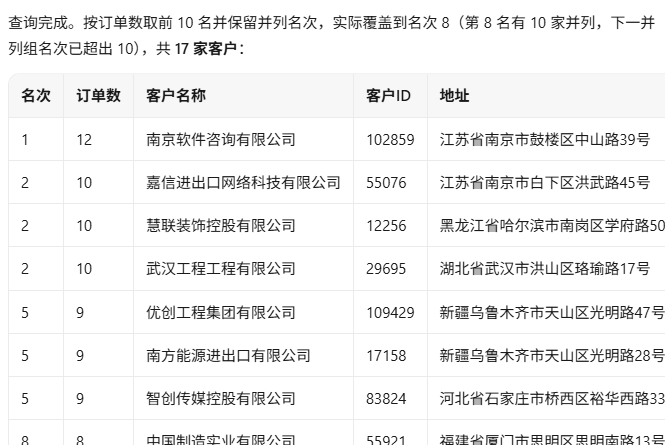
查询客户信息以及它们的订单数,按照订单数降序排序,列出前10名,保留同名次的
说明:主子表汇总查询,并根据汇总结果排序以及过滤。
实际查询结果:
执行命令(提交至 NLQ-MCP):
① 查询 “客户,订单 数”
排名 订单数 降序 前 10 命名 名次
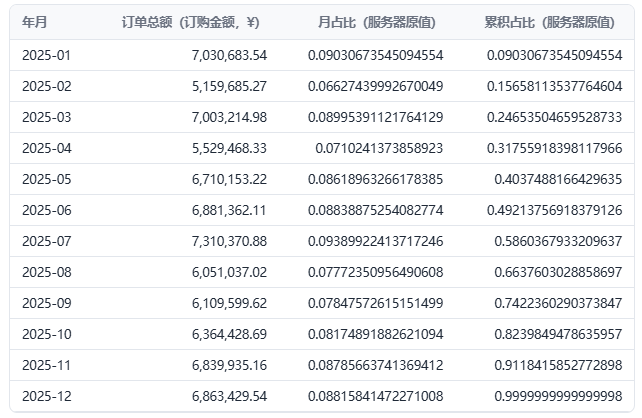
上海实业数据科技有限公司生产的商品2025年每个月的订单总额和累积占比
说明:通过多表关联关系分步查询数据,再汇总计算。
实际查询结果:
执行命令(提交至 NLQ-MCP):
① 查询 “制造商名称 上海实业数据科技有限公司 零件”
② 查询 “零件 2 发货日期 2025年1月1日 至 2025年12月31日 年月,订购金额 总和”
排序 年月 升序
计算列 订购金额总和 占比 命名 月占比, 月占比 累计 命名 累积占比
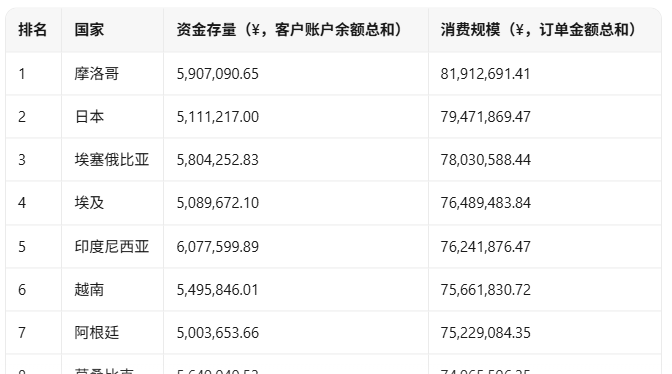
各国客户的资金存量和消费规模
说明:多表的按维汇总。
实际查询结果:
执行命令(提交至 NLQ-MCP):
① 查询 “国家 客户 客户账户余额 总和, 订单 订单金额 总和”
多表关联的复杂查询
亚洲客户2025年每个月的大额订单数
说明:通过关联表过滤数据,并计算复杂聚合指标。
实际查询结果:
执行命令(提交至 NLQ-MCP):
① 查询 “地区 亚洲 2025年 年月,大额订单数,订单 数”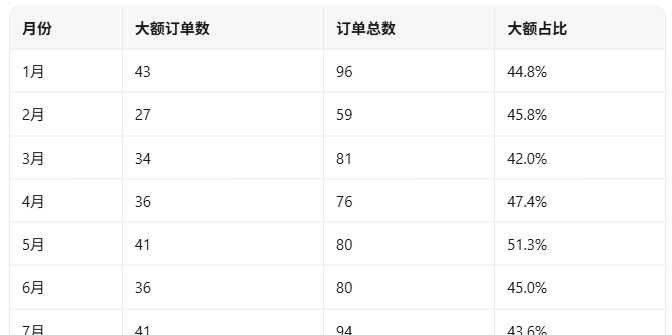
技能执行后的后续分析
取得数据后绘图
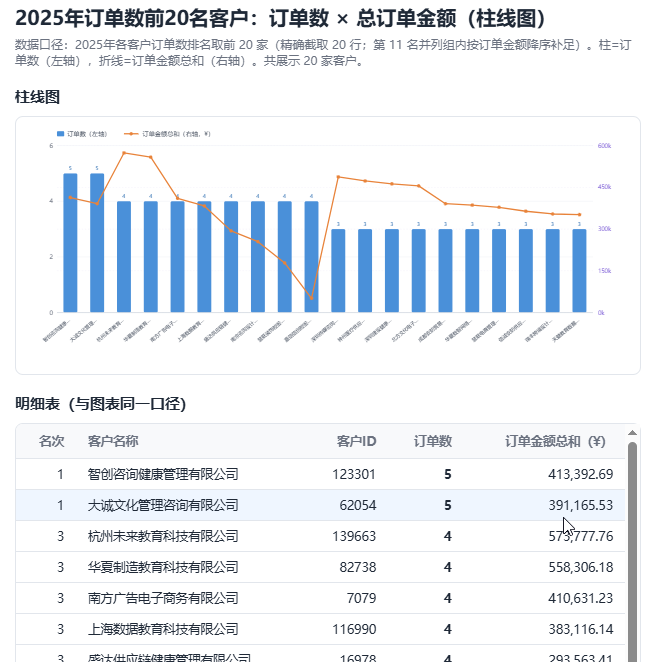
列出2025年,订单数精确前20名客户的订单数和总订单金额,并绘制柱线图
说明:主表和多个子表的汇总查询,并按汇总结果排序及过滤。这里绘制统计图由WorkBuddy根据返回数据来生成。
实际查询结果:
执行命令(提交至 NLQ-MCP):
① 查询 “客户,2025年 订单 数,订单金额 总和”
排名 订单数 降序 前 20 命名 名次
针对统计结果进一步分析
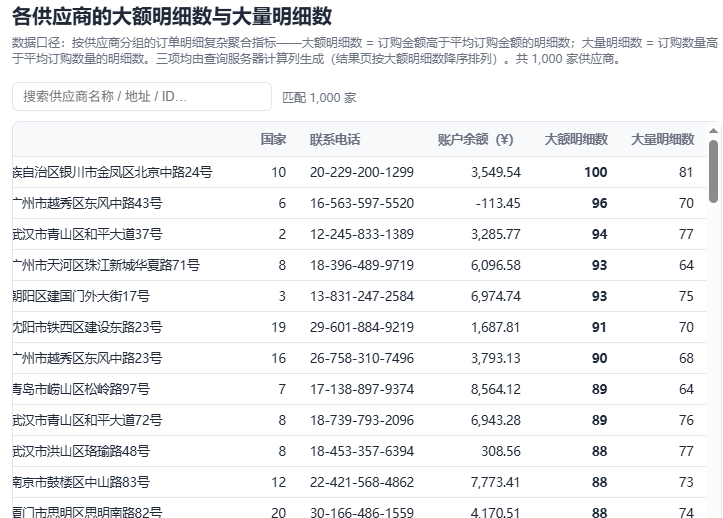
各个供应商的大额明细数与大量明细数
说明:分组汇总,计算复杂聚合指标。
实际查询结果:
执行命令(提交至 NLQ-MCP):
① 查询 “供应商 大额明细数,大量明细数”
排序 大额明细数 降序
这个数据能得到什么结论吗?
说明:查询与nlq技能无关,由WorkBuddy自行回答。
实际查询结果:
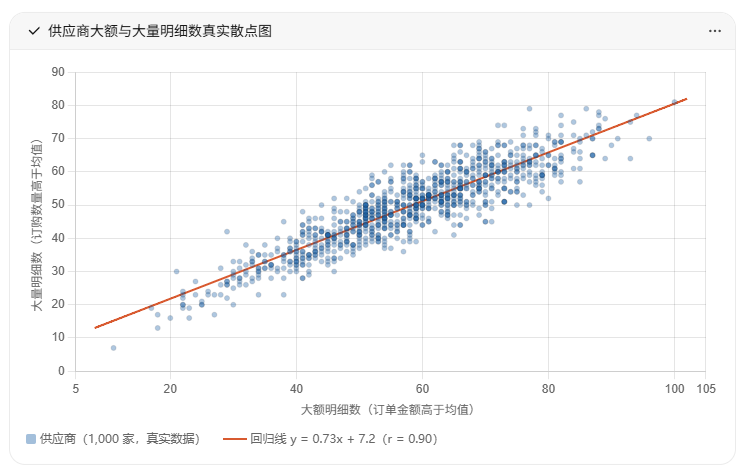 能,而且这份数据的形态比排名本身更有信息量。先更正一点:第一版散点图我用了近似示意点,上方已用 1,000 家真实数据重画,结论以真实版为准。以下是基于真实数据的分析(对已取回结果的呈现层统计,服务器原始数值未改动):
结论 1:大额能力与大量能力高度绑定(r = 0.901),几乎不存在“专项型”供应商
回归线 y = 0.73x + 7.2,拟合度很高;散点紧密贴着趋势线分布;
极端类型一家都没有:大额明细数 ≥50 但大量 <20 的供应商为 0 家;反过来也为 0 家;双高型(大额 ≥50 且大量 ≥40)多达 725 家;
这推翻了我上一轮的初步说法(“贵和量大是两类不同供应结构”)——数据说明恰恰相反:接大单多的供应商接大批量的也多,两者是同一种“规模承接能力”的两个侧面。选商时不需要按“大单型/批量型”分别建库。
结论 2:供应商能力高度均匀,没有真正的头部
大额明细数范围 11–100,均值 58.0 与中位数 59 几乎重合,p10=40 / p90=77,分布对称无长尾;
集中度极低:大额明细数总和的 Top10 占比仅 1.6%,Top50 也只有 7.4%;
业务含义:头部(中华环保 100/81)与榜尾(11/7)虽然差近 10 倍,但整个盘子是平缓坡而非金字塔——靠“换更大的供应商”来提升承接能力的空间很小,差异化要在价格、质量、地区等其他维度找。
结论 3(数据质量提示):这种“完美均匀”的形态不太像真实供应链
真实世界的供应商能力通常呈右偏长尾(少数巨头 + 大量小厂),而这里是均匀分布、两端对称——结合此前零件零售价集中在 ¥901–910 等特征,这份数据源大概率是按均匀分布生成的模拟数据。结论 1、2 在本数据集内成立,但如果要把这套分析方法迁移到真实业务,预期分布形态会不同(真实场景 r 会低一些、集中度会高很多)。
基于已有的结果,分析一下各种订单适合哪种供应商吧,分类时用数据
说明:查询与nlq技能无关,由WorkBuddy根据前面的分析和查询结果总结。
实际查询结果:
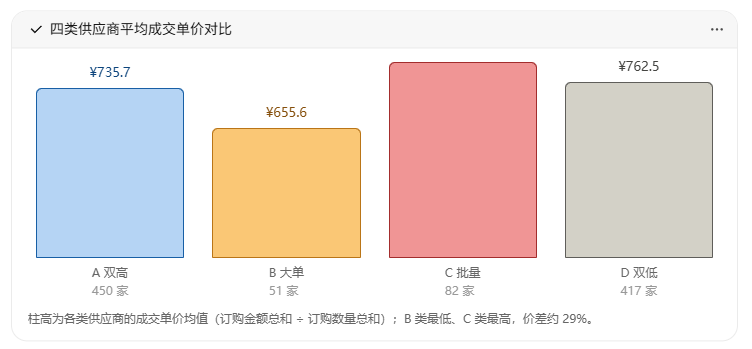
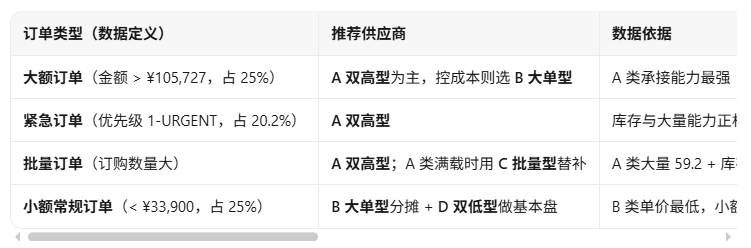
解析查询结果
交叉统计各订单优先级与订单状态下的订单数和金额
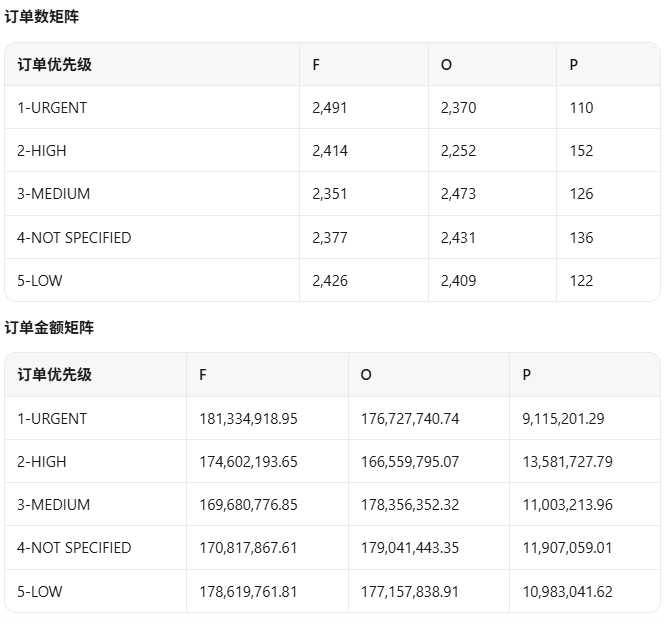
说明:分组汇总后,结果显示为交叉表,并进一步分析。
实际查询结果:
执行命令(提交至 NLQ-MCP):
① 查询 “订单优先级 订单状态 订单 数,订单金额 总和”
继续输入:分析一下结果
说明:查询与nlq技能无关,由WorkBuddy自行回答。
实际查询结果:
P 状态订单显著少(每档仅 110–152 笔),是典型的少量“待处理/挂起”尾巴;其中 2-HIGH × P 金额占比最高(¥1,358 万),最值得关注清理;
F 与 O 两类体量相当(各约 2,300–2,500 笔、¥1.65–1.81 亿),说明整体订单约一半仍处于未完成状态;
优先级之间的分布非常均匀——订单数和金额并未随优先级升高而倾斜,说明优先级标记与实际订单价值关联不大(1-URGENT 与 5-LOW 的金额几乎同量级)。