
数据治理还不完善时能不能建设智能问数?
很多智能问数厂家在谈方案时都会强调一致全面的语义层以保证准确率,把做好数据治理作为建设智能问数的前置步骤,也以把大量技术力量用于如何解决数据治理。
智能问数是否有效确实相当大程度依赖于数据治理的结果,但问题是,数据治理并不能一蹴而就,不完善才是常态,而且会永久处于变化中。绝大多数企业的业务系统都是逐步建设的,口径不一、同名异义、异名同义比比皆是。如果非要等数据治理完美了再做智能问数,可能永远都等不到那一天。
关键不是治理完再上,而是选对技术路线,在数据治理不完美的情况下,也能落地、能验证、能逐步优化。
数据治理越差,LLM 方案越危险
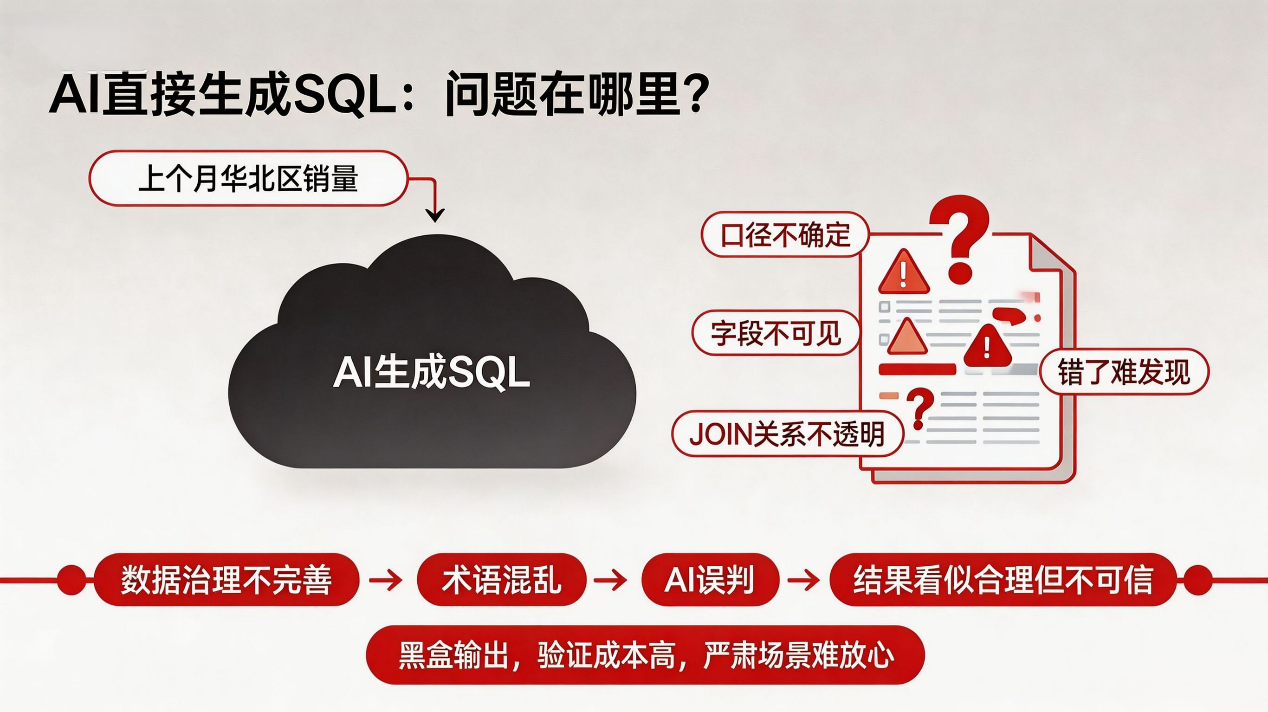
市面上主流的大模型方案,本质上是 "AI 猜数据"。数据治理越完善、表结构越标准,它猜得越准;数据越乱、术语越不统一,它错得越离谱。
更要命的是,错了还发现不了。用户看不懂 SQL,只能看最终结果。AI 生成的结果看起来有模有样,到底用了哪张表、哪个字段、按什么口径算的,没人知道。等发现数字对不上,都不知道问题出在哪。是模型幻觉了?还是术语理解错了?还是 JOIN 关系不对?定位问题像破案,修复成本极高。
数据治理不完善的场景下,用 LLM 生成 SQL,等于把数据质量的控制权完全交给了黑盒。治理越差,翻车概率越高,越不敢用在严肃业务场景。
NLQ 的优势:单条验对了,全量就都对
润乾 NLQ 的机制,天然适合治理不完善的场景。
NLQ 不是让 AI 直接生成 SQL,而是先把自然语言转成规范文本(一种自然语言形式的 DSL),再由规则引擎编译成 SQL。规范文本里的每个词,都对应词典里明确定义的表、字段和计算逻辑。
这意味着什么?你只要验证一条,就能确认一类查询的正确性。
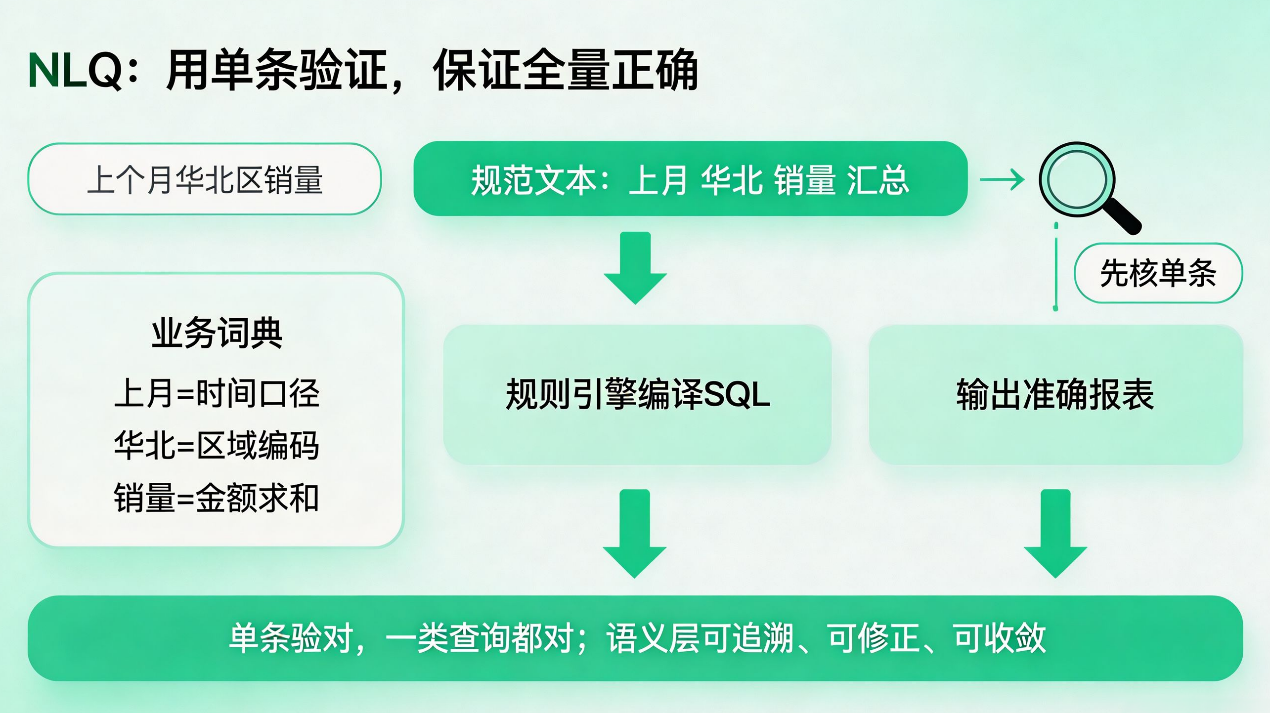
比如 "上个月华北区销量",转成规范文本是" 上月 华北 订单金额 汇总 "。你只要拉出一条明细数据核对一下:" 上月 "是不是对应上个月?" 华北 "是不是对应正确的区域或编码?" 销量 "是不是按订单金额口径计算?单条验证通过了,说明这个词的映射逻辑就是对的。以后所有涉及" 上月 "" 华北""销量" 的查询,逻辑就都是对的,不会这次对下次错。
这和 LLM 完全不同。LLM 是每次都重新生成,这次对了不代表下次也对;NLQ 是规则驱动,一次验证正确,永久正确。数据治理不完善没关系,先把常用的词配置好、验证对,就能先用起来。
从官方实践来看,即使是表关联复杂、术语不统一的场景,通过 "配置一个、验证一个、上线一个" 的方式,也能快速把核心业务场景跑通,不用等整个数据治理项目收尾。
NLQ 本身就是语义层治理工具
智能问数是数据治理后的上层应用,这没错。但好的智能问数技术还可以反过来协助数据治理,成为逐步完善语义层的工具。
什么是语义层?就是把业务语言和数据结构对应起来的中间层,业务术语对应哪个表、哪个字段、什么计算口径,都定义在语义层里。它是所有数据应用的业务底座,语义层越完善,上层应用越靠谱。
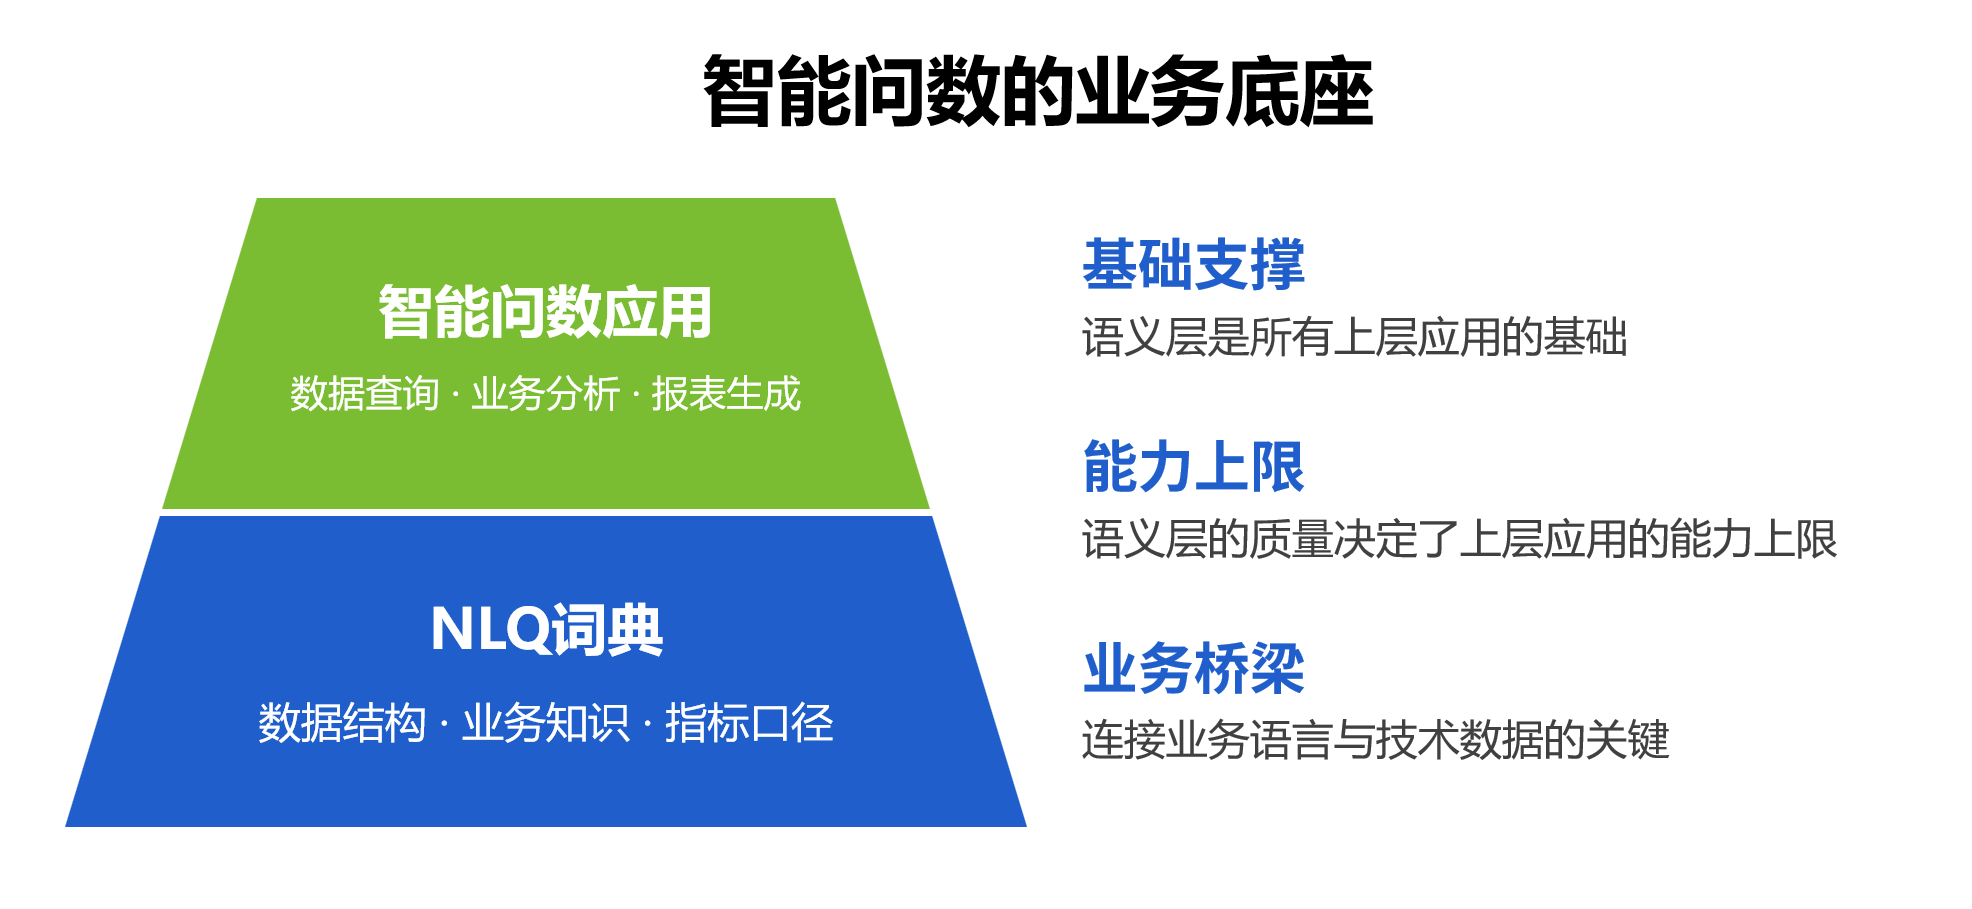
NLQ 的业务词典,本身就是一个轻量化的语义层。建设智能问数的过程,同时就是建设语义层的过程:
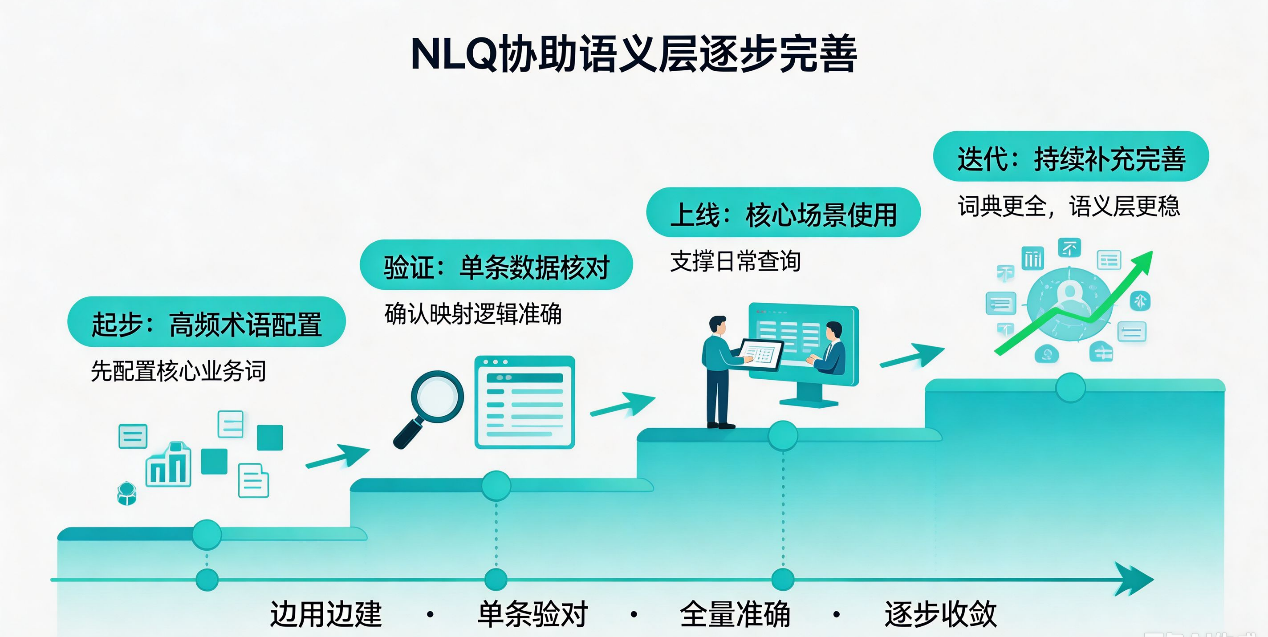
先从高频词开始:把业务最常用的几十个术语先配置进词典,验证准确,先支撑核心查询场景
边用边补充:遇到新的业务说法,就补充进词典;发现口径不对,就修改规则。每一次修改都是确定的,不会影响已经验证过的部分
逐步收敛:用得越久,词典覆盖的术语越全,语义层越完善,通过率越高
而且可以借助 LLM 辅助生成词典,用大模型自动生成各类词型,再人工检查修正,大幅提升初始建设效率。但生成的结果必须人工校验,因为 LLM 可能有幻觉,这一步不能省。
整个过程是可追溯、可修正、可收敛的。不像大模型方案调优像开盲盒,改完提示词不知道哪些会变好、哪些会变坏。NLQ 的语义层建设,每一步都清清楚楚,越用越完善,不会走回头路。
智能问数不是数据治理的终点,而是起点。
不用等数据完美了再动手。NLQ 在治理不完善的阶段也能落地能用,还能反过来推动语义层逐步完善。从几个核心术语、几个高频场景开始,边用边建、越用越准,反而是更务实、更高效的路径。毕竟,业务能拿到准确可用的数据,比追求理论上的完美治理重要得多。