
AI 式文字编程写 SQL,不用大模型能做到什么程度?
简单的 SQL 本来看起来就像英语一样,算是一种文字式编程。比如,查订单表里金额大于 100 的订单:SELECT * FROM orders WHERE amount > 100
但当任务复杂时,需要用到 CTE、窗口函数等等,虽然还是那些英语关键字,写出来的 SQL 却越来越没法读了
比如这个需求,一张表记录多个账户的时间区间,区间之间有重叠,要把每个账户内相互重叠的区间合并成不相交的新区间。写出 SQL 是这样:
WITH t2 AS (
	SELECT
		account_id,
		start_date,
		end_date,
		MAX(end_date) OVER (
			PARTITION BY account_id
			ORDER BY
				CASE WHEN account_id IS NULL THEN 1 ELSE 0 END,
				account_id ASC,
				CASE WHEN start_date IS NULL THEN 1 ELSE 0 END,
				start_date ASC
			ROWS BETWEEN UNBOUNDED PRECEDING AND 1 PRECEDING
		) AS prev_max
	FROM
		tb
),
t3 AS (
	SELECT
		account_id,
		start_date,
		end_date,
		prev_max,
		1 + SUM(
			CASE
				WHEN start_date > prev_max THEN 1
				ELSE 0
			END
		) OVER (
			PARTITION BY account_id
			ORDER BY
				CASE WHEN account_id IS NULL THEN 1 ELSE 0 END,
				account_id ASC,
				CASE WHEN start_date IS NULL THEN 1 ELSE 0 END,
				start_date ASC
		) AS gid
	FROM
		t2
)
SELECT
	account_id,
	MIN(start_date) AS start_date,
	MAX(end_date) AS end_date
FROM
	t3
GROUP BY
	account_id,
	gid
ORDER BY
	account_id,
	start_date;
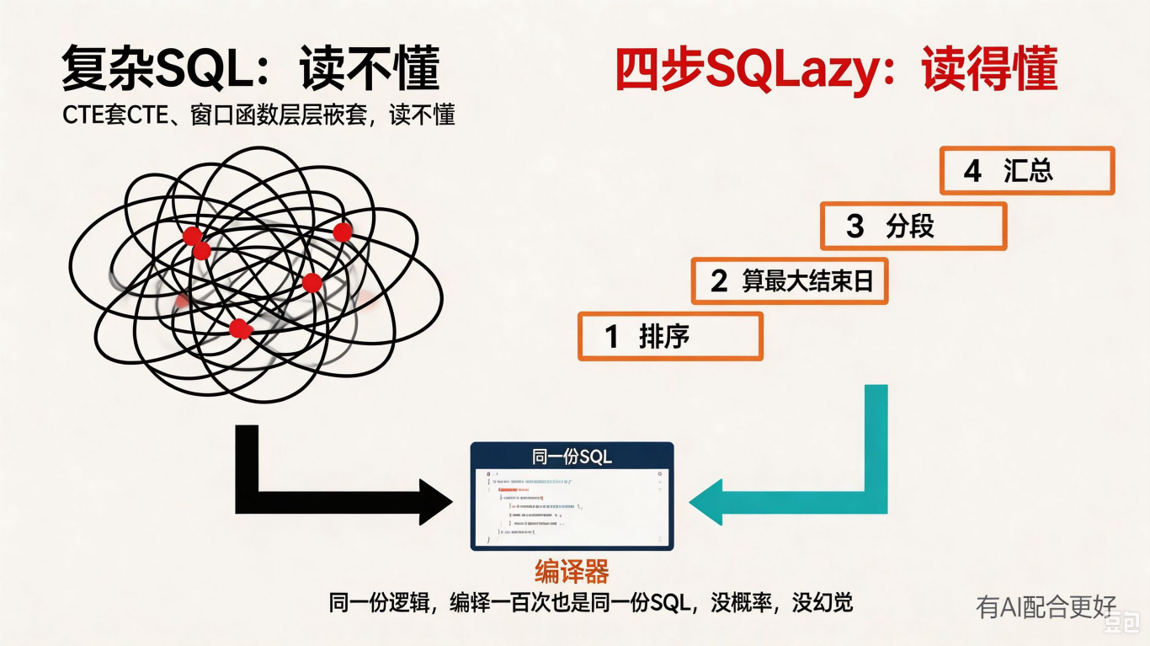
其实,我们只要给 SQL 增加分步的机制,再补充一些能处理有序运算(窗口函数)的动作,复杂的 SQL 也可以像自然语言一样读写了。
SQLazy 就是这样:把复杂逻辑拆成步骤,每一步都还是简单 SQL 那种人人都看得懂的文字。
比如刚才那个任务写出来是四步:
t1=tb: 排序 account_id, start_date
t2=计算列 最大, end_date[:-1], 命名 prev_max; 分区 account_id
t3=分段 条件 start_date>prev_max 命名 gid; 分区 account_id
t4=汇总 最小 start_date 命名 start_date, 最大 end_date 命名 end_date; 分组 account_id, gid
每一步都是大白话,先排序、再算前面的最大结束日、按条件分段、最后汇总合并。写起来很轻松,过两个月看也能秒懂。
但这个怎么执行?把它交给 SQLazy 编译器,上面的 SQL 就出来了:
同一份逻辑,编译一百次也是同一份 SQL,没概率,没幻觉。
SQLazy 并不能用完全灵活的自然语言,它和 SQL 一样,语句也有一定的规范。但无论如何,不用大模型的文字编程也能写出这么复杂的 SQL 了
如果有大模型配合就会更方便,LLM 可以把口语化的自然语言翻译成符合 SQLazy 规范的文字语句,这样很容易审计了。AI 甚至还能把复杂任务拆解直接写出 SQLazy 的多步语句,然后当场调试确认,最后编译成 SQL,再也不用担心 AI 的幻觉。