
谈智能问数 Text2SQL 的准确率,先要说清分母是什么
智能问数领域,厂商们动不动就喊“准确率 90% 甚至 95%”。听起来很厉害,但你细问一句“在什么范围测的”,往往就没下文了。
就像一个人跟你说“我考试能考 90 分”。你不问问考的是什么、范围是什么、难度如何,就敢信他能帮你解决实际工作问题?
准确率这个数字,离开了“分母”毫无意义。
分母不同,结果天差地别
同样是 90% 的准确率,分母可以是完全不同的东西:
分母 A:一张 BI 大宽表。
所有字段都在一张表里,没有 JOIN,没有子查询。这种条件下跑到 90% 确实不难。但问题是,哪个企业的数据是长在单张表上的?
分母 B:多表 JOIN。
一旦涉及两张表、三张表的关联,准确率就往下掉。有实践数据表明,涉及多表 JOIN 时准确率会锐降到 50%-60%。
分母 C:多层子查询 + 复杂关联。
再来几层子查询,那就更惨不忍睹了。
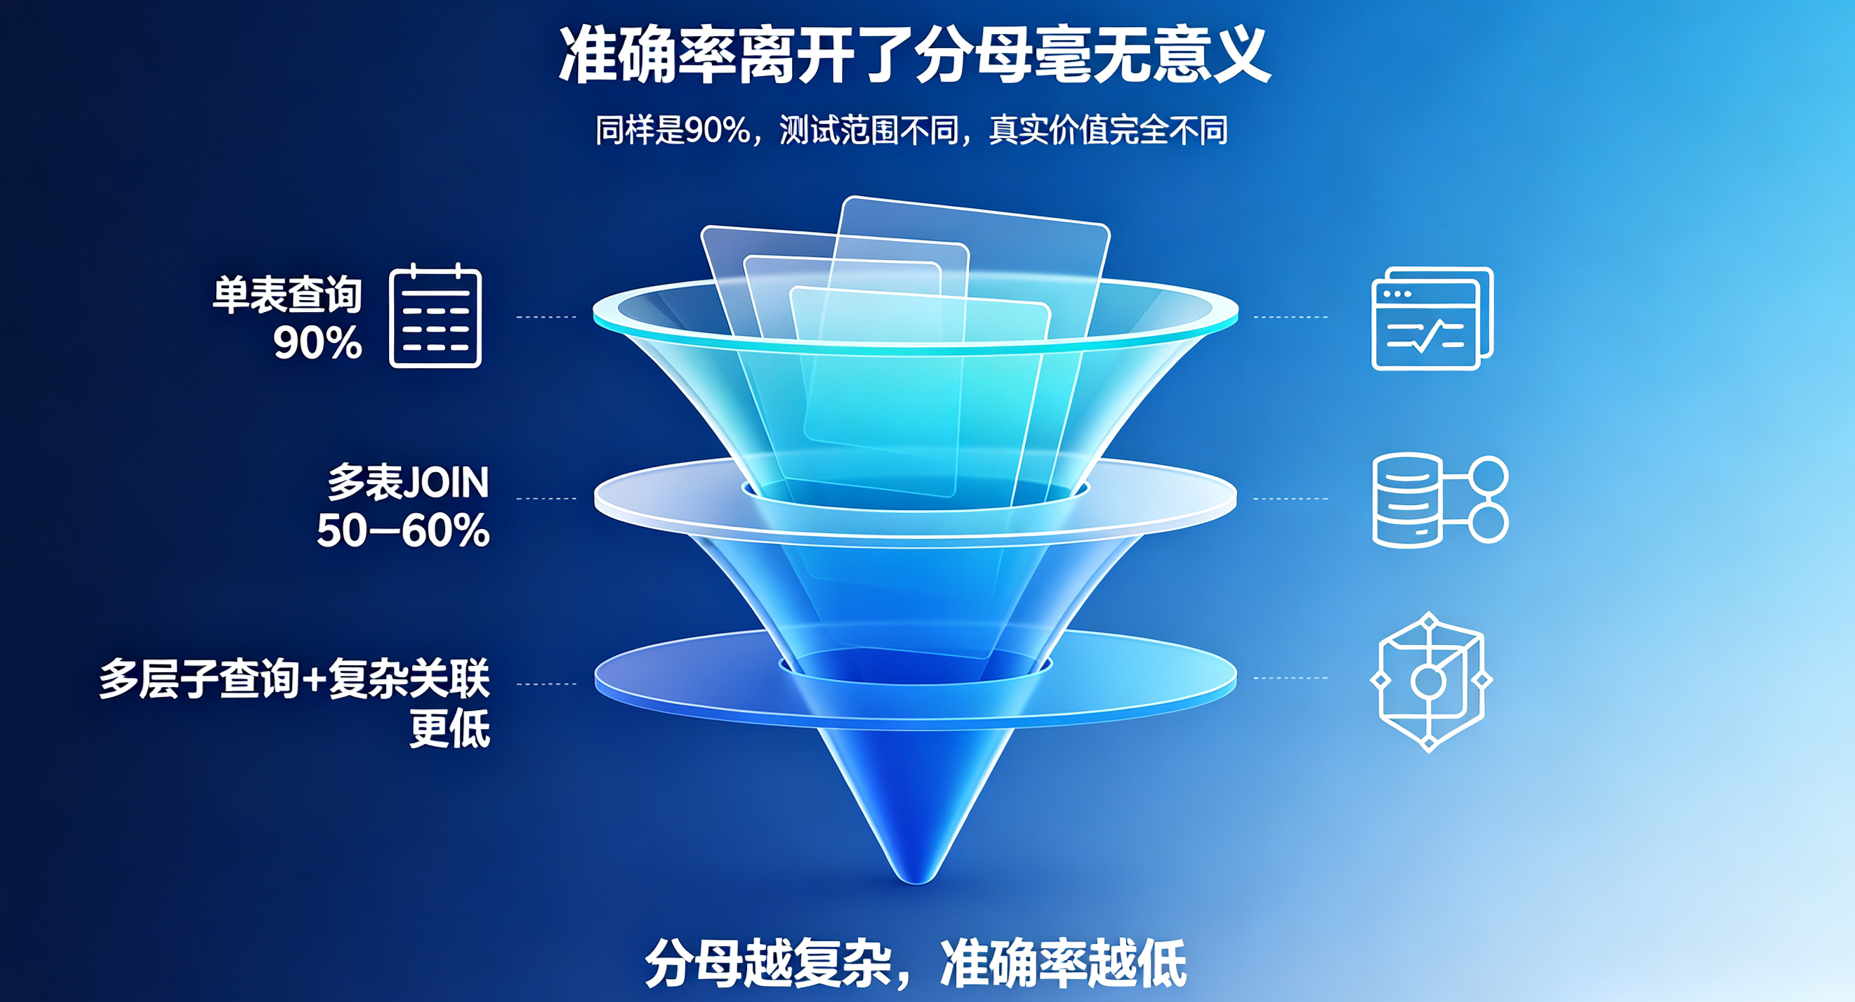
同一个系统,在不同的“分母”下跑出来的准确率天差地别。厂商拿 90% 说事,你得先问一句:分母是什么?是单张大宽表,还是真实的企业多表关联环境?
通用测试没意义,因为可以针对性地准备
另一个问题是:公开测试集是可以“针对性地准备”的。
Spider、WikiSQL 这些公开数据集,表结构固定、提问规范。厂商可以把模型、prompt、规则专门针对这些测试集做优化,测试集里有哪些表、哪些字段、哪些常见问法,都可以提前“喂”给系统。
跑出来的分数很好看,但一上真实业务就露馅。因为真实业务的数据模型是独特的、提问方式是五花八门的,没法提前准备。
通用测试的分数,只能证明“在这个测试集上表现不错”,证明不了“在真实场景能用”。
其实准确率本身也没多大意义
即使锁定了分母、剔除了“应试”水分,准确率这个指标本身仍然有问题。
哪怕测出来是 90%,用户也不知道这一次是不是那 10%。
企业经营决策不是统计学游戏。一个系统 10 次里错 1 次,从统计学角度准确率 90%,但对用户来说,他无法区分哪一次是错的。信错了的那一次,可能就造成了决策损失。
对产品团队而言,“准确率”是一道统计学题目,只要整体平均够高就行,不需要为每一次查询负责。但对业务决策者来说,信任坍塌只需要一次错误结果。
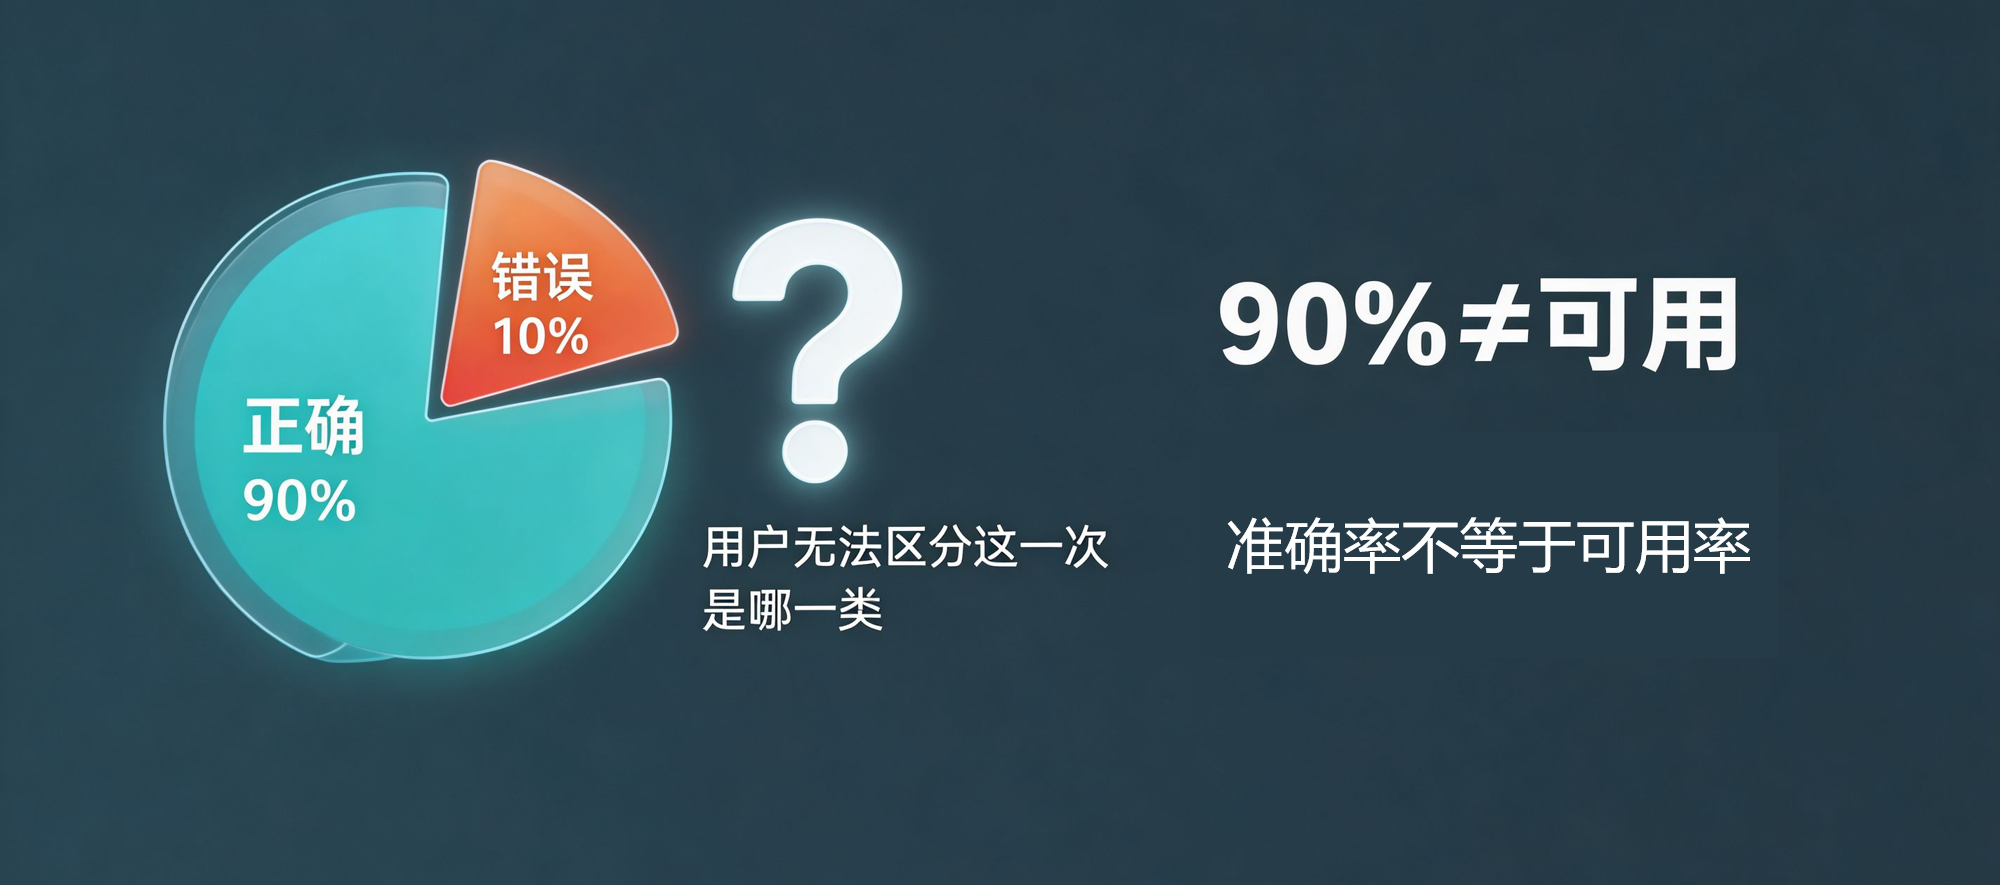
准确率必须是 100% 才算有意义。而且这个 100% 不能靠“运气”,必须有人类确认的环节,把可能的错误在执行前全部拦截,剩下的路径 100% 可靠。
真正该看什么?看“通过率”和“复杂度覆盖”
如果准确率这个数字不靠谱,那该看什么?
看通过率,在真实的企业数据环境里,用户随口问的查询,有多少能被系统正确理解和执行?
这不是一个在固定测试集上跑出来的数字,而是在真实业务场景中、面对真实用户提问时,系统实际能处理的比例。
看复杂度覆盖,系统能处理多复杂的查询?
单表查询能跑通不算本事。能处理多表 JOIN 吗?能处理嵌套子查询吗?能处理按维对齐的跨表汇总吗?能处理排名、占比、环比、同比这些跨行运算吗?
润乾 NLQ:锁定“分母”,不谈准确率
润乾 NLQ 的做法不是“把分母做小”来取巧,而是把分母做得足够大,能覆盖足够复杂的真实场景。
能处理的复杂度有多高?四种查询范式打底:单表明细、单表聚合、主子实体、多维对齐汇总。多表 JOIN、嵌套子查询、跨表按维对齐,这些让大多数 Text2SQL 方案翻车的场景,它都能稳定覆盖。排名、占比、环比、同比这类跨行运算,也全部预置在规则引擎里,用户直接用汉语指令调用,全程不走 AI。
这个“分母”的宽度,决定了通过率的上限。系统能处理的查询越复杂、场景越丰富,分母就越大,通过率的含金量就越高。
通过率还取决于另一个因素:用户说的是口语,不是规范语句。业务人员习惯说“上个月没有签单的客户”,而不是标准化的查询表达。如果系统只认规范表述,通过率照样上不去。所以润乾 NLQ 接上 LLM 来做口语理解,把五花八门的日常问法转化成系统能处理的规范查询。配合 LLM,绝大部分日常问法都能顺利通过。而且这个环节仍然保留人类确认的关口,LLM 只是帮忙“转译”,不参与最终决策,幻觉不会污染结果。
至于准确率,在这里已经失去了意义。
LLM 翻译后的查询意图,会经过用户确认——“对,这就是我想查的”,然后才会进入执行阶段。确认之后,后面的编译路径是确定的、可验证的、可重复的,规则引擎编译,不是概率猜测。
从确认完成到 SQL 执行这一段,准确率是 100%。
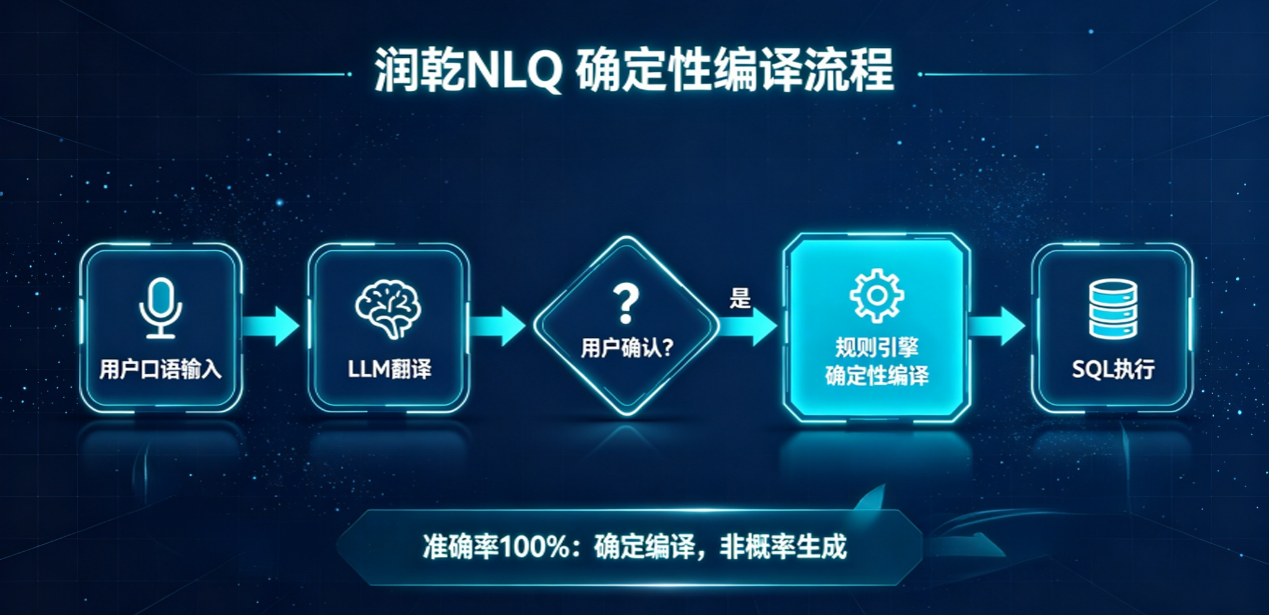
这个 100% 不是跑出来的,是锁出来的。通过人类确认剔除翻译错误,通过规则编译保证执行正确,两条防线把不确定性彻底排除在外。
所以润乾 NLQ 不卷准确率,因为它已经不用卷了。分母够宽,通过的路径是确定的,这才是真实场景里该关心的指标。