
智能问数 Text2SQL 能不能落地,先只看这一条
智能问数火了两三年,各路厂商各显神通。RAG 增强,让大模型更懂业务;微调,让模型更准;建语义层做好数据治理,把字段映射得清清楚楚;接上多智能体协同(Multi-Agent),让多个 AI 各司其职自动规划查询;搞本体化语义层(Ontological Semantic Layer),把业务对象和关系建模成知识图谱;建元数据图谱,自动理解表间关联;用 NL2Metrics,不让大模型生成 SQL,而是匹配预定义指标;搞 Agentic BI,让 AI Agent 接管数据建模、指标计算、可视化全链路,…不一而足;名词一个比一个新,方案也越来越复杂,听起来确实也都很有道理。
但现实是另一回事,90% 以上的智能问数项目最后都是一地鸡毛。问题出在哪?
真正的生死线只有一条:确认环节
RAG、微调、语义层、Multi-Agent、本体化语义层、元数据图谱、NL2Metrics、Agentic BI……这些听起来都很专业,也都很重要。
但这些都是“加分项”,不是“生死线”。
真正的生死线只有一个:用户在查询执行之前,能不能看懂系统理解的结果、能不能确认“这就是我要问的”?
智能问数的用户不是工程师,看不懂 SQL。无论中间用了 RAG、微调、语义层还是 Agent,只要最终输出的是一段 SQL、或者等价的 JSON 等中间格式,对用户来说都一样:看不懂,没法确认。
没有这一层,RAG 再准、语义层再全、Agent 再聪明,全都没用。因为你永远不知道下一次它会不会翻车。对企业分析决策而言,信任坍塌只需要一次错误结果。
这一条不过关时,其它再多技术都是白搭。
确认层长什么样?
用户能读懂的中间表示,让用户自己确认意图,需要两个条件:
一、人类可读。用接近自然语言的形式,不用技术培训就能看懂。是“去年上半年签单客户”,不是 JSON、XML 或 SQL。
二、机器可解析。遵循一定的结构化规范,能确定性转换成 SQL。
一个关键的原则是:确认文本不能倒过来由 AI 根据计算逻辑生成。
容易想到的一个方案:用 AI 生成了计算逻辑(SQL,或等价的 JSON 等中间格式)后,再继续用 AI 根据计算逻辑解读成确认文本呈现给用户。这看起来有了确认环节,但并没有实质意义。因为,AI 的幻觉可能出在生成环节,也可能出在解读环节,仍然不能确保看到的确认文本和最后执行的计算逻辑是一致的。
确认文本和计算逻辑之间的关系必须是确定的、可验证的,不能依赖概率模型。
确认之后,不再指望 AI
有了确认环节,用户确认“这就是我要查的”,这时候系统才拿到一个确定的“查询意图”。从这一刻开始,后续的所有步骤都不能再依赖 AI,否则幻觉只是换了个位置。
如果用户确认完了,后面还要靠 AI 去“猜”SQL、去“推”关联路径,那确认环节就白做了。确认的唯一价值,是锁定了确定的输入,然后必须用确定的编译走完后半程。
润乾 NLQ(智能问数)的核心设计就是围绕“确认层”展开的。用户口语进来,系统先通过 LLM(或用户自己)转成“规范文本”,一种人机双向可读的自然语言表达,比如“去年上半年签单客户”。用户看一眼,确认“对,这就是我想查的”,点一下执行。
确认之后,后面的路全是确定性的:规范文本通过规则引擎编译成 SQL。每一步都是规则驱动的、可追溯的、可调试的,没有再碰 AI。
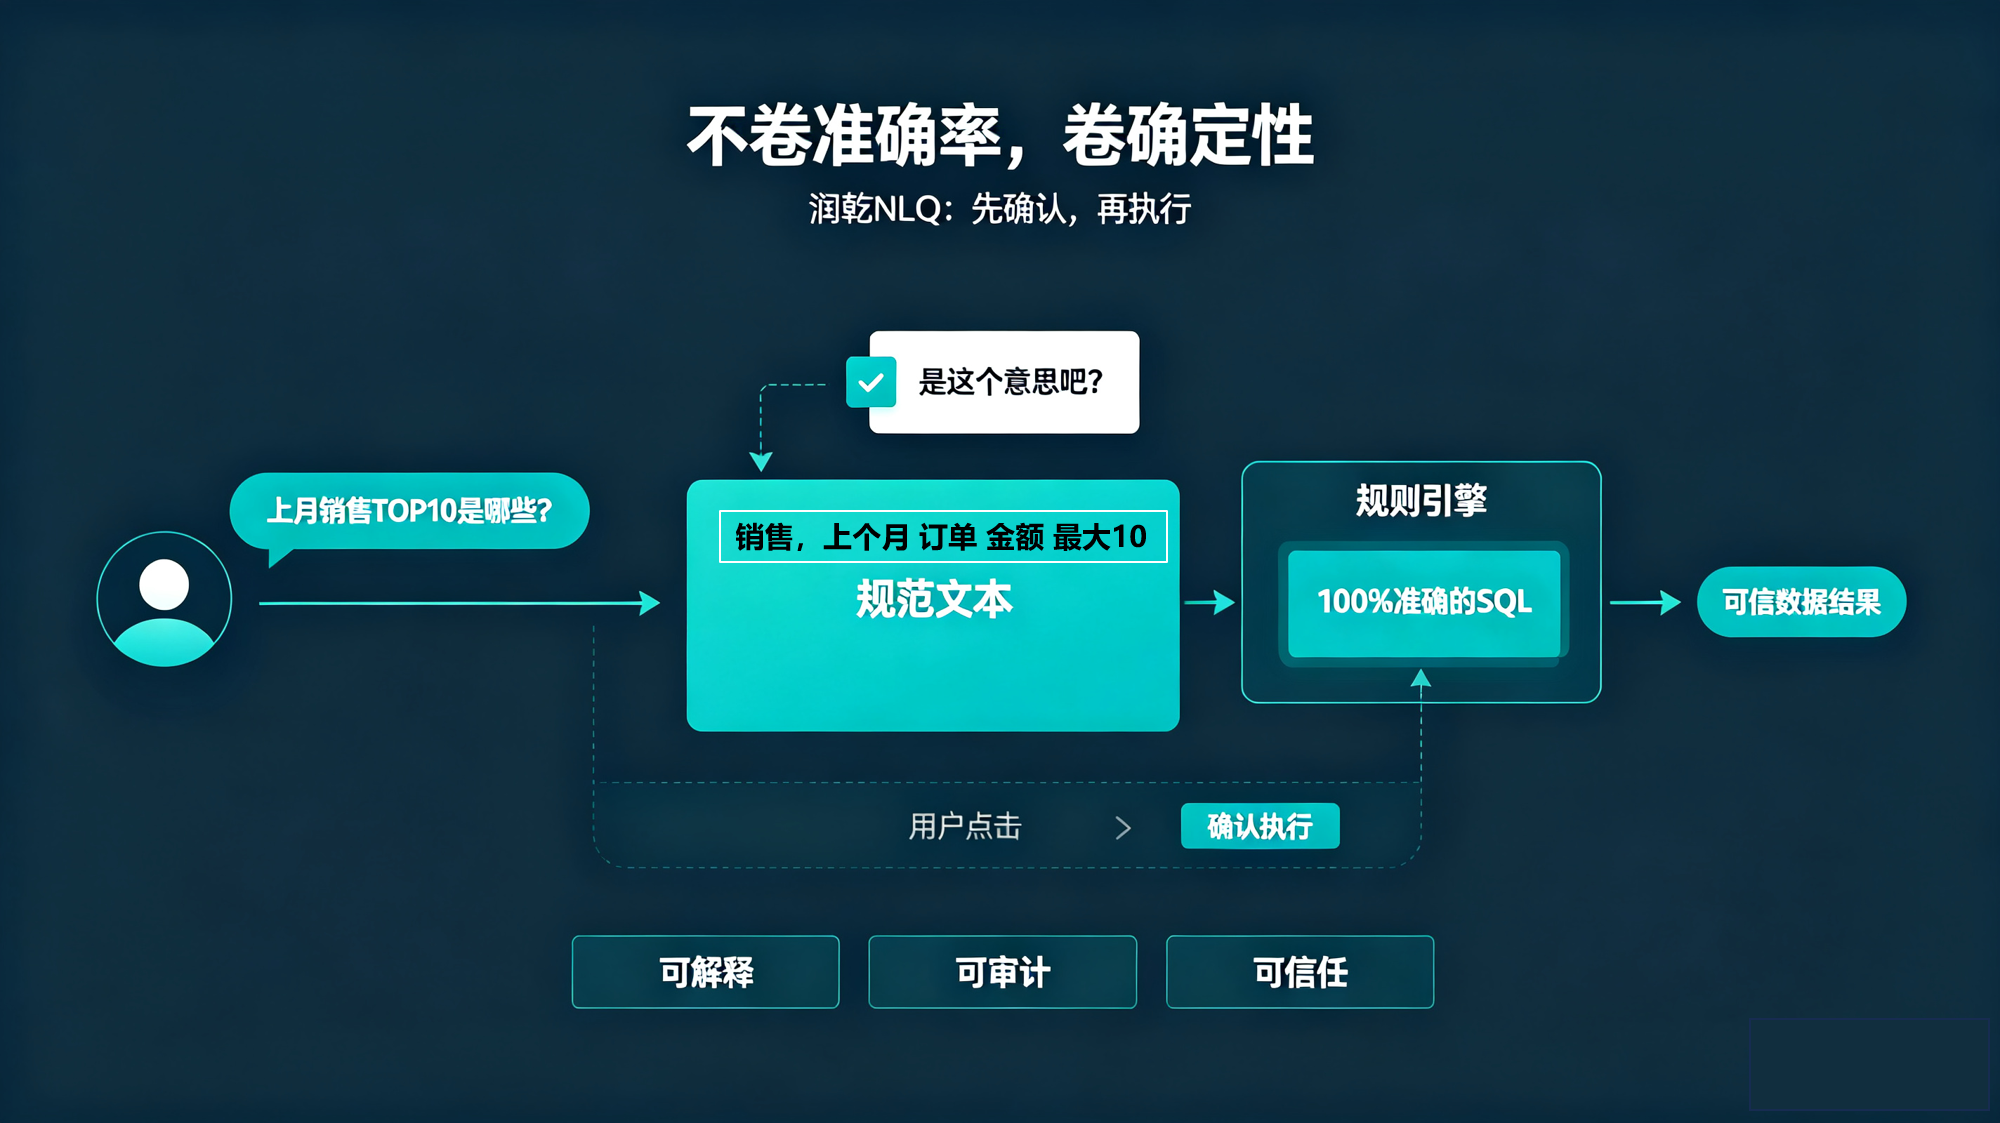
(不卷准确率,是因为不需要卷,经过确认后的准确率 100%)
确认环节过关了,证明方案“能用”了。这时候再去评价其他能力才有意义。
比如复杂计算,排名、占比、环比、同比这些跨行运算,润乾 NLQ 用规则引擎直接搞定,全程不走 AI。
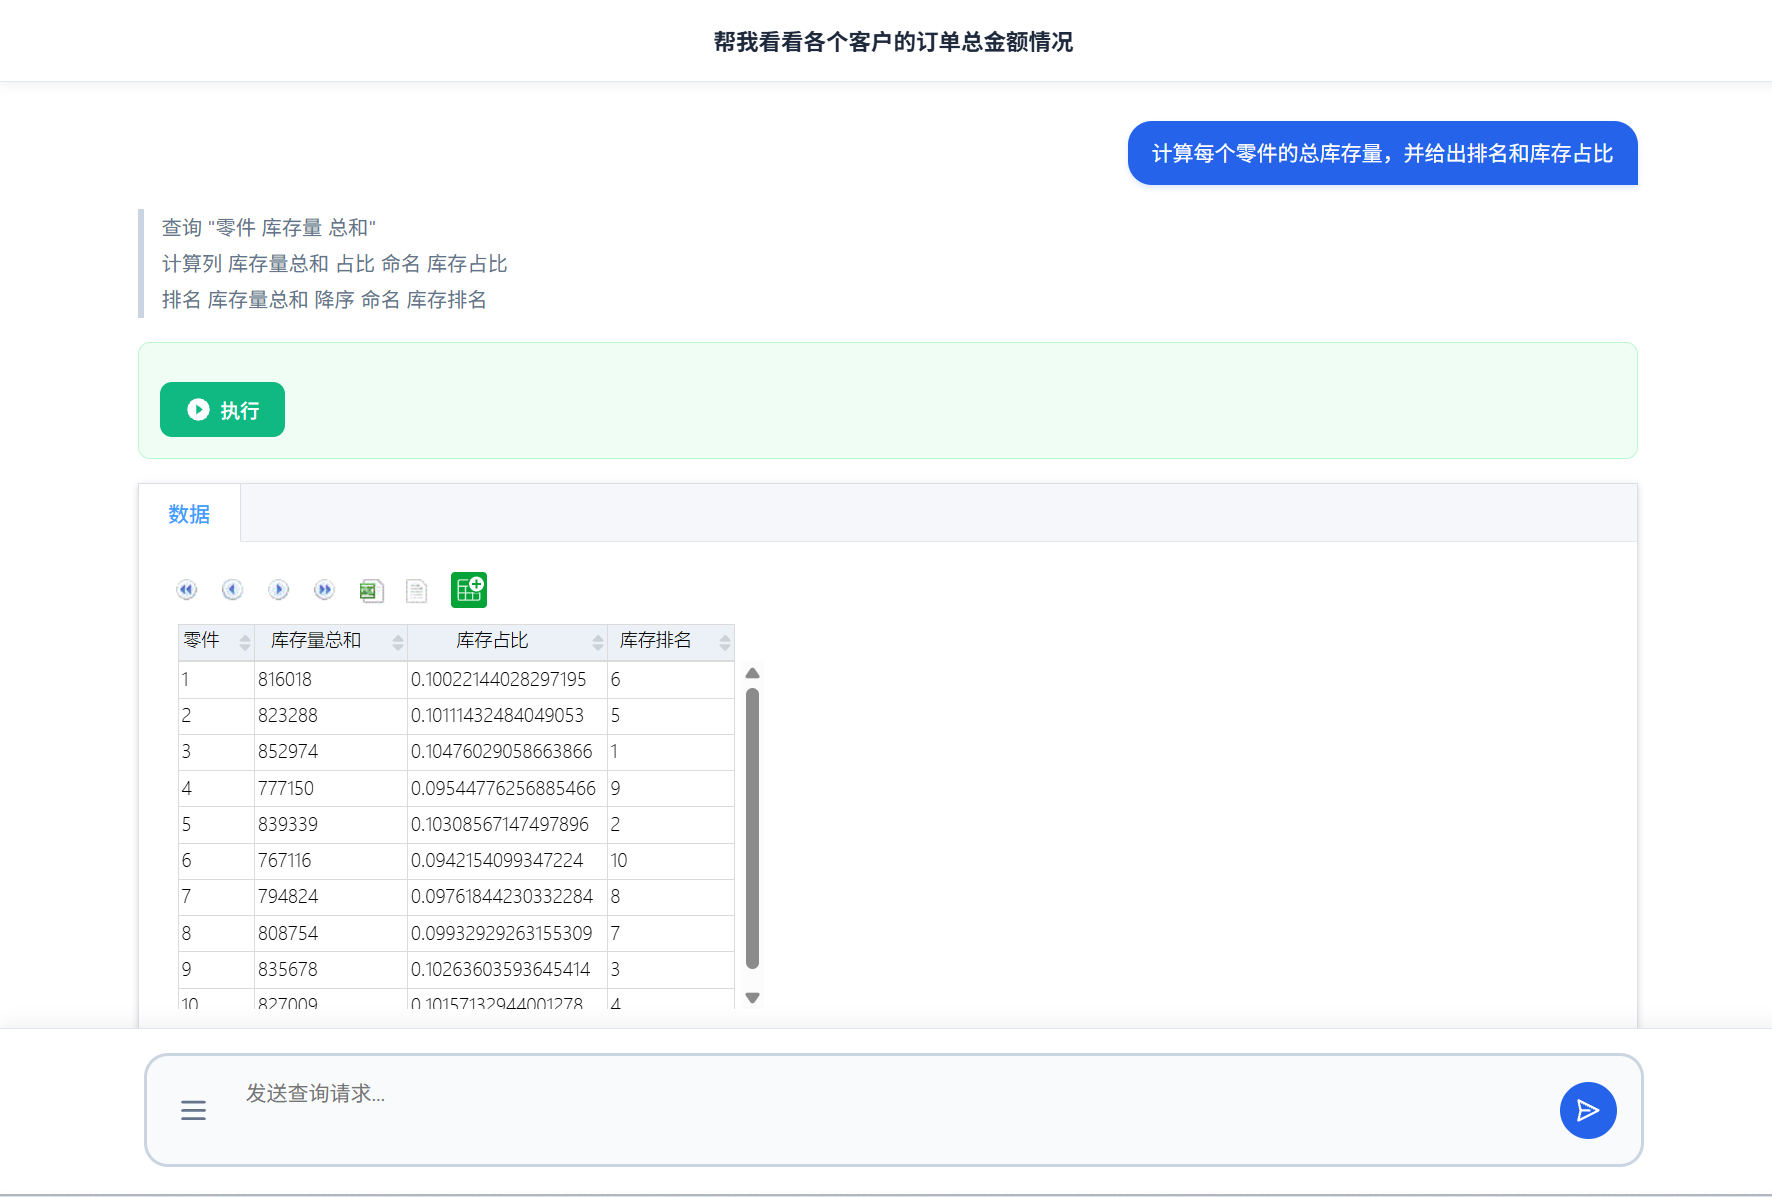
再比如实施成本,NLQ 不需要 GPU、不需要 AI 专家团队,数据库工程师构建词典即可部署,可跟踪可改进。而依赖微调和 RAG 的方案,需要专人长期维护,成本完全不是一个量级。
这些都管用也都有意义,但仍然是确认环节过关之后才值得讨论的事。
智能问数能不能在严肃场景落地,记住一条判定规则:
先看有没有“人类可读、可确认”的确认环节。没有,直接淘汰。
过了这一关,再谈通过率、语义层、复杂计算、实施成本,这时候聊这些才有意义。
能确认,就能用。不能确认,就是玩具。