
本地数据分析,DuckDB 还是 esProc SPL?
DuckDB 可以直接读取 CSV、Parquet、JSON 等常见文件,只用一句 SQL 就能完成文件加载和查询,例如SELECT * FROM 'data.csv' WHERE price>100。对于习惯 SQL 的用户而言,这种 "文件即表" 的操作体验非常友好,简单过滤、聚合计算都能快速实现。
但当遇到复杂场景时,例如需要跨文件迭代计算、处理非结构化日志、实现动态条件分支时,单纯用 SQL 往往力不从心。这时候不得不借助 Python 编写循环或 UDF 函数。混合编程模式带来明显的割裂感:在 SQL 逻辑思维和 Python 过程思维之间反复切换,调试时需要分别处理 SQL 片段和 Python 变量,很麻烦。
用 esProc SPL 就好得多了,支持 CSV/Excel 等 20+ 种文件,也能解析 Restful、NoSQL 等半结构化数据,数据源支持比 DuckDB 更丰富。esProc 同时有 SQL 和 SPL 两种语法,简单情况用 SQL 查,复杂情况用 SPL,同一界面内所有任务全搞定。
例如计算股票连续上涨天数时,SPL 能轻松实现有序分组,可以和 SQL 结合实现:
A |
|
1 |
$select * from stock.csv order by trade_date |
2 |
=A1.group@i(close_price<close_price[-1]) |
3 |
=A2.max(~.len()) |
这种基于序号的简洁语法,比 SQL 的多层嵌套子查询更直观易懂。
配合 IDE 环境,开发者能实时查看每步运算结果,交互性更强,调试效率远超 DuckDB,比 Python 的 IDE 也更直观。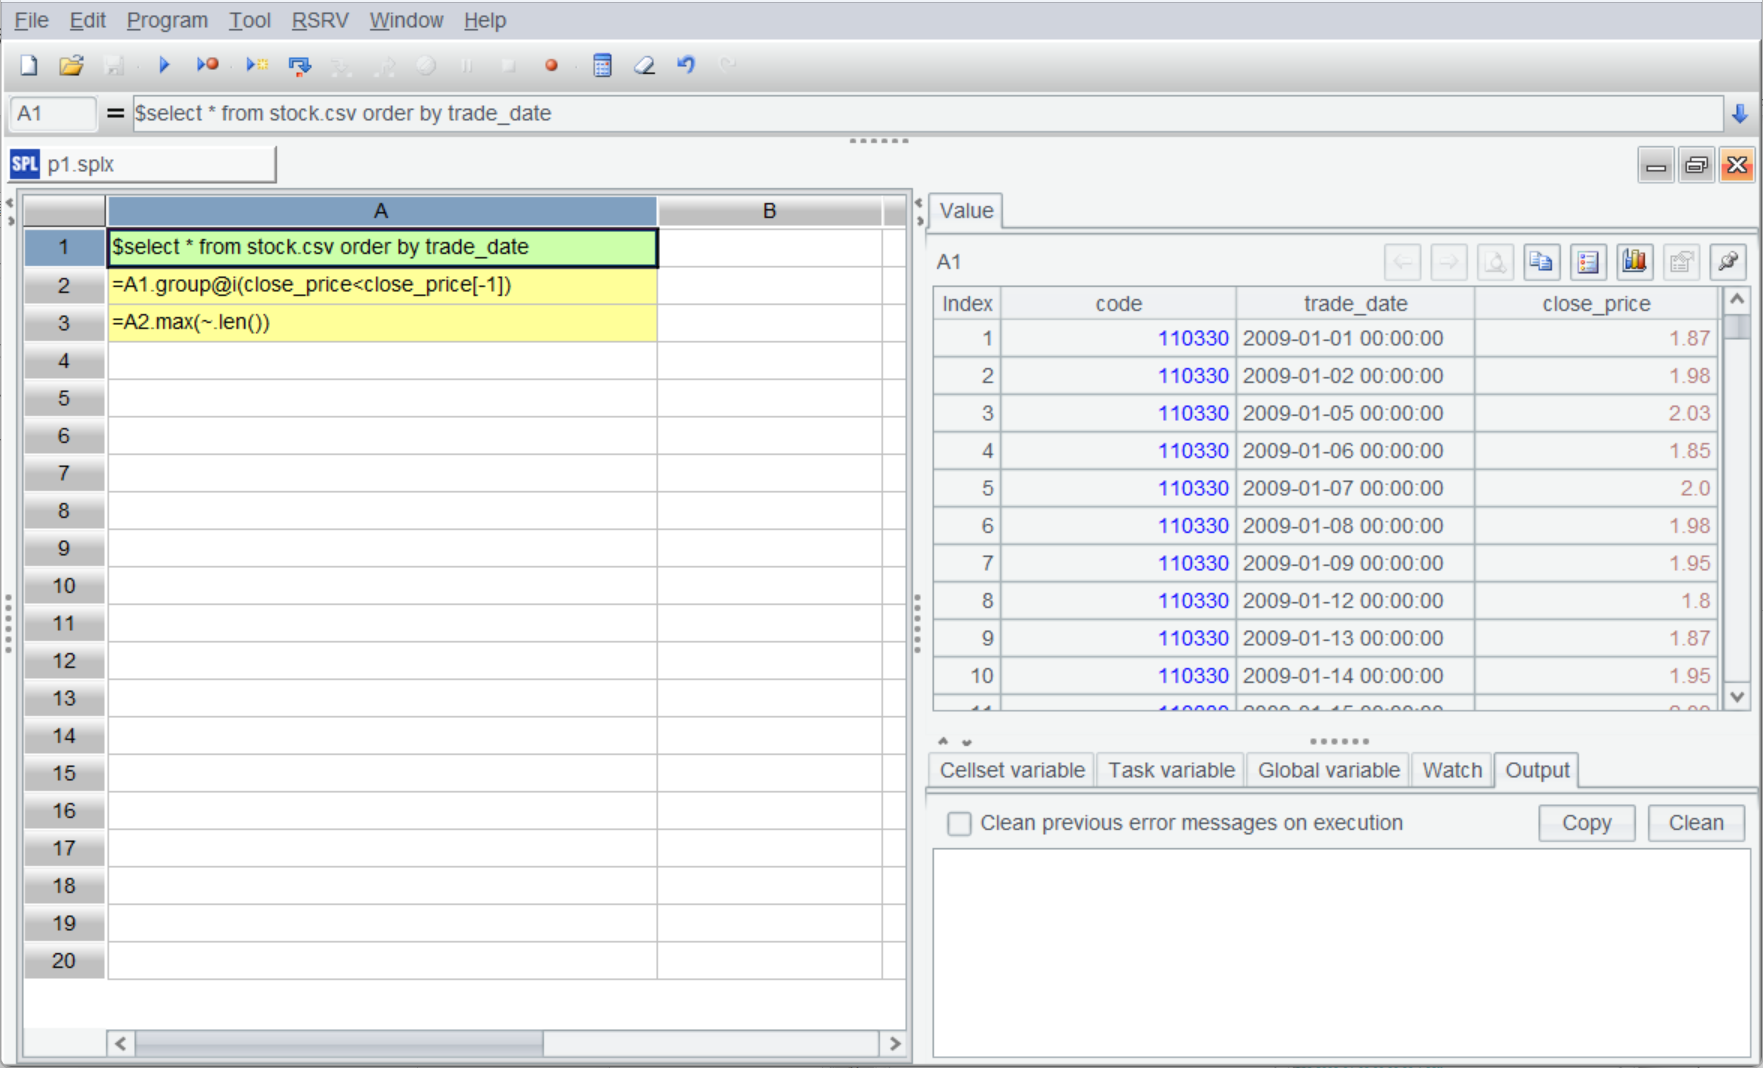
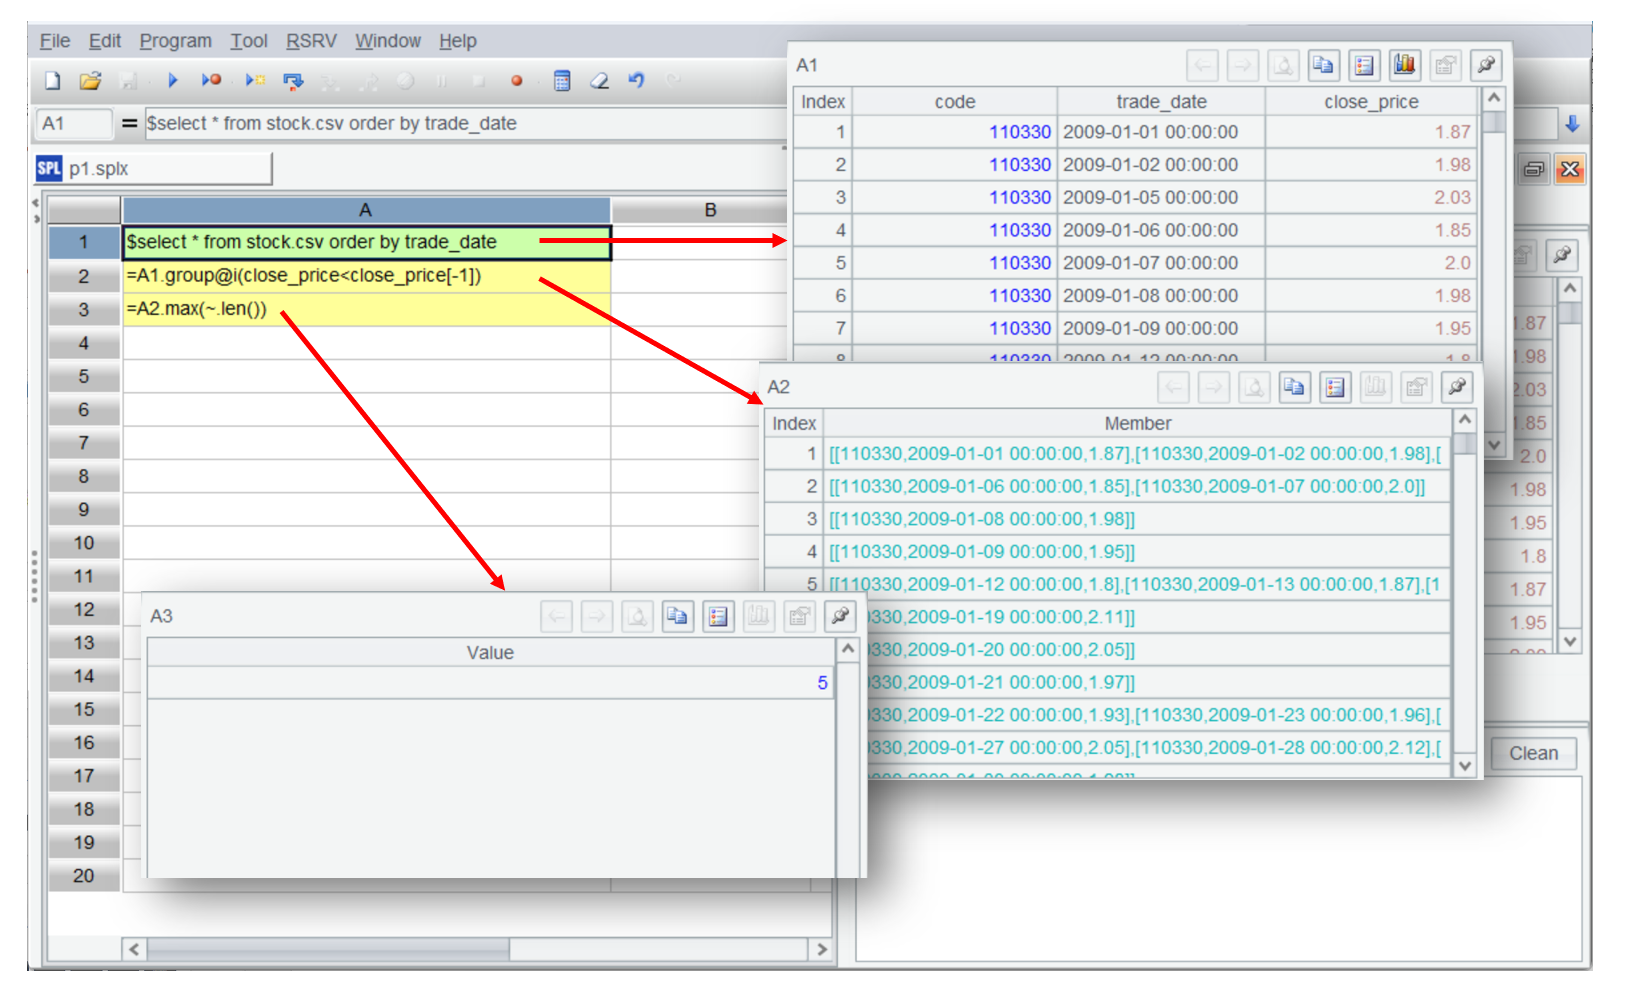
有了数据源和过程计算的支持,SPL 可以完整覆盖了从数据加载到结果输出的全流程。像电商用户行为分析时:读取 JSON 日志→关联 CSV 商品表→计算页面停留时长→生成漏斗结果,整个过程无需切换界面,单脚本即可完成。
如果数据量比较大,SPL 还能用游标和并行计算来应对。测试显示,对 100GB 的 CSV 文件进行分组聚合时,SPL 采用多线程分段加载技术,速度比 DuckDB 快 3 倍以上。
DuckDB 适合简单的 SQL 文件查询场景,面对复杂计算或大数据量时,用 esProc SPL 更合适。一个体系既能有 SQL 的简洁性,又具备超越 Python 的过程计算能力,还有交互性更好的 IDE,一个工具走天下。
英文版